
این مطلب بخش دهم و پایانی مجموعه دهقسمتی حاکمیت هوش مصنوعی در یک شرکت توسعه نرمافزار AI-Native است.
بلوغ حاکمیت را بهراحتی میتوان بیش از واقعیت برآورد کرد، چون سند و کمیته از رفتار واقعی سیستم قابلمشاهدهترند. داشتن سیاست، رجیستری یا فرایند بازبینی مفید است، اما هیچکدام بهتنهایی ثابت نمیکند که یک عامل در شرایط واقعی محدود، متوقف، قابلردیابی یا قابلبازیابی است.
معیار عملی سادهتر است: Runtime بدون توضیح تیم چه چیزی را میتواند ثابت کند؟
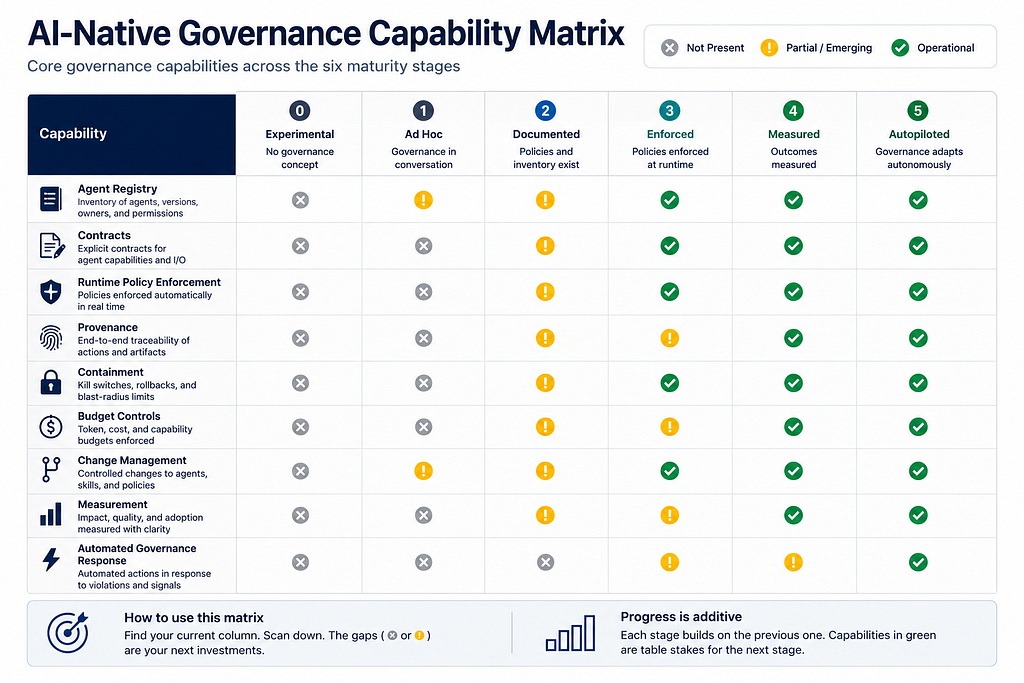
این مدل شش مرحله دارد و هر مرحله با شواهد عملیاتی تعریف میشود، نه با چیزی که سازمان آرزو دارد داشته باشد.
مرحله ۰: آزمایشی
عاملها استفاده میشوند، اما حاکمیت هنوز بهعنوان یک مسئله سازمانی شناخته نشده است.
ابزارها با انتخاب فردی توسعهدهندگان گسترش پیدا میکنند. فهرست قابلاعتمادی از عاملها وجود ندارد، مالک مشخصی نیست و برای پرسشهایی مثل دسترسی به داده تولید یا مسئولیت تغییر ایجادشده توسط عامل پاسخ مشترکی وجود ندارد.
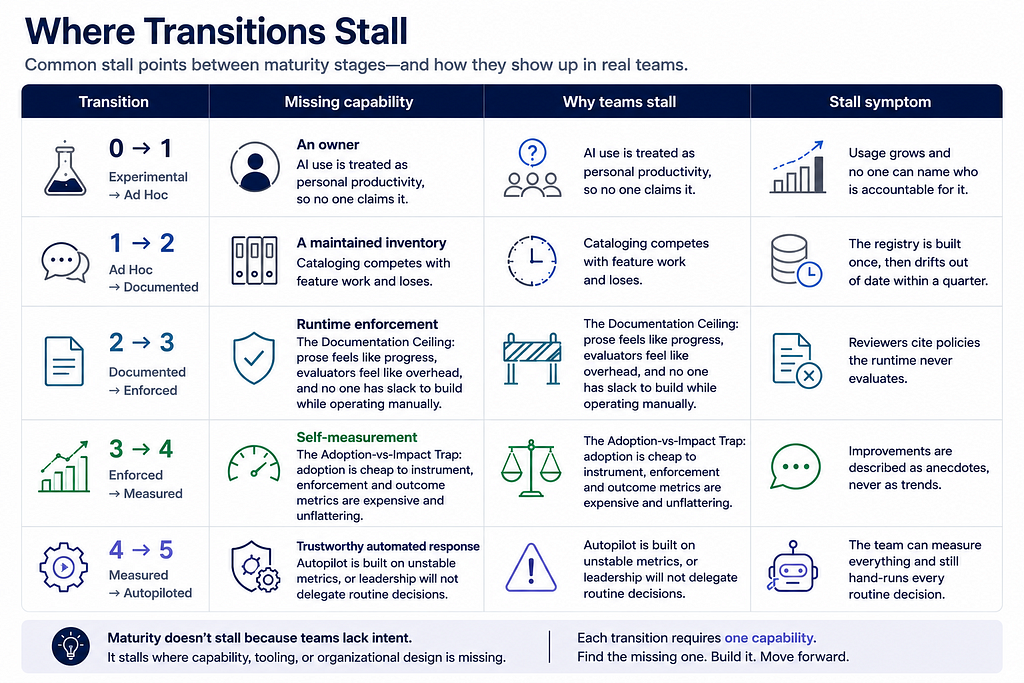
عبور به مرحله ۱ بیشتر یک تغییر سازمانی است: کسی باید مسئله را نامگذاری کند، مالک آن شود و استفاده از AI را قابلمشاهده کند.
مرحله ۱: موردی
حاکمیت در گفتگو وجود دارد، نه در سیستم.
بخشی از قوانین در پیامها، کامنتهای بازبینی و صفحات داخلی پراکنده است. تصمیمها به افرادی وابستهاند که در لحظه حضور دارند. ممکن است سازمان یک حادثه را خوب مدیریت کند، اما نمیتواند همان تصمیم را با اطمینان در تیمهای مختلف تکرار کند.
گام بعدی تبدیل دانش ضمنی به رجیستری و سیاست عملیاتی صریح است.
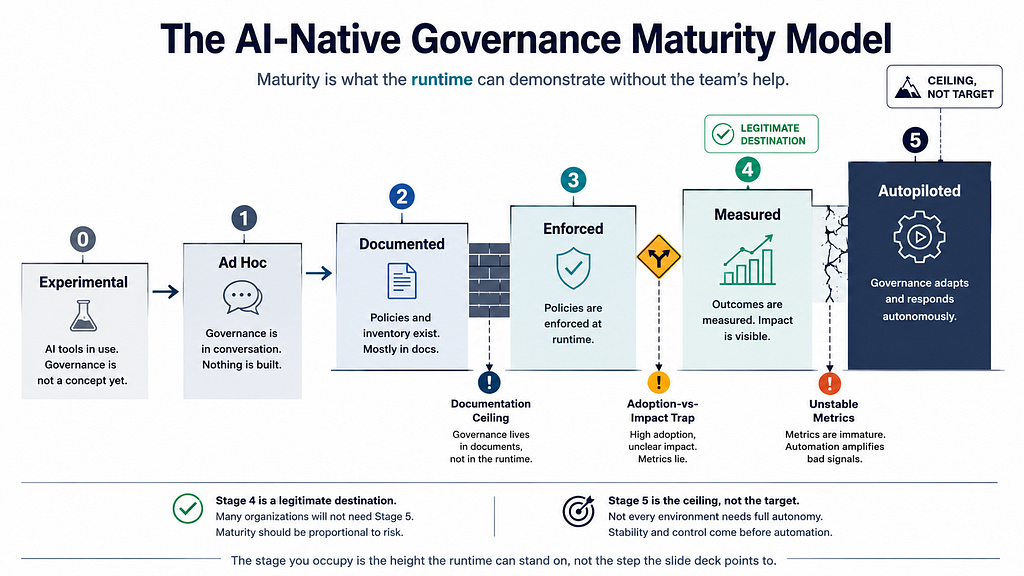
مرحله ۲: مستند
سازمان میتواند بگوید چه عاملها، Skillها و Toolهایی دارد و چه انتظاری از آنها دارد.
سیاستها نوشته، مالکدار و نسخهبندی شدهاند. تیمها برای دسترسی داده، تأییدها، مدیریت تغییر و استفاده مجاز استاندارد دارند.
اما این مرحله همان جایی است که «سقف مستندسازی» شکل میگیرد: اسناد بالغتر میشوند، درحالیکه Runtime هنوز همان رفتار قبلی را دارد.
برای رسیدن به مرحله ۳، سیاست باید به Artifact قابلارزیابی توسط ماشین تبدیل شود و در نقاطی اجرا شود که واقعاً میتوان رفتار را تغییر داد.
مرحله ۳: اعمالشده
سیاست بخشی از اجراست.
قراردادها و Artifactهای سیاست نسخهبندی میشوند. در authoring، CI، deployment و runtime گیت واقعی وجود دارد. اقدامهای حساس میتوانند رد یا escalate شوند. Stop، Scope و Recovery فقط متن Runbook نیستند و عملاً تمرین میشوند. تغییرهای مهم از نیت اولیه تا اثر در Production قابلردیابیاند.
از اینجا سؤال عوض میشود: نه «آیا کنترل داریم؟» بلکه «آیا کنترلها درست کار میکنند؟»
مرحله ۴: اندازهگیریشده
خود سیستم حاکمیت قابلمشاهده و قابلاندازهگیری است.
تیم فقط تعداد عاملها را نمیشمارد. نرخ Block، False Block، False Allow، عمر Exception، زمان Containment، Attribution حادثه و هزینه اقدام حاکمیتشده اندازهگیری میشوند.
یک سؤال Audit باید در فصل بعد هم با همان نوع Evidence پاسخ داده شود، نه با یک بازسازی دستی تازه.
مرحله ۴ میتواند مقصد نهایی کاملاً معقولی باشد. اگر Fleet پایدار و Blast Radius محدود است، تصمیم انسانی بر اساس اندازهگیری معتبر ممکن است بهتر از Autopilot باشد.
مرحله ۵: خودکار
تصمیمهای روتین حاکمیت بهصورت خودکار و بر اساس Artifactهای امضاشده و نسخهبندیشده انجام میشوند. انسان روی Exception، ریسک جدید و تغییر سیاست تمرکز میکند.
عامل جدید با Deployment کنترلها را به ارث میبرد، نه با حافظه افراد. Exceptionها تاریخ انقضا دارند. Drift میتواند پاسخ ازپیشتعریفشده فعال کند و ظرفیت تیم حاکمیت لازم نیست همزمان با تعداد عاملها رشد کند.
مرحله ۶ با عنوان «بدون انسان» هدف معناداری نیست. Autopilot محل دخالت انسان را تغییر میدهد، نه مسئولیت انسانی را.
سقف مستندسازی و تورم مرحله
خطای رایج این است که بلوغ را با فعالیت قابلمشاهده بسنجیم.
ممکن است تیم اسناد عالی داشته باشد و همچنان در مرحله ۲ باشد، چون تخلف سیاست واقعاً Block نمیشود. ممکن است Dashboard داشته باشد و هنوز مرحله ۴ نباشد، چون فقط Adoption را نشان میدهد.
قاعده سختگیرانه بهتر است: مرحله واقعی شما بالاترین مرحلهای است که قابلیتهای حیاتی آن را میتوانید از ابتدا تا انتها در Runtime نشان دهید.
یک کنترل مفقود در مسیر پرریسک مهمتر از چند کنترل تمیز در مسیر کمریسک است.
بلوغ باید متناسب با ریسک باشد
مرحله ۵ مقصد همه سازمانها نیست.
سطح لازم به Blast Radius بستگی دارد. یک دستیار داخلی که به داده حساس یا Production دسترسی ندارد، به عمق کنترلی یک عامل مالی یا عامل دارای دسترسی به سامانه مشتری نیاز ندارد.
پس سؤال برنامهریزی بهتر این است:
کمترین مرحله بلوغی که این ریسک مشخص را قابلدفاع نگه میدارد چیست؟
حاکمیت بیشازحد برای سطح کمریسک، ظرفیت مهندسی را هدر میدهد. حاکمیت ناکافی برای سطح پرریسک، Exposure ایجاد میکند.
Adoption، Enforcement و Outcome را با هم اندازه بگیرید
سه لایه Metric لازم است.
Adoption نشان میدهد برنامه تا کجا رسیده است: عامل ثبتشده، تیم onboard شده، Skill منتشرشده و پوشش سیاست.
Enforcement نشان میدهد کنترل اجرا میشود یا نه: Policy Evaluation، نرخ Block، False Block و False Allow، انقضای Exception و زمان Containment.
Outcome نشان میدهد ریسک عملیاتی واقعاً تغییر کرده یا نه: نرخ و شدت حادثه، زمان پاسخ به سؤال Audit، هزینه هر اقدام حاکمیتشده، الگوهای تکراری Postmortem و زمان بین تغییر عامل تا اثر Production با Provenance کامل.
Adoption بدون Enforcement مستندسازی است. Enforcement بدون Outcome فرایند است. هر سه با هم تصویر واقعی میدهند.
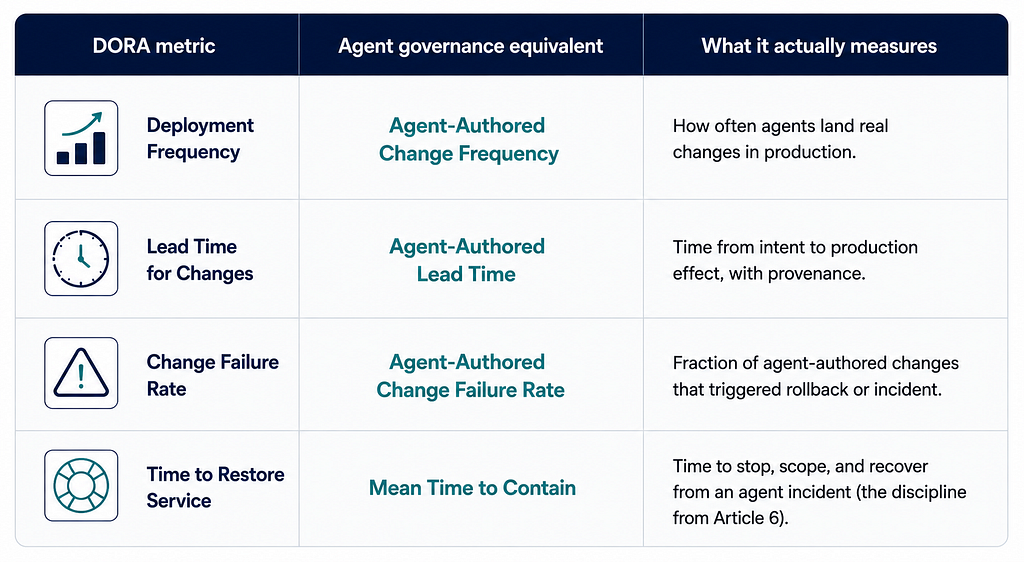
انضباطی شبیه DORA برای عاملها
در مهندسی نرمافزار، خواندن Throughput در کنار Stability باعث شد Metricها کمتر گمراهکننده شوند. برای Agentها هم همین منطق لازم است.
افزایش تغییرهای Agent-authored بدون دیدن Failure و Recovery موفقیت نیست. سریعتر شدن اجرا وقتی Provenance، Containment یا Policy Compliance افت کرده، بلوغ نیست.
Throughput بدون Stability یعنی ریسک سریعتر حرکت میکند.
Runtime Verification Probe
پرسشنامهها خودارزیابی خوشبینانه را تقویت میکنند. Probe از Runtime مدرک میخواهد.
- Provenance Probe: یک تغییر اخیر Production را تا Agent، Model، Policy Version و نیت تأییدکننده دنبال کنید.
- Containment Probe: یک عامل واقعی را در محیط امن Stop کنید و ثابت کنید توقف در محدوده زمانی مورد انتظار رخ داده است.
- Calibration Probe: روند اخیر False Block و False Allow را برای هر سیاست نشان دهید.
- Honesty Probe: یک Metric ناخوشایند حاکمیت و اقدامی که بهخاطر آن انجام شد نشان دهید.
- Autopilot Probe: یک تصمیم روتین حاکمیت را نشان دهید که این هفته بدون دخالت انسان و با Evidence انجام شده است.
اگر ادعای یک مرحله از Probe متناظر عبور نمیکند، آن مرحله هنوز هدف است، نه قابلیت واقعی.
دوشنبه چه کار کنیم؟
این مدل را قبل از استفاده به یک برنامه تحول بزرگ تبدیل نکنید.
- Probeها را اجرا کنید و مرحلهای را انتخاب کنید که Runtime واقعاً ثابت میکند.
- پرریسکترین قابلیت مفقود در همان مرحله را مشخص کنید.
- یک کنترل مشخص برای بستن Gap انتخاب کنید.
- یک Owner، Deadline و Artifact قابلنمایش تعریف کنید.
- یک Metric از نوع Enforcement یا Outcome انتخاب کنید.
- Probe مرحله بعد را در پایان چرخه دوباره اجرا کنید.
هدف بالا رفتن در نردبان نیست. هدف این است که تصمیم بعدی حاکمیت شواهد بیشتر، تکرارپذیری بیشتر و قابلیت دفاع بیشتری داشته باشد.
جمعبندی مجموعه
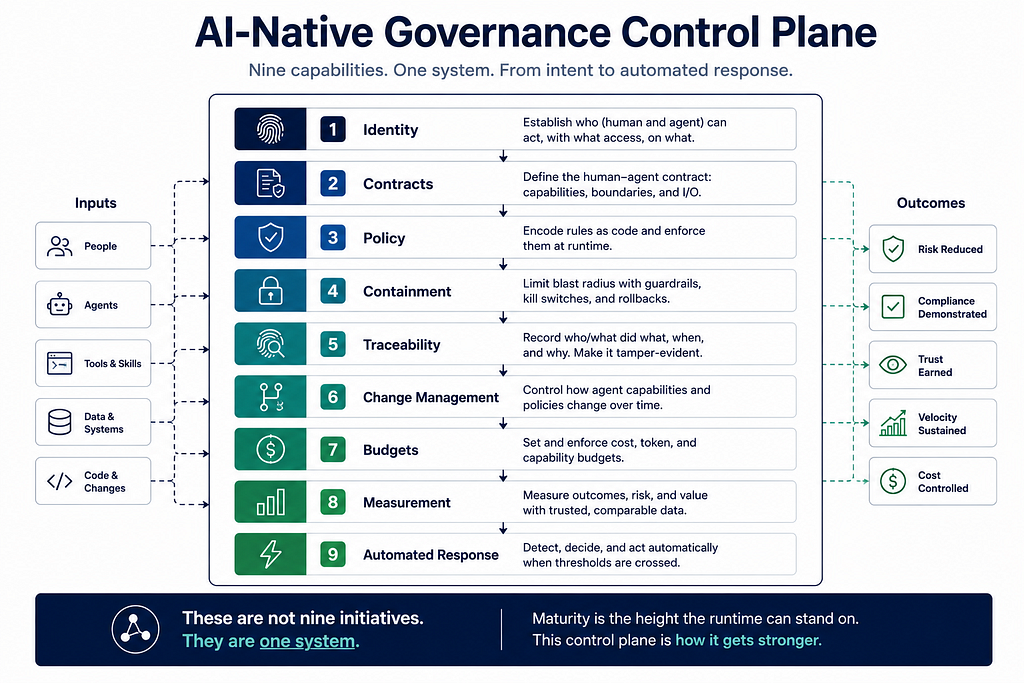
در ده مقاله، معماری یک خط مشترک دارد.
Identity مشخص میکند چه چیزی عمل میکند. Contract حدود اختیار را تعریف میکند. Executable Policy نیت را به تصمیم Runtime تبدیل میکند. Containment دامنه خسارت را محدود میکند. Traceability نیت را به اثر وصل میکند. Change Management تغییر قابلیت را مانند تغییر Production مدیریت میکند. Budget هزینه، Token، Capability و Time را محدود میکند. Measurement نشان میدهد کل سیستم کار میکند یا نه.
و سؤال نهایی بلوغ این است: امروز Runtime چه مقدار از این معماری را میتواند ثابت کند؟
کنترلی که نتوان آن را نشان داد، دیر یا زود دوباره به سند تبدیل میشود. سازمان AI-Native بالغ مرتب Runtime را مجبور میکند ثابت کند کنترلهایش هنوز واقعیاند.
این مقاله ابتدا در ژوئن ۲۰۲۶ توسط Reza Arani در Medium منتشر شد و برای Aipolix بهعنوان بخش ۱۰ مجموعه AI Governance in an AI-Native Software Development Company اقتباس شده است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.
ثبت دیدگاه