
Cet article est la dixième et dernière partie de la série AI Governance in an AI-Native Software Development Company.
La maturité de la gouvernance est facile à surestimer, car les documents sont plus visibles que le comportement réel du système. Une politique, un comité, un registre ou un processus de revue peuvent être utiles, mais ils ne prouvent pas qu’un agent sera réellement limité, arrêté, attribué ou récupéré lorsque le système est sous pression.
Le test le plus utile est donc simple : que peut démontrer le runtime sans que l’équipe doive expliquer ce qu’elle avait l’intention de faire ?
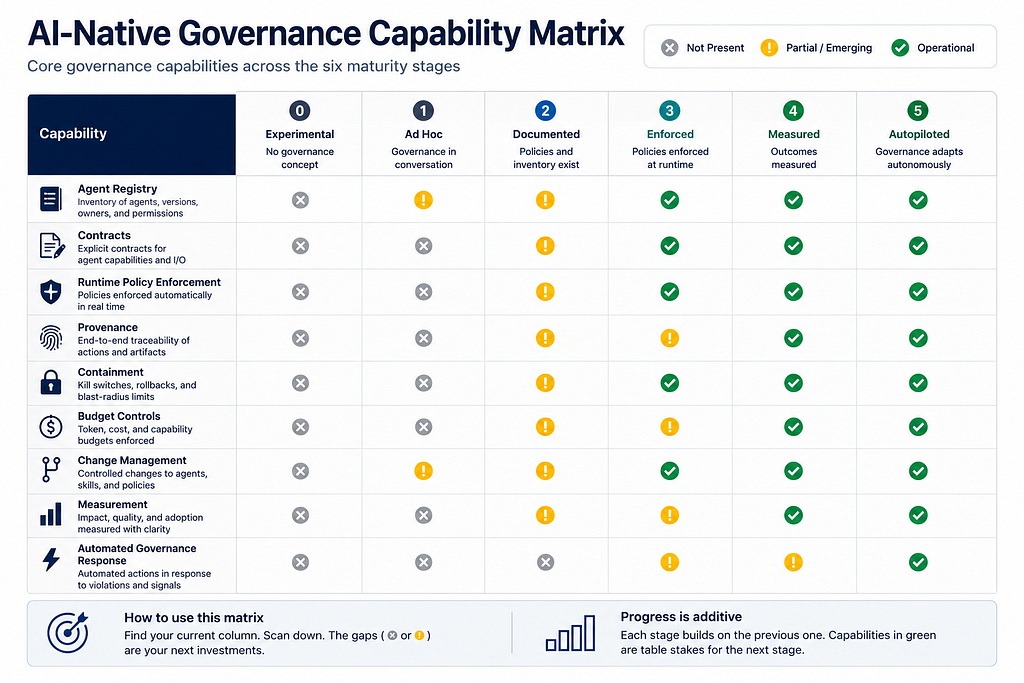
Le modèle comporte six étapes, de l’expérimentation à l’autopilotage. Chaque étape est définie par des preuves opérationnelles.
Étape 0 : Expérimental
Les agents sont déjà utilisés, mais la gouvernance n’est pas encore considérée comme un problème organisationnel.
Les outils se diffusent par adoption individuelle. Il n’existe ni inventaire fiable, ni propriétaire clair, ni réponse commune à des questions élémentaires comme l’accès aux données de production ou la responsabilité d’un changement produit par un agent.
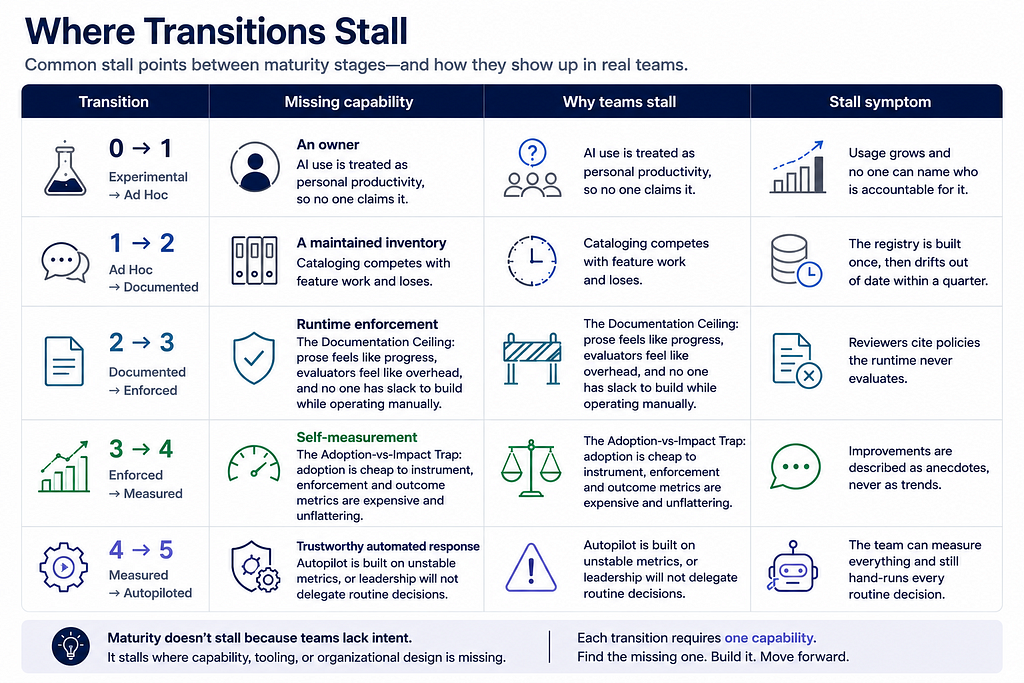
Passer à l’étape 1 consiste surtout à nommer le problème, lui donner un propriétaire et rendre l’usage de l’IA visible.
Étape 1 : Ad hoc
La gouvernance existe dans les conversations, pas dans le système.
Les règles sont réparties entre messages, commentaires de revue et pages internes. Les décisions dépendent des personnes présentes. L’organisation peut bien gérer un incident isolé sans être capable de reproduire la même décision dans plusieurs équipes.
L’étape suivante consiste à transformer ce savoir implicite en inventaire et en politique opérationnelle explicite.
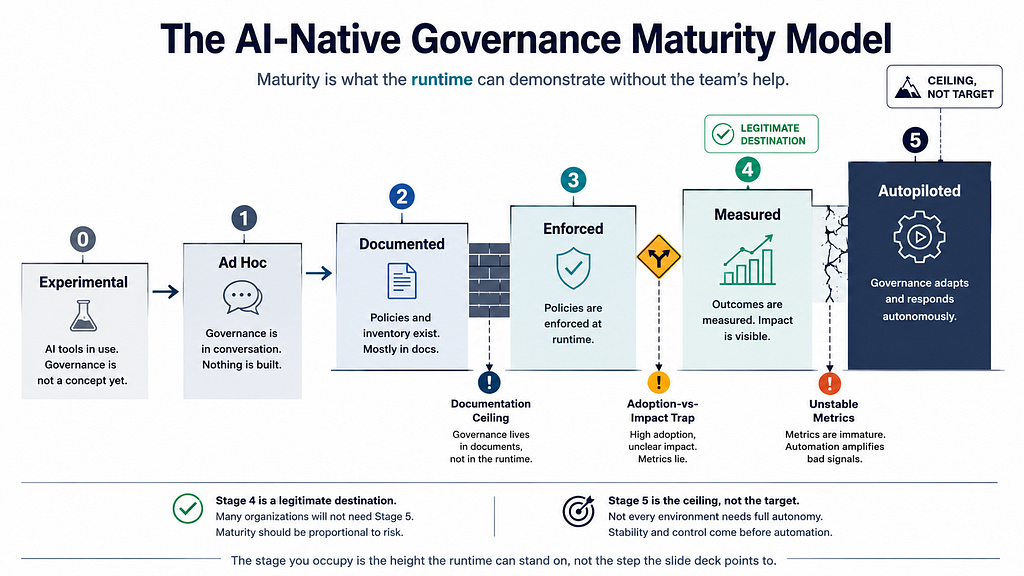
Étape 2 : Documenté
L’organisation sait décrire ses agents, compétences et outils, ainsi que les règles attendues.
Les politiques sont écrites, attribuées et versionnées. Les équipes disposent de standards pour l’accès aux données, les approbations, la gestion du changement et l’usage autorisé.
Mais cette étape crée un faux plafond fréquent : la documentation peut progresser alors que le runtime reste inchangé.
Le passage à l’étape 3 exige que la politique devienne un artefact évaluable par la machine et que l’application des règles existe aux endroits où le comportement peut réellement être modifié.
Étape 3 : Appliqué
La politique fait partie de l’exécution.
Contrats et politiques sont versionnés. Des contrôles existent à l’authoring, dans la CI, au déploiement et au runtime. Les actions sensibles peuvent être refusées ou escaladées. Les mécanismes de stop, de limitation de portée et de récupération sont testés. Les changements importants sont traçables de l’intention jusqu’à l’effet en production.
La question devient alors : non plus « avons-nous des contrôles ? », mais « fonctionnent-ils correctement ? ».
Étape 4 : Mesuré
Le système de gouvernance devient observable sur ses propres critères.
L’équipe suit les blocages, les faux positifs, les faux négatifs, la durée des exceptions, le temps de confinement, l’attribution des incidents et le coût des actions gouvernées.
Une même question d’audit doit pouvoir recevoir le même type de preuve au trimestre suivant, sans nouvelle reconstruction manuelle.
L’étape 4 peut être une destination légitime. Une flotte stable et un rayon d’impact limité ne nécessitent pas forcément l’automatisation des décisions de gouvernance routinières.
Étape 5 : Autopiloté
Les décisions routinières de gouvernance sont automatisées à partir d’artefacts signés et versionnés. Les humains se concentrent sur les exceptions, les risques nouveaux et l’évolution des politiques.
Les nouveaux agents héritent des contrôles par le déploiement. Les exceptions expirent automatiquement. Une dérive connue peut déclencher une réponse prédéfinie. La capacité de gouvernance peut augmenter sans faire croître l’équipe au même rythme que la flotte.
Il n’existe pas d’étape 6 utile appelée « sans humains ». L’autopilotage déplace l’intervention humaine ; il ne supprime pas la responsabilité.
Le plafond documentaire et l’inflation de maturité
L’erreur la plus courante consiste à mesurer la maturité par l’activité visible.
Une équipe peut disposer d’une excellente documentation et rester à l’étape 2 si une violation de politique n’est pas réellement bloquée. Elle peut avoir un tableau de bord sans être à l’étape 4 si ce tableau ne mesure que l’adoption.
Règle pratique : votre niveau réel est le niveau le plus élevé dont les capacités critiques peuvent être démontrées de bout en bout dans le runtime.
Un contrôle manquant sur un chemin à haut risque compte davantage que plusieurs contrôles impeccables sur des chemins à faible risque.
La maturité doit être proportionnelle au risque
L’étape 5 n’est pas la destination de toutes les organisations.
Le niveau requis dépend du rayon d’impact. Un assistant interne sans accès aux données sensibles ni à la production n’a pas besoin de la même profondeur de contrôle qu’un agent capable de modifier un système client, des données réglementées ou des flux financiers.
La bonne question devient : quel est le niveau de maturité le plus bas qui rend ce risque spécifique défendable ?
Sur-gouverner une surface peu risquée gaspille de l’effort d’ingénierie. Sous-gouverner une surface critique crée une exposition réelle.
Mesurer adoption, application et résultats
Trois couches de métriques doivent être lues ensemble.
Adoption : agents enregistrés, équipes onboardées, compétences publiées, couverture des politiques.
Application : évaluations de politiques, taux de blocage, faux blocages, faux laisser-passer, expiration des exceptions, engagements de confinement et temps de confinement.
Résultats : fréquence et gravité des incidents, latence des réponses d’audit, coût par action gouvernée, thèmes récurrents de postmortem et délai entre un changement produit par un agent et son effet en production avec provenance intacte.
L’adoption sans application reste de la documentation. L’application sans résultats reste du processus.
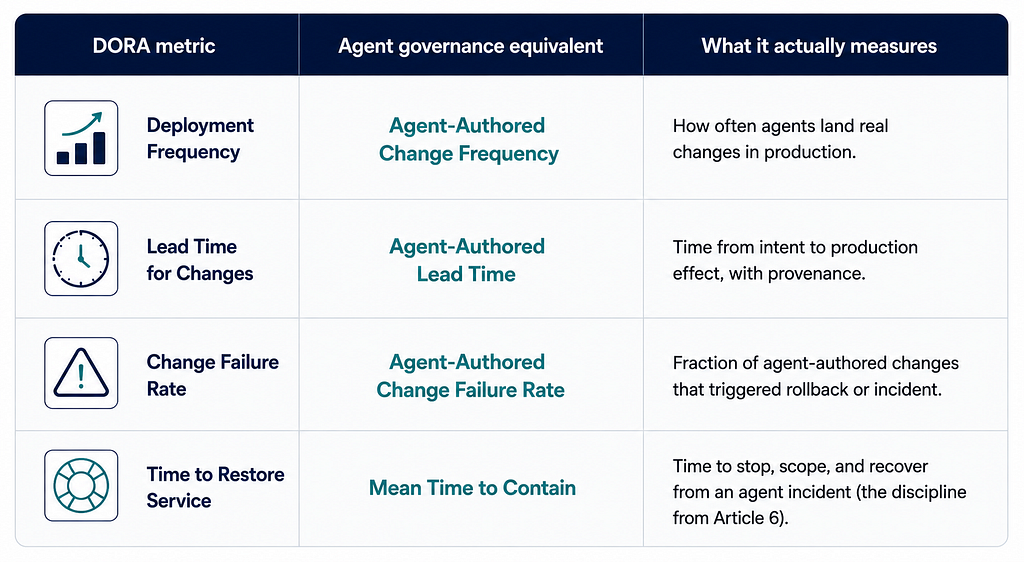
Une discipline de type DORA pour les agents
La livraison logicielle s’est améliorée lorsque les équipes ont appris à lire débit et stabilité ensemble. Les systèmes agentiques ont besoin du même réflexe.
Davantage de changements produits par des agents n’est pas automatiquement un progrès si le taux d’échec augmente. Une exécution plus rapide n’est pas une maturité supérieure si la provenance, le confinement ou la conformité se dégradent.
Le débit sans stabilité est une exposition accélérée.
Runtime Verification Probes
Les questionnaires favorisent l’autoévaluation optimiste. Les probes demandent des preuves au système.
- Provenance probe : choisir un changement récent et retracer agent, modèle, version de politique et intention autorisante.
- Containment probe : arrêter un agent réel dans un environnement sûr et prouver que l’arrêt s’est produit dans la limite prévue.
- Calibration probe : montrer la tendance récente des faux blocages et faux laisser-passer par politique.
- Honesty probe : montrer une métrique inconfortable et l’action prise en conséquence.
- Autopilot probe : montrer une décision routinière réalisée automatiquement contre des artefacts signés, avec preuve.
Un niveau qui ne survit pas à son probe reste une aspiration.
Comment utiliser le modèle lundi
- Exécutez les probes et choisissez le niveau que le runtime peut réellement prouver.
- Identifiez la capacité manquante la plus risquée.
- Choisissez un contrôle concret qui ferme cet écart.
- Attribuez un propriétaire, une échéance et un artefact de preuve.
- Choisissez une métrique d’application ou de résultat.
- Rejouez le probe du niveau suivant à la fin du cycle.
Le but n’est pas de grimper pour obtenir un numéro supérieur. Le but est de rendre la prochaine décision de gouvernance plus démontrable, plus répétable et plus défendable.
Conclusion de la série
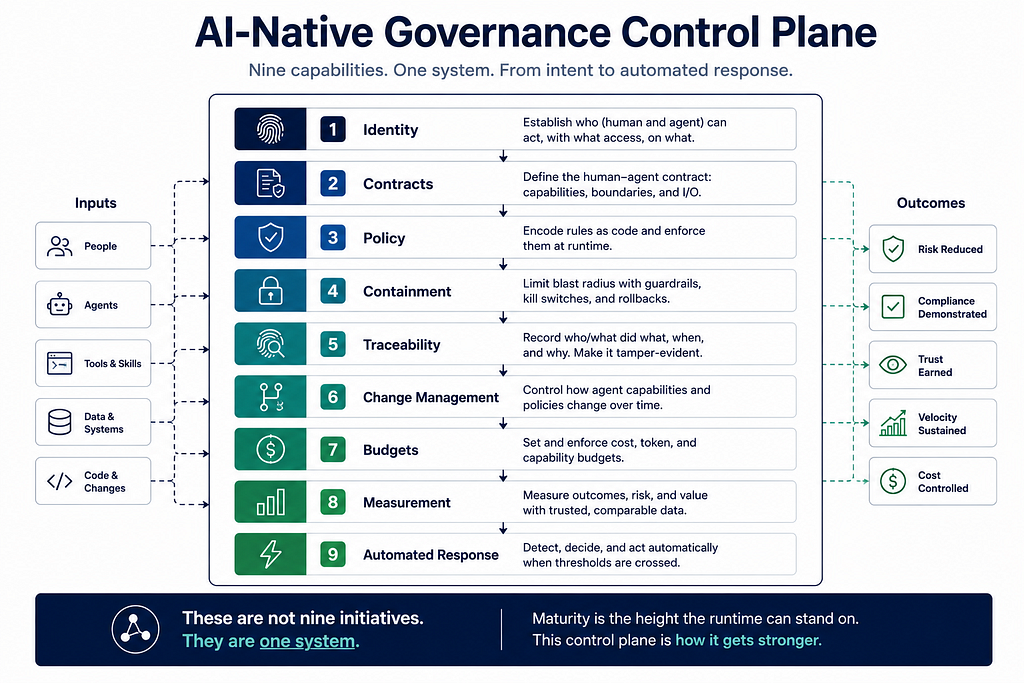
Les dix articles décrivent une seule architecture.
L’identité dit ce qui agit. Les contrats bornent ce qui est autorisé. La politique exécutable transforme l’intention en décision runtime. Le confinement limite le rayon d’impact. La traçabilité relie l’intention à l’effet. La gestion du changement traite les capacités comme des changements de production. Les budgets bornent coût, tokens, capacité et temps. La mesure montre si l’ensemble fonctionne.
La maturité pose la dernière question : quelle part de cette architecture votre runtime peut-il prouver aujourd’hui ?
Un contrôle qui ne peut pas être démontré finit par redevenir de la documentation. Une organisation AI-native mature oblige régulièrement son runtime à prouver que ses contrôles sont toujours réels.
Publié initialement par Reza Arani sur Medium en juin 2026. Adapté pour Aipolix comme partie 10 de la série AI Governance in an AI-Native Software Development Company.
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter.
Laisser un commentaire