
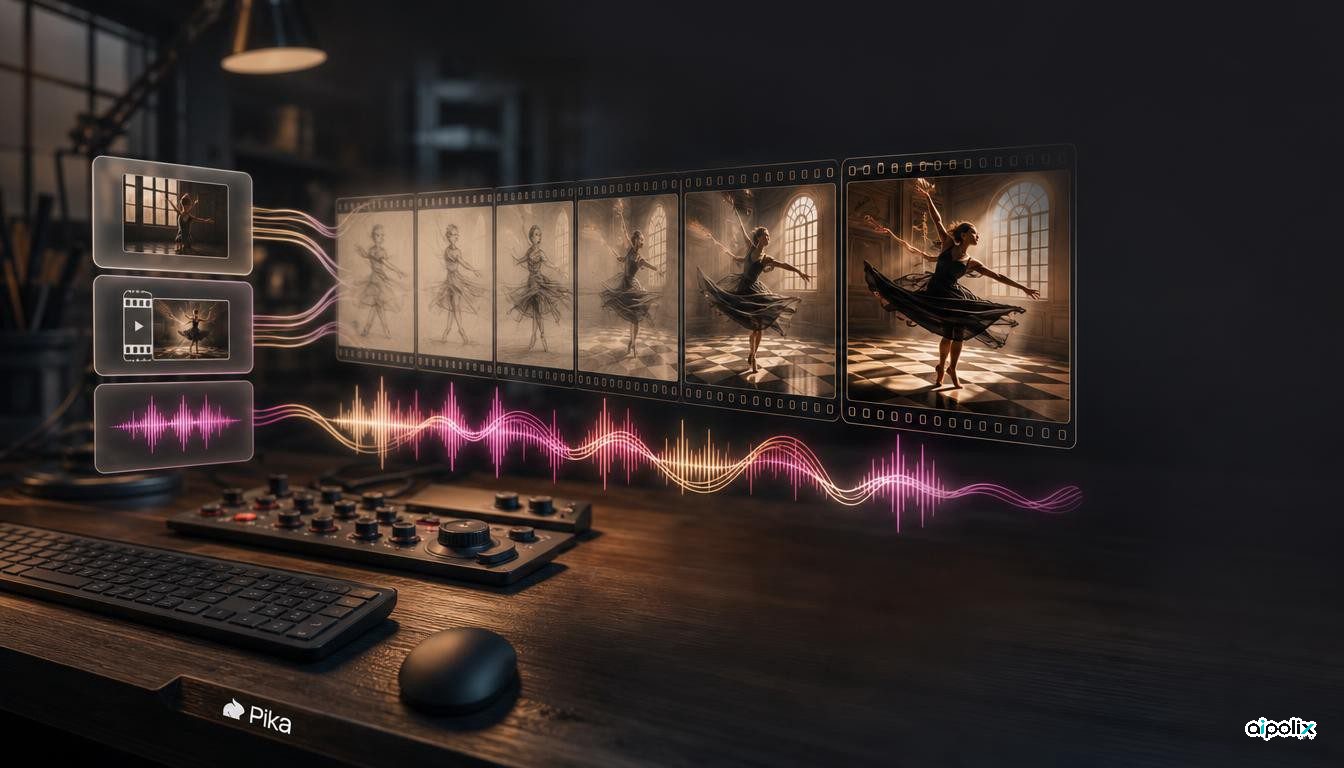
پیکا، شرکت نوپای ویدیوی مولد، مدل Pika H3 Flex را معرفی کرده است؛ مدلی برای ساخت ویدیو همراه با صدا که وزنهایش برای اجرا در اختیار همه قرار گرفته است. این شرکت روز ۲۹ اکتبر ۲۰۲۶ مدل را اعلام کرد و در همان روز آداپتورهای مولد را در هاگینگفیس و کد اجرای مدل را در گیتهاب گذاشت. به گفته پیکا، این مدل از ۲ نوامبر به محصول عمومی ساخت ویدیوی شرکت هم اضافه میشود.
این مدل از صفر آموزش ندیده است. پیکا مدل باز ویدیو و صدای H3 از شرکت مینیمکس را در سه مرحله بازآموزی کرده است: تنظیم دقیق نظارتشده با مجموعهدادهای داخلی که بر پایه کیفیت زیباییشناختی گزینش شده، روشی برای تقطیر مدل که تعداد گامهای نمونهبرداری را از ۵۰ به شش کاهش میدهد، و یادگیری مبتنی بر پاداش و ترجیح انسانی که به شکل آداپتورهای کمرتبه آموزش دیده و سپس با هم ادغام شدهاند. بسته منتشرشده دو آداپتور دارد: یکی برای متن و تصویر آغاز یا پایان صحنه، و دیگری برای مرجعهای چندرسانهای که تا ۱۲ ورودی را میپذیرد: ۹ تصویر، ۳ ویدیو و ۳ قطعه صوتی.
نسخه باز در اجرای محلی کلیپهایی ۵ تا ۱۵ ثانیهای با کیفیت ۴۸۰ یا ۷۶۸ پیکسل و ۲۴ فریم در ثانیه همراه با صدای استریوی ترکیبی ۳۲ کیلوهرتز میسازد. این بسته حدود ۲۱۰ گیگابایت از اجزای پایه مدل مینیمکس را به همراه آداپتور دانلود میکند و به پردازنده گرافیکی انویدیا نیاز دارد. خروجی با کیفیت بالاتر تا ۴K، جداسازی گفتوگو و موسیقی و جلوههای صوتی، بهبود خودکار دستورها و زیرساخت سریع اجرای شرکت فقط از راه رابط برنامهنویسی پولی پیکا در دسترس است. پیکا قول داده مدل یک میلیارد پارامتری افزایش وضوح خود را هم بعداً متنباز کند. آداپتورها تحت مجوز اجتماعی مدل H3 مینیمکس و کد اجرا با مجوز Apache 2.0 منتشر شدهاند.
ادعاهای پیکا بلندپروازانه است. به گفته شرکت، این مدل هنگام عرضه در جدول ردهبندی تبدیل متن به ویدیوی DesignArena رتبه نخست را میان مدلهای دارای وزن باز و رتبه هفتم را در کل داشت، در پنج معیار خودکار کیفیت تصویر و صدا از رقبای همخانواده و چند سرویس تجاری بهتر بود و روی زیرساخت خود شرکت سریعتر از زمان واقعی، حدود ۱٫۸ برابر سریعتر از یکی از سرویسهای رقیب، ویدیو میسازد. در مطالعه ترجیح انسانی شرکت، این مدل در آناتومی بدن، ترکیببندی و هماهنگی صدا پیشتاز بود، اما رقبا در فیزیک، روایت چندصحنهای و نورپردازی ترجیح داده شدند. قیمت تولید روی سرویس پیکا از یک سنت برای هر ثانیه ویدیو شروع میشود.
نخستین آزمون مستقل تصویر متعادلتری نشان میدهد. یک سازنده محتوا که ۷۵ رندر روی یک کارت گرافیک انویدیا در محیط ComfyUI گرفت، به این نتیجه رسید که صدای این مدل از سه نسخه سریع دیگر مدل پایه شفافتر است، اما ساخت یک کلیپ ۱۵ ثانیهای حدود چهار دقیقه طول کشید، یعنی تقریباً ۱٫۵ برابر یک روش رقیب چهارگامی، و فریمهای ثابتمانده بیشتری داشت که به شکل لرزش در تصویر دیده میشود. این آزمون فقط با یک شخصیت و بدون شنیدن کور انجام شد.
پذیرش این مدل هنوز در آغاز راه است: تا ۲ نوامبر مخزن گیتهاب حدود ۵۰۰ ستاره و صفحه هاگینگفیس نزدیک به ۳۳۰ پسند گرفته بود. مدل از راه قالبهای ComfyUI و کتابخانه Diffusers هم قابل استفاده است.
این عرضه روندی رو به گسترش را در ویدیوی باز نشان میدهد: شرکتهای کوچکتر یک مدل پایه باز و توانمند را برمیدارند، آن را برای سرعت و کنترل بیشتر بازآموزی میکنند و آداپتورها را منتشر میکنند، اما ارزشمندترین قابلیتهای نهایی را پشت رابط پولی خود نگه میدارند.