
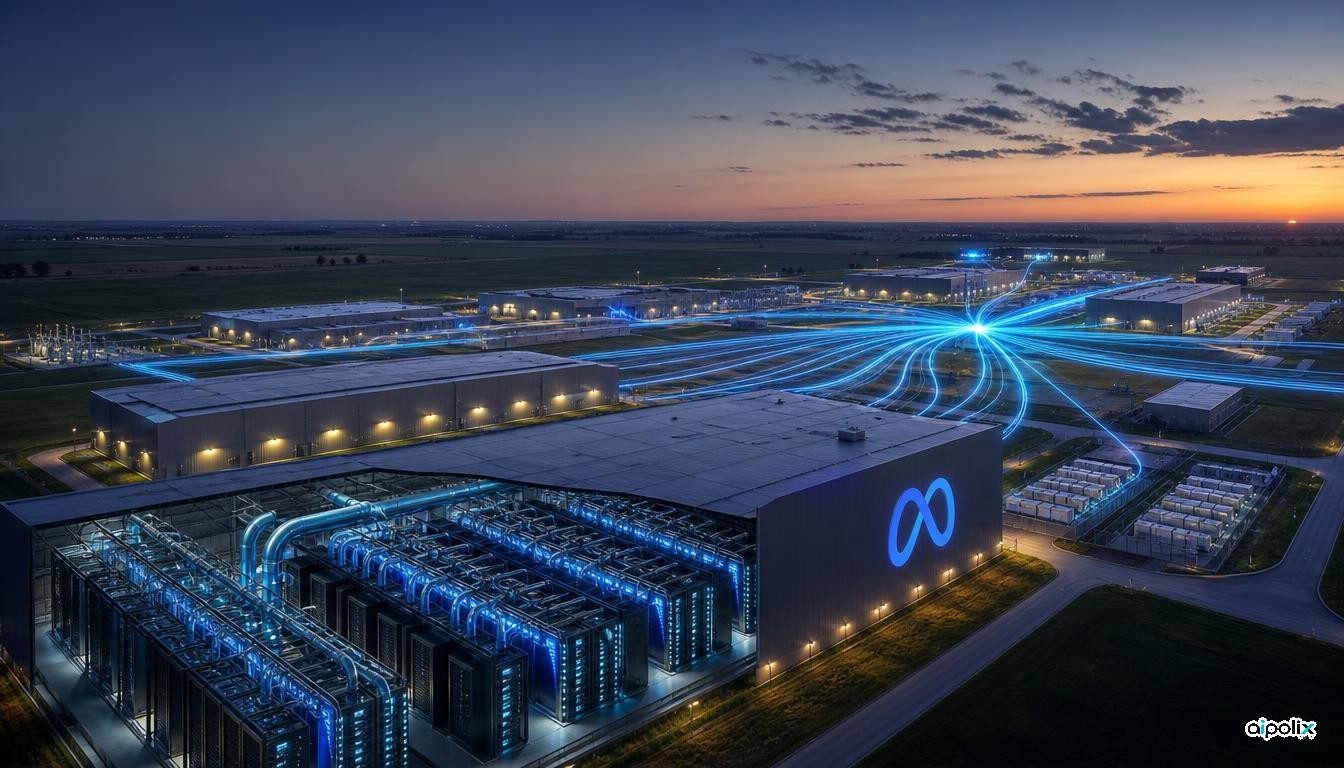
متا تاکنون دقیقترین تصویر عمومی را از پرومتئوس (Prometheus)، ابرخوشه هوش مصنوعی خود در نیو آلبانی در ایالت اوهایو آمریکا، ارائه کرده است. در یادداشتی فنی به تاریخ ۱۹ اکتبر ۲۰۲۶، چهار تن از مدیران زیرساخت این شرکت میگویند فاز نخست به پایان رسیده و برای آموزش مدلهای پایه Muse، از جمله مدلهای پیشرو Muse Wonder که این ماه عرضه شد، به کار رفته است و این سایت در حال گسترش به سوی حدود یک میلیون پردازنده گرافیکی است.
مقیاس، مهمترین نکته است. دو سال پیش این مجموعه تنها ترافیک معمولی وب را پردازش میکرد. اکنون به گفته متا، صدها هزار پردازنده گرافیکی در سالنهای متعارف، ساختمانهایی که از ابتدا برای هوش مصنوعی طراحی شدهاند و سازههای موقتی که سریع برپا میشوند پراکندهاند و با فیبر نوری چنان به هم پیوستهاند که مانند یک ماشین واحد کار میکنند. متا کل این پروژه را در رده گیگاوات توصیف میکند.
اکنون دو نسل از رکهای انویدیا در حال کارند. سکوی Catalina از سختافزار GB200 NVL72 در چیدمانی دو رکی استفاده میکند که متا آن را برگزید تا هر پردازنده گرافیکی ۸۰۰ گیگابیت شبکه بیرونی داشته باشد؛ یعنی دو برابر پیکربندی استاندارد. سکوی Clemente به GB300 NVL72 در یک رک واحد رسیده که برای هر پردازنده ۲۸۸ گیگابایت حافظه HBM دارد و هر رک حدود ۱۳۵ کیلووات برق مصرف میکند. سکوی سوم با نام San Miguel رکهای Vera Rubin NVL72 انویدیا را با مصرف بیش از ۱۷۰ کیلووات برای هر رک میآورد و متا انتظار دارد کارایی به ازای هر وات را ۱۰ تا ۲۰ درصد نسبت به Clemente بهبود دهد.
شبکه بر اساس فاصله تقسیم شده است. در داخل هر ساختمان، یک شبکه اترنت اختصاصی تا ۲۰٬۷۳۶ پردازنده گرافیکی را به هم وصل میکند که اکنون بر پایه سوئیچهای Minipack3 ساخت خود متا و نرمافزار FBOSS آن بنا شده است. میان ساختمانها، لایهای تجمیعی با شاسیهای Arista 7800 و تراشههای Jericho3 شرکت Broadcom، سایتهایی را که از ۲ تا بیش از ۱۰۰ کیلومتر از هم فاصله دارند به هم متصل میکند و برای طولانیترین مسیرها از اپتیک همدوس 800G-ZR بهره میگیرد. StorageReview و Converge Digest که این یادداشت را پوشش دادند، این اتصال میان ساختمانی را مهمترین تفاوت با خوشههای تکسایتی میدانند.
بخش بزرگی از این یادداشت به زنده نگه داشتن کارهای آموزشی عظیم اختصاص دارد. متا میگوید شمار وقفهها در میانه ۲۰۲۵ به نزدیک هزار مورد در روز برای هر ۸۰۰۰ پردازنده رسیده بود و از آن زمان ۹۹ درصد کاهش یافته است. در آموزش Muse Wonder، بهرهوری مفید در پیشآموزش از ۸۵ درصد و در یادگیری تقویتی از ۹۰ درصد فراتر رفت و میانگین زمان میان دو وقفه اکنون از ۵۴ هزار ساعت پردازنده گرافیکی گذشته و هدف، نزدیک به ۱۰۰ هزار ساعت است. هر رک ۷۲ پردازندهای کارها را روی ۶۴ پردازنده اجرا میکند و هشت پردازنده را بهعنوان یدک آماده نگه میدارد و حدود ۲ درصد رک اضافی نیز ذخیره است. سامانهای برای محدودسازی توان به نام Dynamo Dimmer نوسانهای ۳۰ تا ۴۰ درصدی بار را که آموزش همزمان ایجاد میکند، هموار میسازد.
این ارقام را خود متا اعلام کرده و مصرف کل برق، شمار پردازندهها در هر فاز و هزینهها را فاش نکرده است. با این حال، این گزارش نشان میدهد غولهای فناوری چگونه با کمبود برق در یک سایت، چند ساختمان را به یک سامانه آموزشی واحد تبدیل میکنند. متا میگوید این تجربهها مبنای طراحی Hyperion، ابرخوشه بعدی آن در ریچلند پریش لوئیزیانا، خواهد بود.