
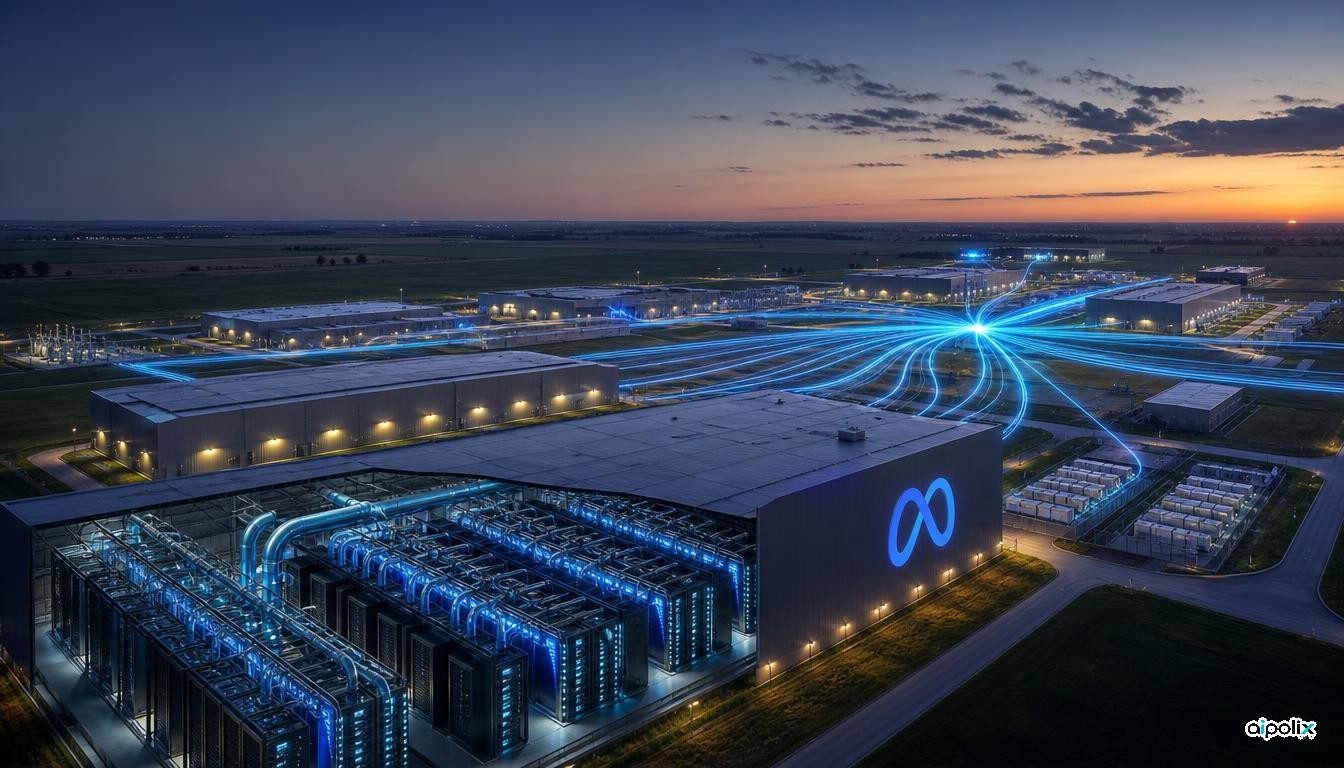
Meta a livré la description publique la plus fouillée à ce jour de Prometheus, la grappe de calcul pour l'intelligence artificielle qu'elle construit à New Albany, dans l'Ohio. Dans un billet technique daté du 19 octobre 2026, quatre responsables de l'infrastructure du groupe indiquent que la première phase est achevée et qu'elle a permis d'entraîner les modèles de fondation Muse, dont les modèles de pointe Muse Wonder lancés ce mois-ci, et que le site s'étend vers environ un million de GPU.
L'échelle frappe d'abord. Il y a deux ans, le campus traitait un trafic web ordinaire. Aujourd'hui, selon Meta, il relie des centaines de milliers de GPU répartis entre des halls classiques, des bâtiments conçus pour l'IA et des structures provisoires montées rapidement, reliés par fibre optique pour fonctionner comme une seule machine. Meta qualifie l'ensemble du projet de classe gigawatt.
Deux générations de baies NVIDIA tournent déjà. Catalina utilise du matériel GB200 NVL72 réparti sur deux baies, un choix fait pour offrir à chaque GPU 800G de réseau vers l'extérieur, soit le double de la configuration standard. Clemente passe au GB300 NVL72 dans une baie unique, avec 288 Go de mémoire HBM par GPU et environ 135 kW par baie. Une troisième plateforme, San Miguel, apportera des baies NVIDIA Vera Rubin NVL72 de plus de 170 kW chacune, dont Meta attend un gain de 10 à 20 % de performance par watt par rapport à Clemente.
Le réseau se découpe selon la distance. Dans chaque bâtiment, une infrastructure Ethernet dédiée relie jusqu'à 20 736 GPU, désormais bâtie sur les commutateurs Minipack3 de 51,2T conçus par Meta et pilotés par son logiciel FBOSS. Entre les bâtiments, une couche d'agrégation en châssis Arista 7800 dotés de puces Broadcom Jericho3 relie des sites distants de 2 à plus de 100 kilomètres, avec des optiques cohérentes 800G-ZR pour les plus longues liaisons. StorageReview et Converge Digest, qui ont couvert le billet, y voient la principale rupture avec les grappes installées sur un seul site.
Une large part du texte porte sur la survie des très gros entraînements. Meta indique que les interruptions ont culminé à près de mille par jour pour 8 000 GPU mi-2025, avant de reculer de 99 %. Pendant l'entraînement de Muse Wonder, le rendement utile a dépassé 85 % en préentraînement et 90 % en apprentissage par renforcement, et l'intervalle moyen entre deux interruptions dépasse désormais 54 000 heures-GPU, avec un objectif proche de 100 000. Chaque baie de 72 GPU fait tourner les tâches sur 64 et garde huit unités en secours immédiat, plus environ 2 % de baies de réserve. Un système de plafonnement de puissance baptisé Dynamo Dimmer lisse les variations de charge de 30 à 40 % que provoque l'entraînement synchronisé.
Ces chiffres émanent de Meta, qui n'a dévoilé ni la consommation totale, ni le nombre de GPU par phase, ni les coûts. Le récit montre néanmoins comment les géants du numérique assemblent plusieurs bâtiments en un seul système d'entraînement, faute de puissance électrique suffisante sur un site unique. Meta affirme que ces enseignements guideront Hyperion, son prochain supercalculateur à Richland Parish, en Louisiane.