انویدیا
-
زیرساخت و تراشه
NVIDIA و Microsoft سختافزار RTX Spark و اجرای agent محلی را به Windows میآورند
NVIDIA لپتاپها و رایانههای کوچک RTX Spark را برای اجرای مدلهای AI روی دستگاه معرفی کرده و Microsoft نیز Microsoft Execution Containers را برای agentها عرضه عمومی کرده است. عرضه لپتاپها برای ۱۶ اکتبر برنامهریزی شده…
-
پژوهش
NVIDIA جزئیات سامانههای Nemotron با نتایج سطح طلای IOI و IMO 2026 را منتشر کرد
NVIDIA روشهای آموزش و inference برای تخصصیسازی Nemotron 3 در برنامهنویسی رقابتی و اثبات ریاضی را منتشر کرده و میگوید سامانههایش از حد نصاب طلای IOI و IMO 2026 عبور کردهاند.
-
زیرساخت و تراشه
Together AI ظرفیت inference را با NVIDIA B300 روی IBM Cloud گسترش میدهد
Together AI در حال توسعه زیرساخت inference سازمانی با یک کلاستر اختصاصی NVIDIA B300 روی IBM Cloud و شبکه Spectrum-X است.
-
کسبوکار
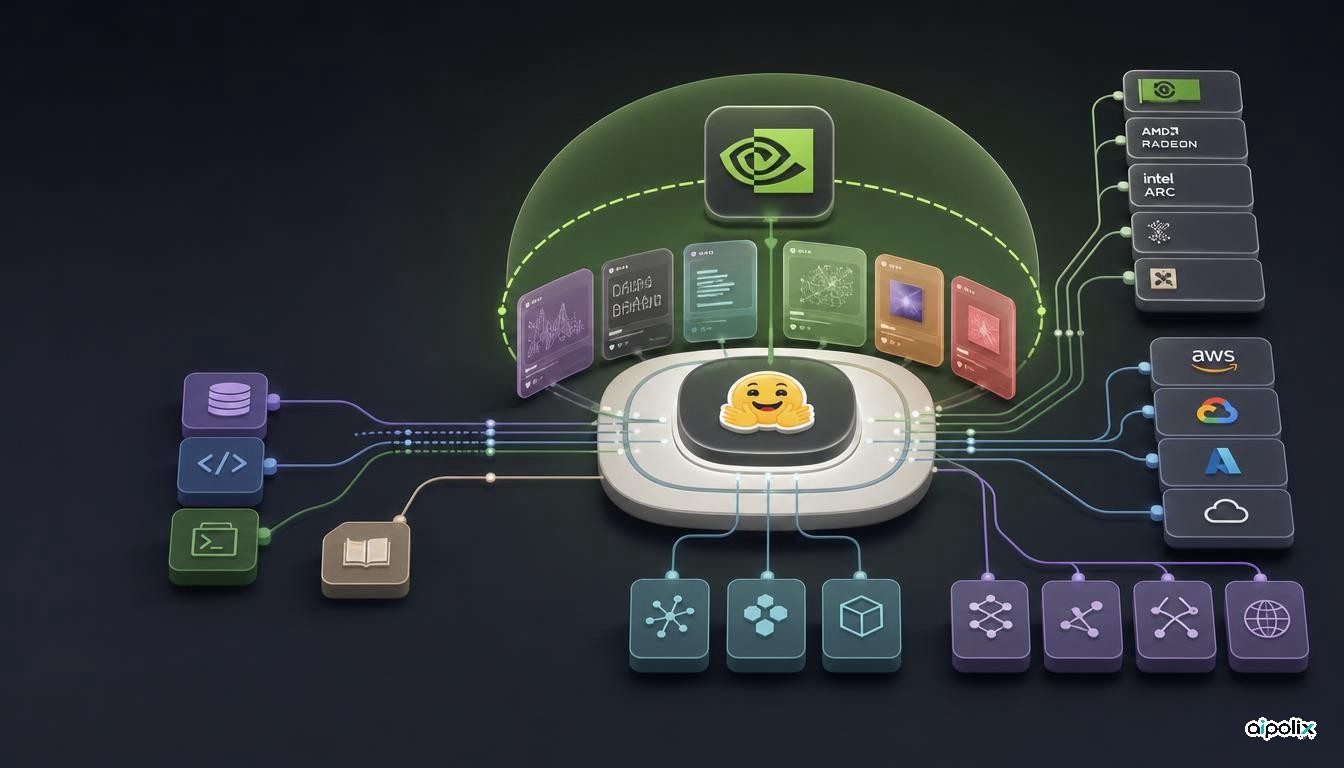
انویدیا توافق ۱۲٫۹۳ میلیارد دلاری برای خرید Hugging Face را رسماً تأیید کرد
انویدیا توافق خرید Hugging Face را رسماً تأیید کرد و وعده داد پلتفرم چندفروشندهای بماند. معیار اصلی، حفظ این بیطرفی در عمل پس از نهایی شدن معامله است.
-
کسبوکار
گزارشها: Nvidia با خرید Hugging Face به ارزش 12.9 billion دلار موافقت کرده است
گزارشها از موافقت Nvidia با تملک Hugging Face به ارزش 12.9 billion دلار خبر میدهند؛ معاملهای که میتواند توزیع مدلهای باز و بیطرفی سکوهای هوش مصنوعی را از نو شکل دهد.
-
محصولات جدید
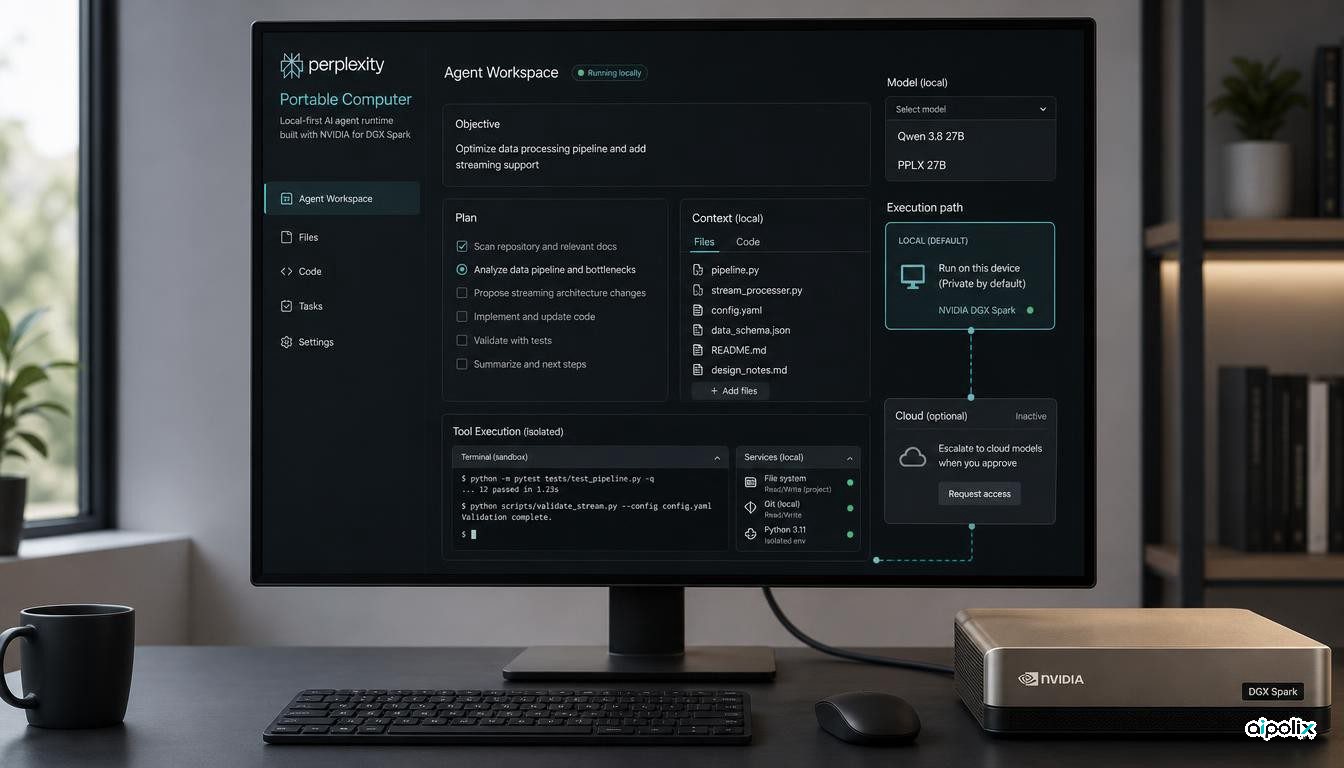
پرپلکسیتی عامل Computer را به سختافزار محلی NVIDIA میآورد
Portable Computer پرپلکسیتی مدل، orchestration، search و ابزارهای sandboxed را روی NVIDIA DGX Spark با cloud escalation اختیاری اجرا میکند.
-
زیرساخت و تراشه
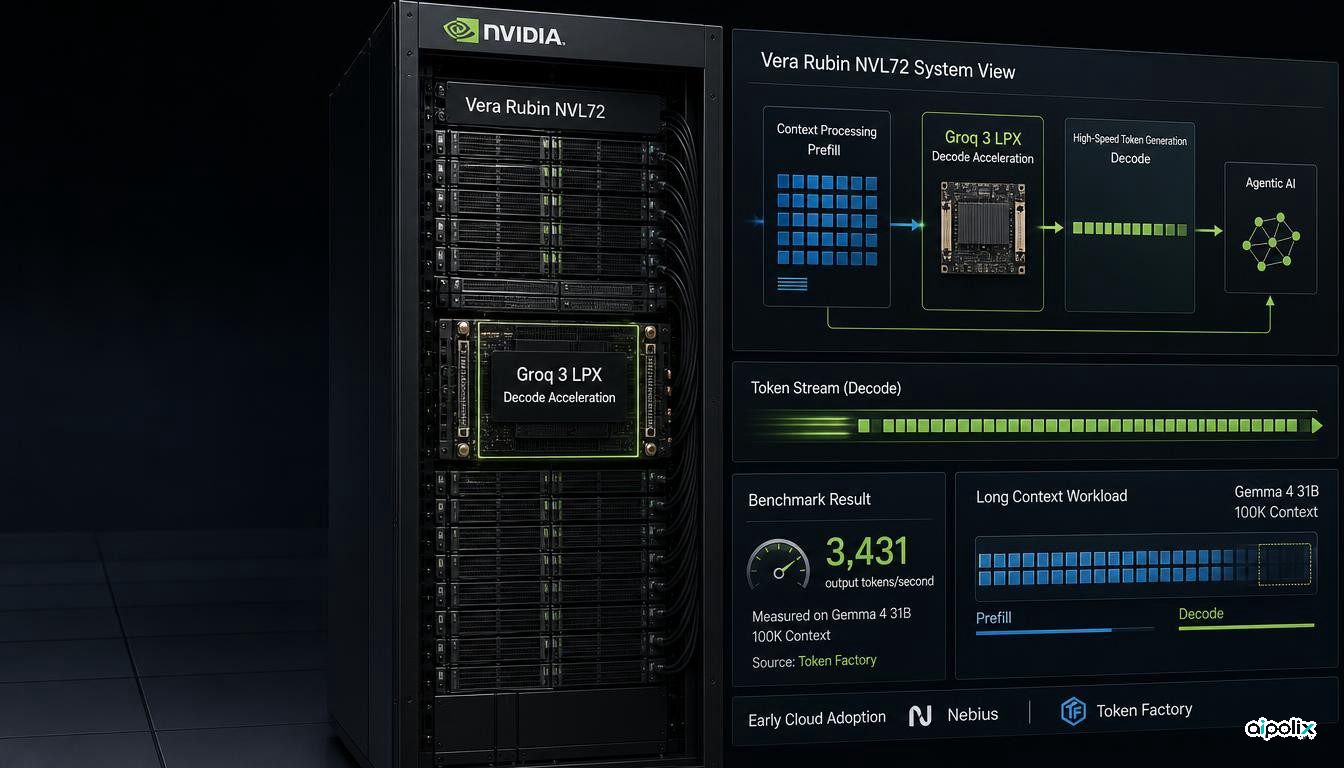
NVIDIA شتابدهنده Groq 3 LPX را برای inference سریعتر agentها وارد تولید کرد
NVIDIA شتابدهنده Groq 3 LPX را در پلتفرم Vera Rubin وارد تولید کرده تا decode latency در workloadهای agent پرمصرف از نظر token را هدف بگیرد.