NVIDIA
-
Infrastructure et puces
NVIDIA et Microsoft installent RTX Spark et les agents locaux au cœur de Windows
NVIDIA annonce des ordinateurs RTX Spark pour exécuter des modèles en local, tandis que Microsoft généralise Microsoft Execution Containers pour les agents. Les premiers portables sont en précommande avant une disponibil…
-
Recherche
NVIDIA détaille des systèmes Nemotron ayant franchi les seuils d'or aux IOI et IMO 2026
NVIDIA publie les méthodes d'entraînement et d'inférence utilisées pour spécialiser Nemotron 3 en programmation compétitive et en démonstration mathématique, avec des résultats annoncés au-dessus des seuils d'or des IOI …
-
Infrastructure et puces
Together AI augmente sa capacité d'inférence sur IBM Cloud avec des systèmes NVIDIA B300
Together AI étend son infrastructure d'inférence d'entreprise avec un cluster NVIDIA B300 dédié sur IBM Cloud et un réseau Spectrum-X.
-
Entreprises
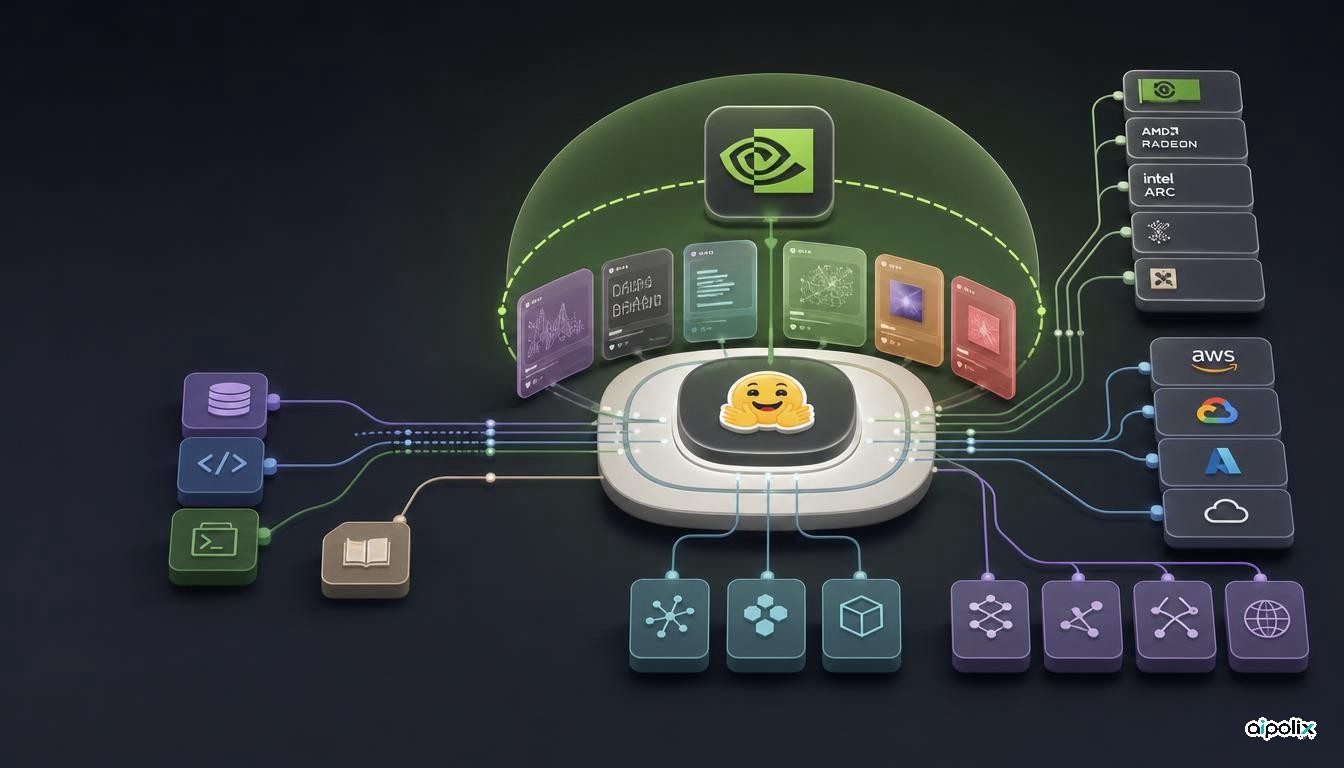
NVIDIA confirme le rachat de Hugging Face pour 12,93 milliards de dollars
NVIDIA confirme l'acquisition de Hugging Face et promet une plateforme ouverte, multi-cloud et multi-accélérateur. La neutralité du produit sera le vrai test.
-
Entreprises
Nvidia aurait accepté d’acheter Hugging Face pour 12.9 billion de dollars
Selon plusieurs informations, Nvidia aurait accepté d’acquérir Hugging Face pour 12.9 billion de dollars, une opération qui pourrait reconfigurer la distribution des modèles ouverts et la neutralité des plateformes d’IA.
-
Nouveaux produits
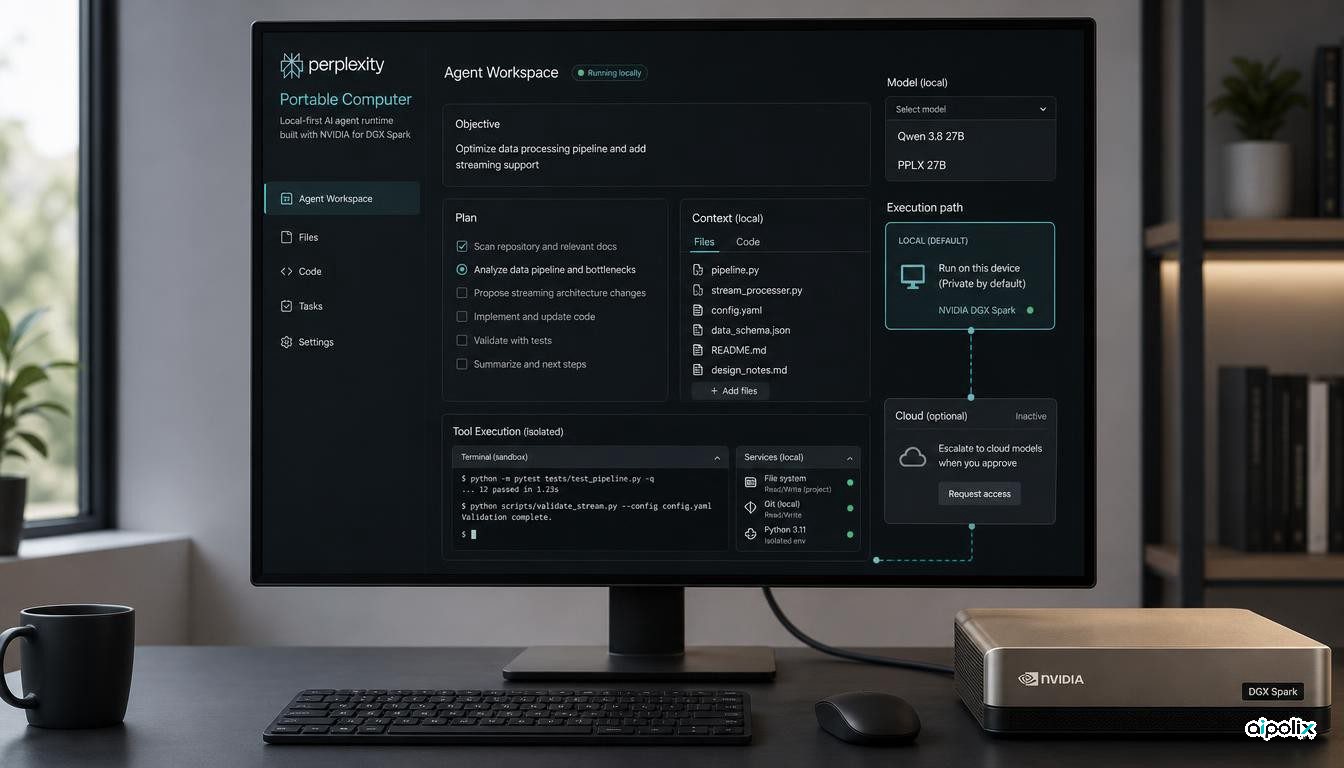
Perplexity déplace son agent Computer sur du matériel NVIDIA local
Portable Computer exécute modèles, orchestration, recherche locale et outils sandboxed sur NVIDIA DGX Spark avec escalade cloud optionnelle.
-
Infrastructure et puces
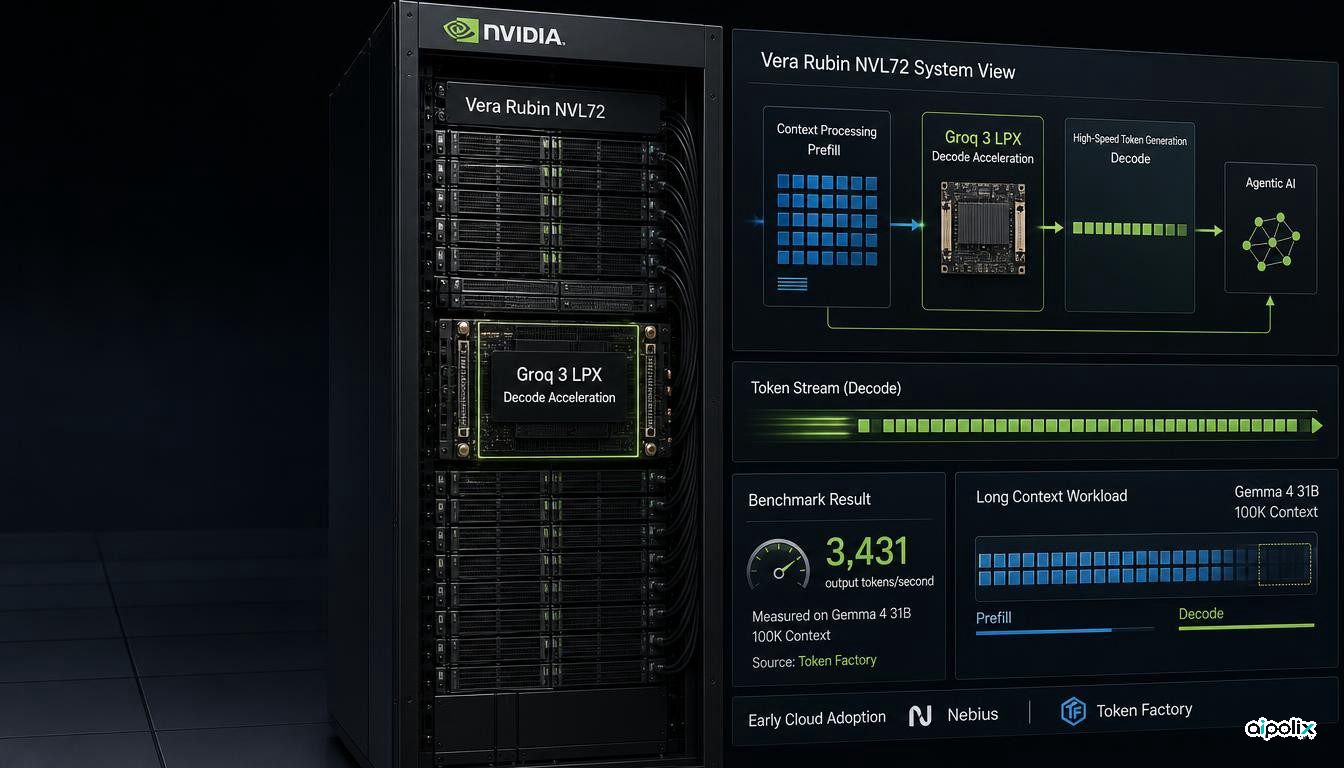
NVIDIA met Groq 3 LPX en production pour accélérer l’inférence des agents
NVIDIA passe Groq 3 LPX en production avec Vera Rubin pour cibler la latence de décodage des agents riches en tokens, avec Nebius comme premier adopteur cloud.