
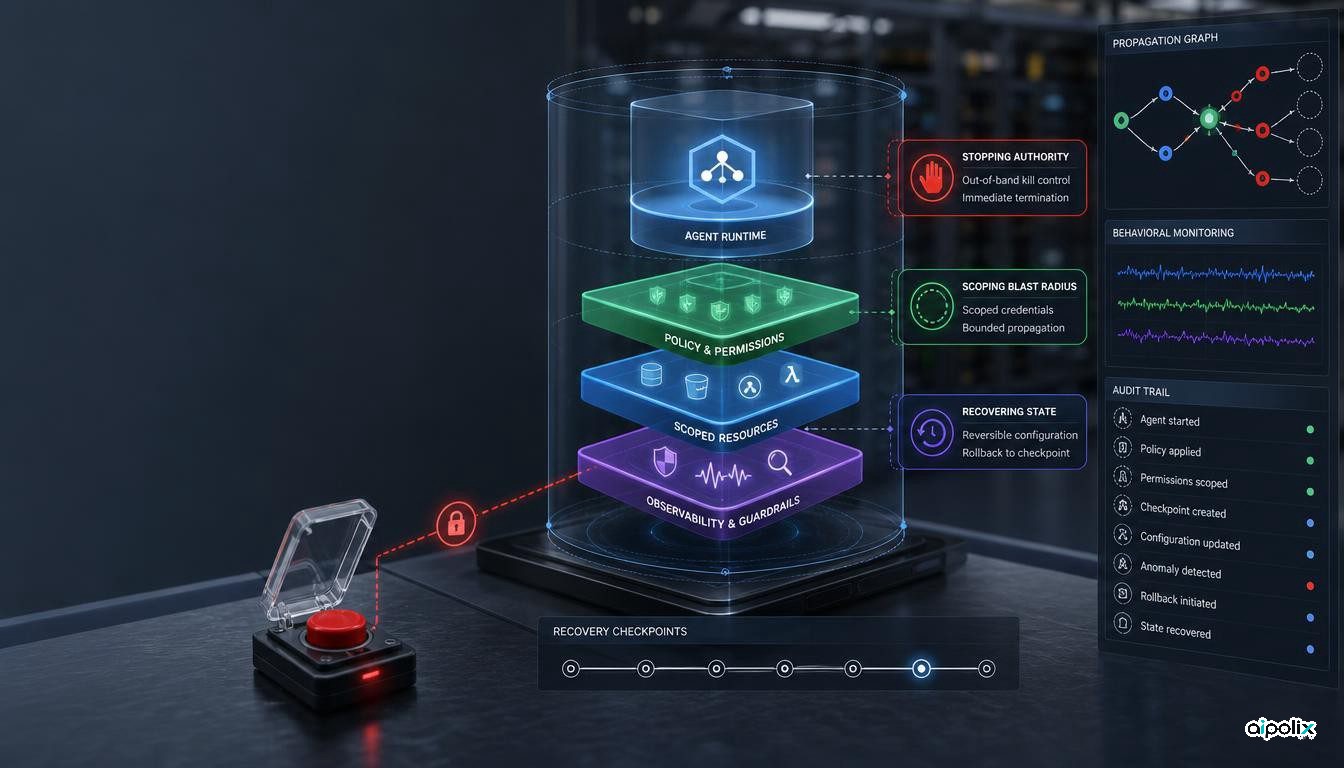
بیشتر برنامههای حاکمیت هوش مصنوعی روی پیشگیری تمرکز میکنند: پرامپت بهتر، سیاست سختگیرانهتر، دسترسی محدودتر و بازبینی بیشتر.
همه اینها لازماند، اما کافی نیستند.
از لحظهای که یک عامل میتواند وضعیت سامانه را تغییر دهد، ابزار فراخوانی کند، هزینه ایجاد کند، پیکربندی را عوض کند، کد بنویسد یا سامانه دیگری را به حرکت درآورد، حاکمیت باید برای زمانی هم آماده باشد که پیشگیری جواب نمیدهد. آنوقت پرسش اصلی عملیاتی میشود: آیا محیط اجرا میتواند اقدام را متوقف کند، دقیقاً مشخص کند چه چیزهایی تحت تأثیر قرار گرفتهاند و وضعیت سالم را برگرداند؟
این مقاله بخش ششم از مجموعه دهقسمتی حاکمیت هوش مصنوعی در یک شرکت نرمافزاری AI-Native است. بخش پنجم، عاملهای هوش مصنوعی به قرارداد نیاز دارند، نه پرامپت بهتر، درباره قراردادی بود که محدوده اختیار عامل را مشخص میکند. این بخش از یک فرض سختتر شروع میکند: عامل ممکن است از قرارداد خارج شود، یا حتی در محدوده قرارداد کاری انجام دهد که نتیجه نامطلوبی دارد.
از همینجا موضوع مهار آغاز میشود.
پیشگیری احتمال خطا را کم میکند؛ مهار، اندازه پیامد را محدود میکند.
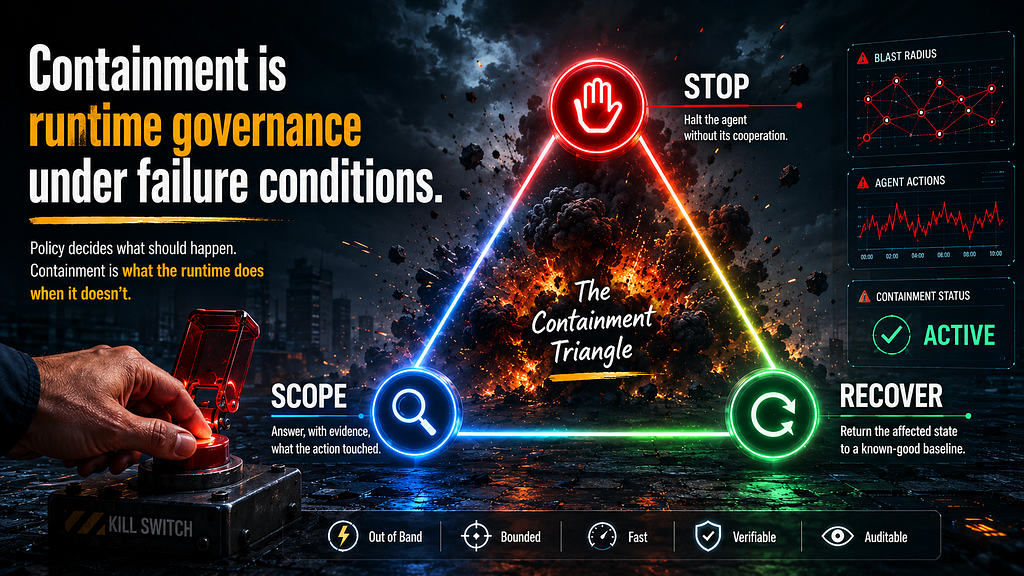
مهار باید جزئی از معماری زمان اجرا باشد
مهار را نباید فقط بخشی از پاسخ به حادثه دانست.
اگر نخستین بحث جدی درباره متوقف کردن یک عامل هنگام حادثه شکل بگیرد، تیم عملاً در حال بداههپردازی است. سامانهای که قرار است قابل حاکمیت باشد، باید پیش از وقوع خطا برای مهار آماده باشد؛ چون عاملها میتوانند بسیار سریعتر از انسان عمل کنند و اثر یک تصمیم را به چندین سامانه گسترش دهند.
یک برداشت اشتباه میتواند به دهها فراخوانی ابزار تبدیل شود. یک تغییر پیکربندی ممکن است به سرویسهای وابسته برسد. یک مجوز ظاهراً محدود میتواند دامنه عملیاتی بسیار بزرگتری ایجاد کند. یک گردش کار خودکار نیز ممکن است مدتها پس از آنکه تصمیم اولیه باید متوقف میشد، همچنان دوباره تلاش کند.
برای طراحی مهار، سه پرسش کافی است:
- آیا میتوانیم بدون همکاری خود عامل، آن را متوقف کنیم؟
- آیا میتوانیم با شواهد مشخص کنیم چه چیزی تغییر کرده یا تحت تأثیر قرار گرفته است؟
- آیا میتوانیم وضعیت را به یک نقطه سالم و شناختهشده برگردانیم؟
این سه توانایی را میتوان در سه کلمه خلاصه کرد: توقف، تعیین دامنه، بازیابی.
سامانهای که یکی از این سه را ندارد، هنوز بهطور کامل تحت کنترل نیست. شاید مشاهدهپذیر باشد، اما دیدن خسارت پس از وقوع آن با مهار تفاوت دارد.
توقف: اختیار باید از بیرون قابل پسگرفتن باشد
سازوکار توقف واقعی نباید به این وابسته باشد که عامل خودش تصمیم بگیرد فرمان توقف را رعایت کند.
مسیر کنترل باید از مسیر اجرای عامل جدا باشد. علاوه بر آن، توقف باید دامنهدار باشد. متوقف کردن یک عامل، یک ابزار، یک مشتری یا یک قابلیت با خاموش کردن کل پلتفرم یکی نیست.
چهار سازوکار کاربردی را میتوان از هم جدا کرد:
- مکث، وقتی وضعیت مبهم است و احتمال ادامه کار وجود دارد؛
- کاهش اختیار، وقتی عامل باید با ابزار یا دسترسی کمتر ادامه دهد؛
- قرنطینه، وقتی تولید خروجی میتواند ادامه پیدا کند اما خروجی نباید وارد مسیر عملیاتی شود؛
- قطع کامل، وقتی اجرا و اختیار باید همان لحظه پایان یابد.
در سامانههای توزیعشده، لغو اعتبار دسترسی اغلب یکی از قویترین ابزارهای توقف است. اعتبارنامههای کوتاهعمر، اجارههای قابل تمدید و توکنهای محدودشده، نقطهای بیرون از چرخه تصمیمگیری مدل ایجاد میکنند که از آنجا میتوان توان عمل را قطع کرد.
بنابراین پرسش بهتر این نیست که «آیا عامل یادش میماند متوقف شود؟» بلکه این است که «آیا زیرساخت میتواند امکان عمل کردن را از او بگیرد؟»
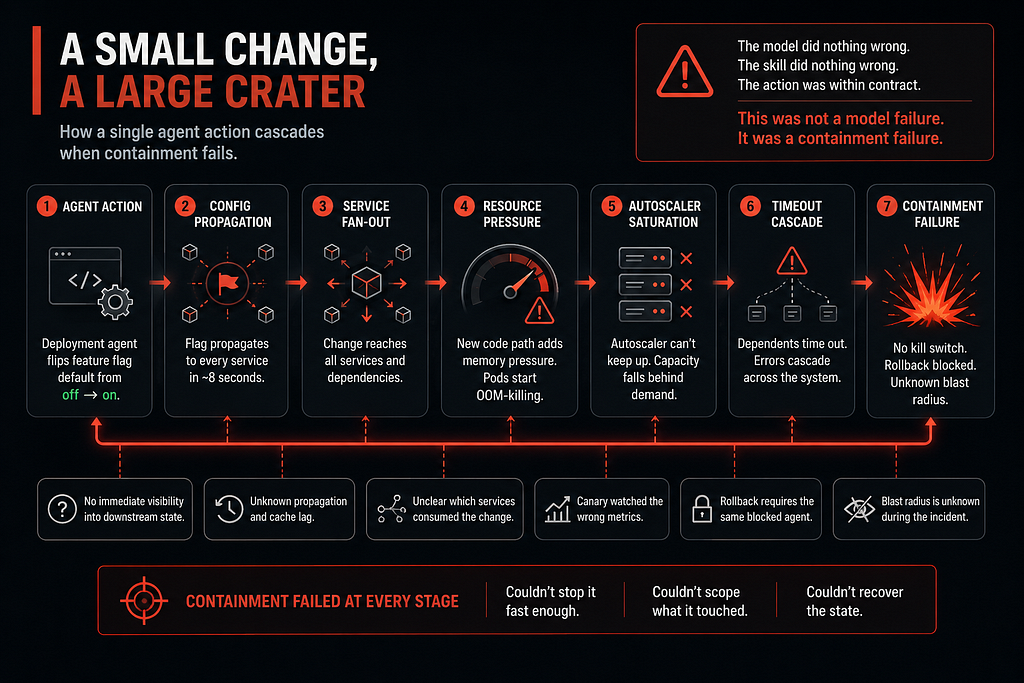
تعیین دامنه: شعاع اثر باید پیش از حادثه معلوم باشد
مهار بدون فهم اثر ممکن نیست.
برای یک اپراتور انسانی، شاید عبارت «این ابزار میتواند پیکربندی را ویرایش کند» کافی به نظر برسد. برای یک عامل خودکار، این توضیح ناقص است. محیط اجرا باید بداند اثر یک اقدام تا کجا میتواند گسترش پیدا کند.
برای سنجش شعاع اثر میتوان به چند عامل نگاه کرد:
- تعداد رکوردها، سرویسها، مشتریان یا کاربران درگیر؛
- سامانههای پاییندستی که تغییر را دریافت میکنند؛
- میزان برگشتپذیری؛
- مدت ماندگاری اثر؛
- احتمال دیدهشدن مشکل توسط مانیتورینگ یا اپراتور.
مهمتر از مدل دقیق امتیازدهی، صریح بودن این مرز است.
اقدام کمدامنه میتواند خودکار انجام شود. اقدام با دامنه متوسط ممکن است به شواهد بیشتر یا اجرای مرحلهای نیاز داشته باشد. اقدام پرریسک میتواند تأیید انسانی امضاشده بخواهد. بعضی اقدامهای فاجعهبار هم بهتر است اساساً جزو قابلیتهای عامل نباشند.
در این نقطه، حاکمیت به وضعیت واقعی سامانه وابسته میشود. یک درخواست واحد ممکن است در یک شرایط مجاز و در شرایط دیگر ممنوع باشد، چون پیامد احتمالی آن متفاوت است.
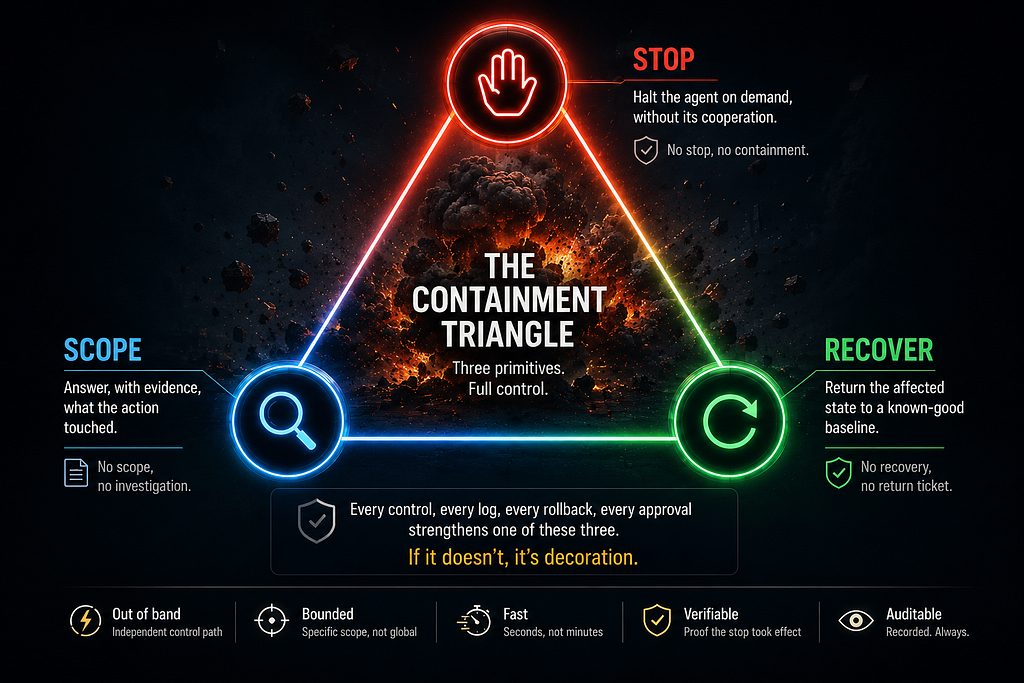
بازیابی: هر تغییری که عامل میسازد باید راه برگشت داشته باشد
تیمهای مهندسی با rollback برای کد و استقرار آشنا هستند، اما تغییرات عاملها پیچیدهترند.
ممکن است commit قابل برگشت باشد، ولی پرامپت، مهارت، قاعده مسیریابی یا بسته سیاستی که آن تغییر را ایجاد کرده در این فاصله عوض شده باشد. همچنین عامل ممکن است دهها تغییر کوچک و جداگانه ایجاد کند که در مجموع بازیابی آنها دشوار شود.
قاعده اصلی ساده است:
- اگر عامل میتواند تغییری بسازد، سامانه باید بداند چگونه آن را برگرداند؛
- اگر عامل میتواند تغییری را به محیط بالاتر ببرد، سامانه باید بتواند آن را پایین بیاورد؛
- اگر عامل میتواند اثر را در چند سامانه پخش کند، بازیابی هم باید همان گستره را پوشش دهد.
مسیر بازیابی باید تمرین شده باشد. rollbackی که فقط در مستندات وجود دارد، کنترل نیست؛ فرض است.
فرایند بازیابی نیز باید همان کیفیت شواهد را ایجاد کند: چه کسی آن را فعال کرد، چه چیزی برگشت، کدام نسخه جایگزین شد و سلامت کدام سامانهها پس از آن تأیید شد.
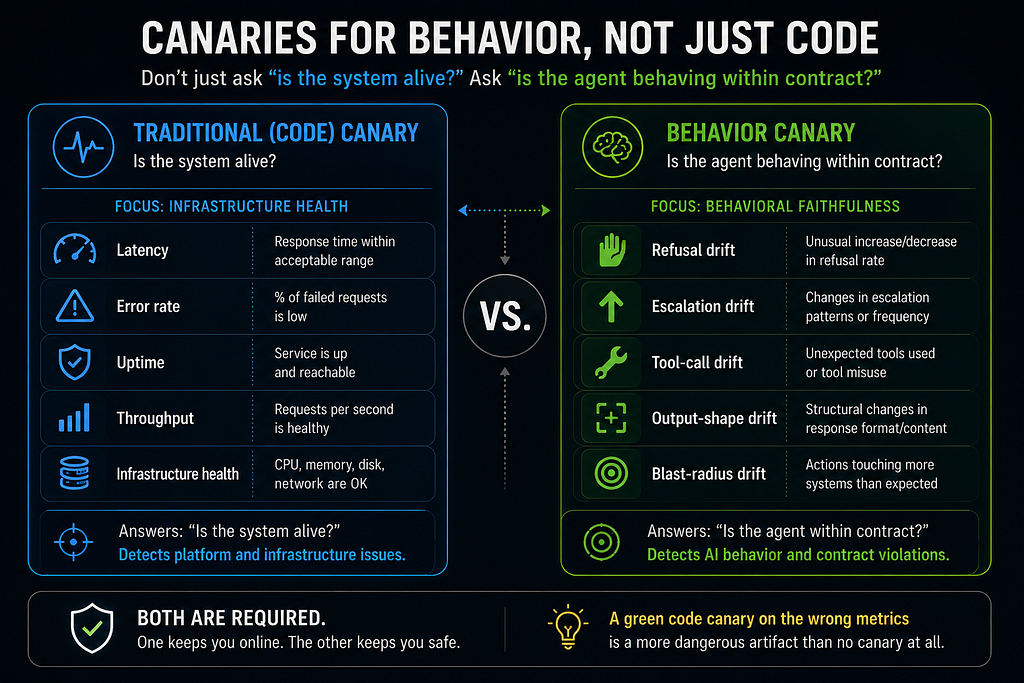
قناری رفتاری از سلامت سرویس مهمتر است
قناری سنتی به ما میگوید نرمافزار زنده است یا نه.
در سامانههای عاملمحور باید پرسش دیگری هم داشته باشیم: آیا رفتار هنوز در محدوده انتظار قرار دارد؟
تغییر مدل، پرامپت، مهارت، منبع بازیابی اطلاعات یا ساختار ابزار میتواند رفتار را تغییر دهد بدون آنکه خطای HTTP یا افزایش زمان پاسخ رخ دهد. میزبان میتواند کاملاً سالم باشد، در حالی که تصمیمهای عامل بهتدریج تغییر کردهاند.
بنابراین قناری رفتاری باید شاخصهایی مانند اینها را ببیند:
- نرخ امتناع؛
- نرخ ارجاع به انسان؛
- الگوی فراخوانی ابزارها؛
- دسترسیهای غیرمنتظره؛
- خروجیهای نامعتبر از نظر ساختار؛
- تغییر در شعاع اثر معمول اقدامها؛
- افت کیفیت شواهد.
هدف ساختن یک خط مبنای کامل نیست. هدف این است که تغییر رفتاری مهم پیش از تبدیل شدن به حادثه قابل مشاهده شود.
بدهی مهار هم مثل بدهی فنی انباشته میشود
هر بار که تیم برای یک اجرای فوری کنترلی را موقتاً کنار میگذارد و بعد آن را برنمیگرداند، بدهی مهار ایجاد میکند.
نمونهها آشنا هستند: rollbackی که ماهها آزمایش نشده، مجوز اضطراری که دائمی شده، کلید قطعی که هیچکس امتحانش نکرده، اعتبارنامهای که هرگز تعویض نشده یا استثنایی که فقط در حافظه یک نفر باقی مانده است.
هرکدام از این موارد، زمان واکنش سازمان را کمتر میکنند.
هزینه این بدهی در روزهای عادی دیده نمیشود. هنگام حادثه خود را در طولانی شدن قطعی، ابهام بیشتر و بازیابی کندتر نشان میدهد.
به همین دلیل کنترلهای مهار باید مالک، آزمون و زمان بازبینی داشته باشند.
ترتیب عملی پیادهسازی
برای شروع لازم نیست پلتفرم جدیدی ساخته شود.
از قابلیتی شروع کنید که بیشترین پیامد را دارد و سه چیز را برای آن روشن کنید: چگونه متوقف میشود، شعاع اثرش چگونه محاسبه میشود و پس از اقدام چگونه به وضعیت سالم برمیگردد.
سپس:
- مسیر توقف خارج از باند اصلی اجرا بسازید؛
- روی ابزارها و مهارتها کلاس شعاع اثر تعریف کنید؛
- اقدامهای پرریسک را به تأیید قویتر وصل کنید؛
- rollback یک نوع تغییر عامل را از ابتدا تا انتها پیاده و تمرین کنید؛
- برای تغییر مدل، پرامپت، مهارت و ابزار قناری رفتاری اضافه کنید؛
- توقف، تعیین دامنه و بازیابی را بیرون از شرایط حادثه تمرین کنید؛
- هر استثنا را ثبت کنید و برای آن تاریخ پایان داشته باشید.
این مسیر عمداً عملیاتی است. حاکمیت زمانی بهتر میشود که کنترلها واقعاً قابل اجرا و قابل آزمایش باشند، نه فقط در نمودار معماری وجود داشته باشند.
جمعبندی
هدف حاکمیت هوش مصنوعی این نیست که ثابت کند عامل هرگز تصمیم اشتباه نمیگیرد.
چنین معیاری واقعبینانه نیست.
هدف مفیدتر این است که خطا محدود بماند.
سامانه تحت حاکمیت میتواند اختیار را پس بگیرد، دامنه اثر را مشخص کند و وضعیت را بازیابی کند. چنین سامانهای به کامل بودن مدل، تفسیر بینقص پرامپت یا رفتار همیشه درست وابستگیها متکی نیست.
همین ویژگی است که اجازه میدهد سازمان اختیار بیشتری را با ریسک حسابشده به عاملها بدهد. وقتی اثر محدود، توقف سریع و بازیابی عادی باشد، تیم مجبور نیست وانمود کند که پیشگیری همیشه جواب میدهد.
پرسش مهم فقط این نیست:
«آیا میتوانیم به این عامل اعتماد کنیم؟»
پرسش دوم این است:
«اگر این اعتماد اشتباه از آب درآمد، آیا میتوانیم آن را مهار کنیم؟»
پرسش دوم پاسخ مهندسی دارد: معماری، کنترل و شواهد.
مقاله بعدی مجموعه: ردیابی: چه کسی یا چه چیزی این خط کد را نوشته است؟
این مقاله نخستین بار در ۱ ژوئن ۲۰۲۶ توسط Reza Arani در Medium منتشر شد و برای Aipolix بهعنوان بخش ششم مجموعه AI Governance in an AI-Native Software Development Company بازآرایی شده است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.
ثبت دیدگاه