
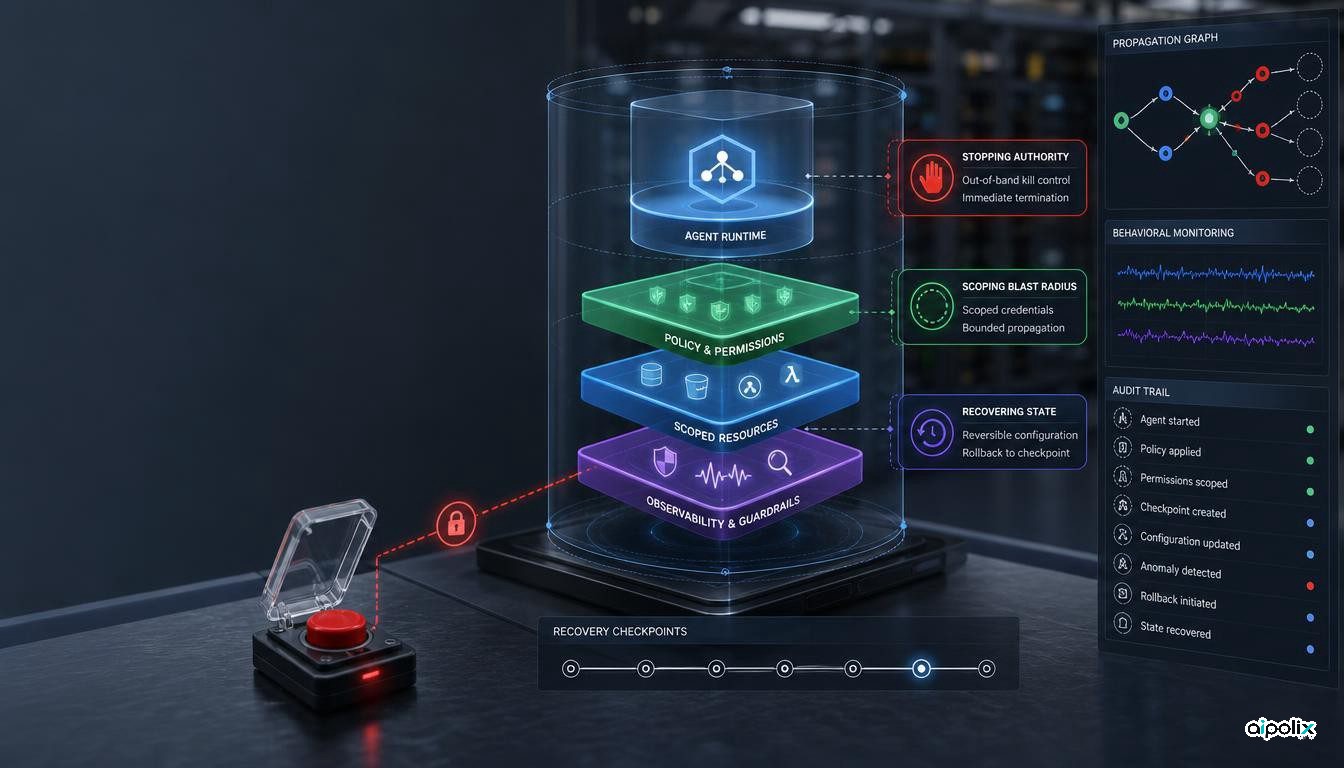
La plupart des programmes de gouvernance de l’IA consacrent l’essentiel de leur énergie à la prévention : meilleurs prompts, politiques plus strictes, permissions plus étroites et davantage de revues.
C’est nécessaire. Ce n’est pas suffisant.
Dès qu’un agent peut modifier un état, appeler des outils, engager des dépenses, changer une configuration, produire du code ou déclencher d’autres systèmes, la gouvernance doit aussi prévoir le moment où la prévention échoue. La question devient alors opérationnelle : le runtime peut-il arrêter l’action, déterminer précisément ce qu’elle a touché et restaurer un état sain ?
Cet article est la sixième partie de la série en dix volets AI Governance in an AI-Native Software Development Company. La partie 5, AI Agents Need Contracts, Not Better Prompts, définissait le contrat qui encadre l’autorité d’un agent. Cette partie part d’une hypothèse plus inconfortable : un système peut sortir de ce contrat, ou produire un mauvais résultat tout en restant techniquement dans ses limites.
C’est là que commence le confinement.
La prévention réduit la probabilité. Le confinement limite les conséquences.
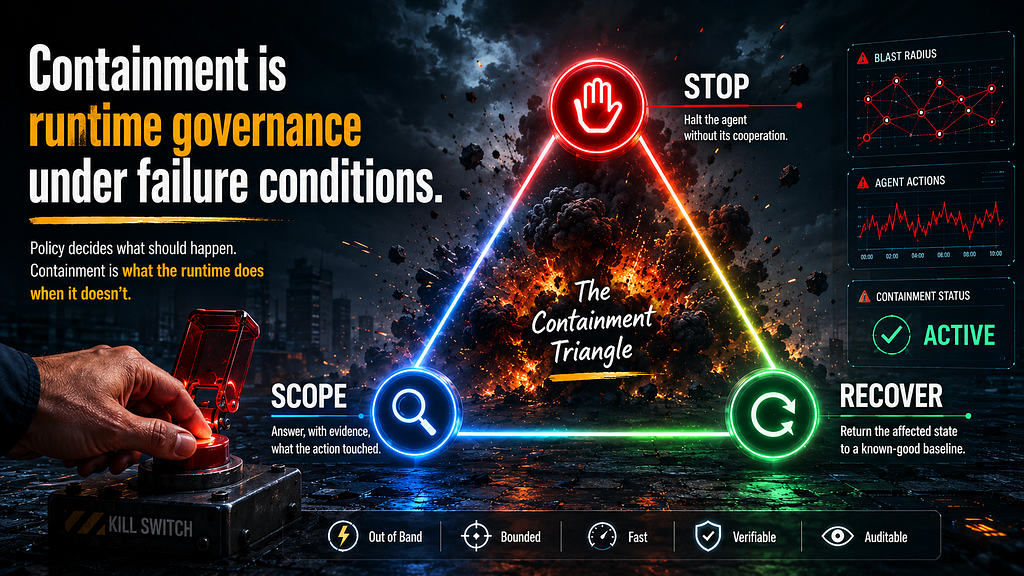
Le confinement appartient au runtime
Le confinement est souvent rangé dans la réponse aux incidents. À ce stade, il est déjà trop tard.
Si la première discussion sérieuse sur la façon d’arrêter un agent a lieu pendant l’incident, l’équipe improvise. Un runtime gouverné doit disposer de mécanismes de confinement avant le premier échec, car les systèmes autonomes peuvent agir plus vite et propager beaucoup plus largement une décision humaine classique.
Une mauvaise interprétation peut devenir des dizaines d’appels d’outils. Une modification de configuration peut se diffuser aux services dépendants. Une permission apparemment limitée peut ouvrir une surface d’action beaucoup plus large que son nom ne le laisse penser. Un workflow automatique peut continuer à réessayer bien après le moment où la décision initiale aurait dû être remise en cause.
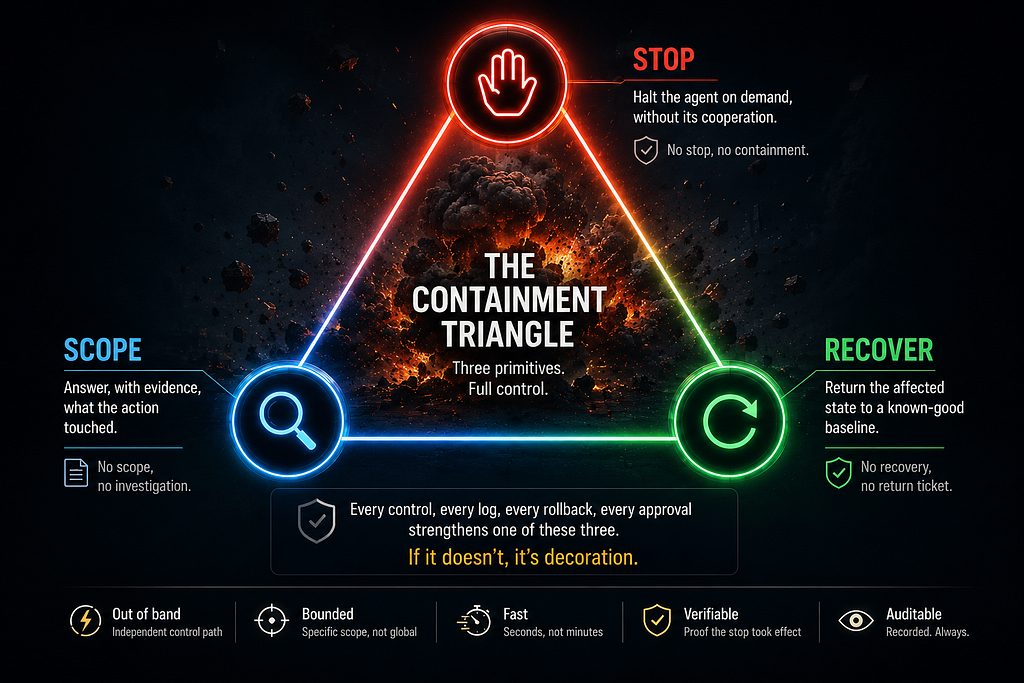
Une conception utile du confinement commence par trois questions :
- Peut-on arrêter l’action sans dépendre de la coopération de l’agent ?
- Peut-on identifier, avec des preuves, ce qui a été affecté ?
- Peut-on restaurer l’état à une base saine connue ?
Ces trois capacités se résument à ARRÊTER, DÉLIMITER, RÉTABLIR.
Un système auquel il manque l’une d’elles n’est pas pleinement gouverné. Il peut être observable, mais observer les dégâts après coup n’est pas les contenir.
ARRÊTER : l’autorité doit pouvoir être retirée
Un vrai mécanisme d’arrêt ne peut pas dépendre de la décision de l’agent de lui obéir.
Le chemin de contrôle doit être indépendant du chemin d’exécution. Il doit aussi être ciblé. Arrêter un agent, un outil, un tenant ou une capacité n’équivaut pas à éteindre toute la plateforme.
On peut distinguer plusieurs primitives :
- pause, lorsqu’une situation reste ambiguë et que l’activité pourra peut-être reprendre ;
- réduction de périmètre, lorsqu’il faut poursuivre avec moins d’outils ou de privilèges ;
- quarantaine, lorsque la production d’un résultat peut continuer mais que ce résultat ne doit pas atteindre la production ;
- arrêt complet, lorsque l’exécution et l’autorité doivent cesser immédiatement.
Dans un système distribué, la révocation des identifiants d’accès est souvent l’un des meilleurs mécanismes d’arrêt. Des jetons de courte durée, des baux renouvelables et des autorisations fortement limitées créent des points de contrôle extérieurs à la boucle de raisonnement du modèle.
La bonne question n’est donc pas de savoir si l’agent se souviendra de s’arrêter, mais si l’infrastructure peut lui retirer la capacité d’agir.
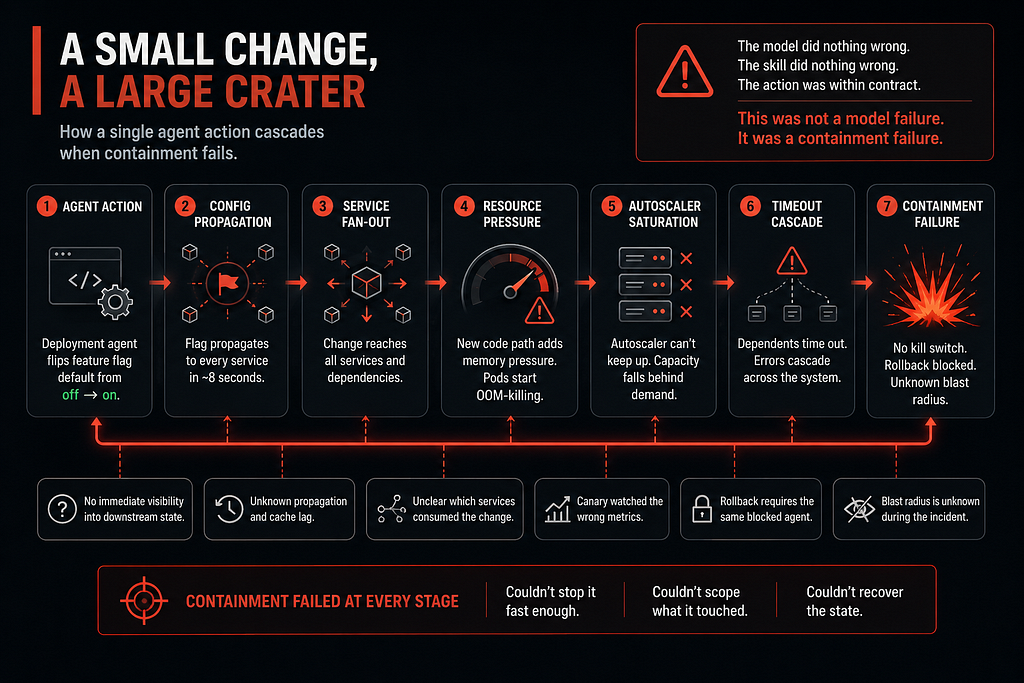
DÉLIMITER : le rayon d’impact doit être connu avant l’incident
Le confinement dépend d’une compréhension claire de l’impact.
Pour un opérateur humain, « cet outil peut modifier la configuration » peut sembler suffisant. Pour un agent autonome, cette description est incomplète. Le runtime doit connaître l’étendue possible de l’effet.
On peut qualifier ce rayon d’impact à partir de dimensions concrètes :
- nombre d’enregistrements, de services, de tenants ou d’utilisateurs concernés ;
- systèmes en aval susceptibles de propager le changement ;
- réversibilité de l’action ;
- durée de persistance de l’effet ;
- visibilité du problème pour le monitoring et les opérateurs.
Le modèle de score exact est moins important que l’existence d’une limite explicite.
Une action à faible rayon peut être automatisée. Une action intermédiaire peut exiger davantage de preuves ou un déploiement progressif. Une action à fort impact peut nécessiter une approbation humaine signée. Certaines actions catastrophiques peuvent tout simplement rester hors du manifeste de capacités de l’agent.
C’est à ce niveau que la gouvernance devient réellement sensible au contexte. La même intention peut être acceptable dans un état du système et refusée dans un autre parce que les conséquences possibles ne sont pas les mêmes.
RÉTABLIR : toute modification produite par l’agent doit être réversible
Les équipes d’ingénierie connaissent déjà le rollback pour le code et les déploiements. Les actions d’agents compliquent ce principe.
Un commit peut être réversible alors que le prompt, le skill, la règle de routage ou le paquet de politiques qui l’a produit a déjà changé. Un agent peut aussi réaliser de nombreuses petites mutations individuellement réversibles, mais difficiles à reconstruire dans leur ensemble.
La règle devrait rester simple :
- si l’agent peut créer une modification, la plateforme doit savoir l’annuler ;
- s’il peut la promouvoir, la plateforme doit savoir la rétrograder ;
- s’il peut propager une action, la récupération doit couvrir cette propagation.
Le rollback doit aussi être exercé. Un chemin de retour uniquement documenté est une hypothèse, pas un contrôle.
L’opération de récupération doit produire la même qualité de preuves que l’action initiale : qui l’a déclenchée, ce qu’elle a annulé, quelle version a été restaurée et quels systèmes ont ensuite été vérifiés.
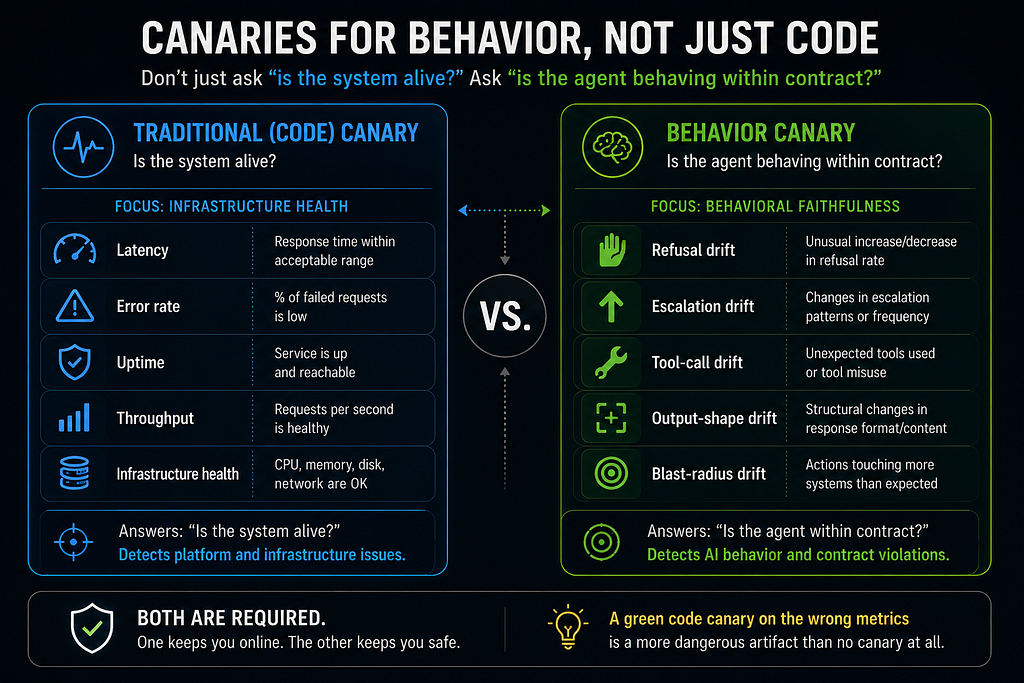
Les canaris comportementaux comptent autant que la santé du service
Un canari traditionnel vérifie surtout que le logiciel fonctionne.
Pour un agent, il faut une autre question : son comportement reste-t-il dans les limites attendues ?
Un changement de modèle, de prompt, de skill, de source de récupération ou de schéma d’outil peut modifier les décisions sans générer d’erreur HTTP ni de hausse de latence. L’hôte peut être parfaitement sain pendant que le comportement dérive.
Un canari comportemental devrait donc suivre notamment :
- le taux de refus ;
- le taux d’escalade ;
- la distribution des appels d’outils ;
- les accès inattendus ;
- les sorties qui violent le schéma attendu ;
- les changements dans les classes habituelles de rayon d’impact ;
- la qualité des preuves produites.
Il ne s’agit pas de créer un modèle comportemental parfait, mais de rendre visible une variation significative avant qu’elle ne devienne un incident.
La dette de confinement est une dette opérationnelle
Les équipes accumulent une dette de confinement chaque fois qu’un contrôle est contourné temporairement puis oublié.
Les exemples sont classiques : rollback non exercé depuis des mois, permission d’urgence devenue permanente, mécanisme d’arrêt jamais testé, identifiants jamais renouvelés ou exception connue d’une seule personne.
Chaque raccourci réduit la marge de réaction.
Cette dette reste invisible en période normale. Son coût apparaît pendant l’incident : interruption plus longue, incertitude plus forte, récupération plus lente.
Les mécanismes de confinement doivent donc être traités comme des actifs opérationnels, avec un propriétaire, des tests et des dates de revue.
Ordre pratique de mise en œuvre
Il n’est pas nécessaire de construire une nouvelle plateforme pour commencer.
Choisissez la capacité autonome dont les conséquences peuvent être les plus fortes et rendez trois points explicites : comment l’arrêter, comment estimer son impact potentiel et comment restaurer l’état après son intervention.
Puis :
- créez un chemin d’arrêt hors bande ;
- classez le rayon d’impact des outils et des skills ;
- liez les actions à fort impact à des exigences d’approbation plus fortes ;
- implémentez et exercez le rollback pour une classe de changement produit par un agent ;
- ajoutez des canaris comportementaux aux changements de modèle, de prompt, de skill et d’outil ;
- exercez arrêt, délimitation et récupération hors des incidents ;
- inventorie chaque exception et donnez-lui une date d’expiration.
Cette approche est volontairement opérationnelle. La gouvernance progresse quand les contrôles sont réellement exécutables et testables, pas lorsqu’ils existent uniquement dans des schémas d’architecture.
Conclusion
L’objectif de la gouvernance de l’IA n’est pas de démontrer que les agents ne feront jamais le mauvais choix.
Ce niveau de certitude n’existe pas.
L’objectif utile consiste à limiter l’échec.
Un système gouverné peut retirer l’autorité, calculer l’impact et restaurer l’état. Il ne dépend pas d’un modèle parfait, d’une interprétation parfaite du prompt ou d’un comportement parfait de toutes les dépendances.
C’est précisément ce qui permet d’accorder davantage d’autonomie avec un risque mesuré. Lorsque l’impact est limité, l’arrêt rapide et la récupération ordinaire, les équipes peuvent avancer sans prétendre que la prévention fonctionnera toujours.
La question n’est donc plus seulement :
« Peut-on faire confiance à cet agent ? »
Il faut aussi demander :
« Si cette confiance s’avère mal placée, peut-on le contenir ? »
Cette seconde question a une réponse d’ingénierie : architecture, contrôles et preuves.
Prochaine partie : Traçabilité : qui, ou quoi, a écrit cette ligne de code ?
Publié initialement par Reza Arani sur Medium le 1er juin 2026. Adapté pour Aipolix comme sixième partie de la série AI Governance in an AI-Native Software Development Company.
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter.
Laisser un commentaire