
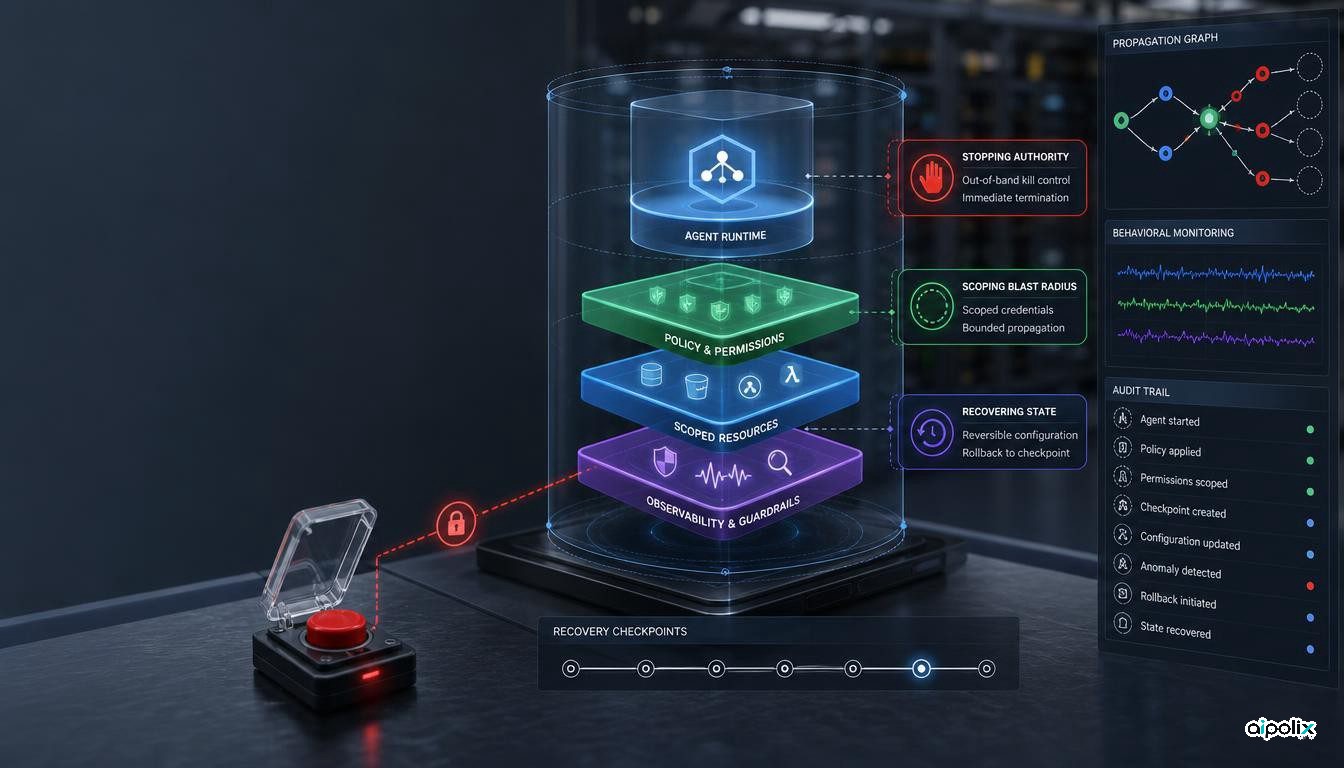
A maioria dos programas de governação de IA investe sobretudo na prevenção: melhores prompts, políticas mais restritivas, permissões mais limitadas e mais revisão.
Tudo isso é necessário. Não chega.
Quando um agente pode alterar estado, chamar ferramentas, gastar dinheiro, mudar configuração, produzir código ou acionar outros sistemas, a governação também precisa de prever o momento em que a prevenção falha. A pergunta passa a ser operacional: o ambiente de execução consegue parar a ação, determinar exatamente o que foi afetado e recuperar um estado seguro?
Este é o sexto artigo da série de dez partes AI Governance in an AI-Native Software Development Company. O artigo 5, AI Agents Need Contracts, Not Better Prompts, definiu o contrato que limita a autoridade do agente. Este artigo parte de uma hipótese menos confortável: o sistema pode sair desse contrato, ou pode produzir um resultado errado mesmo estando tecnicamente dentro dele.
É aqui que começa a contenção.
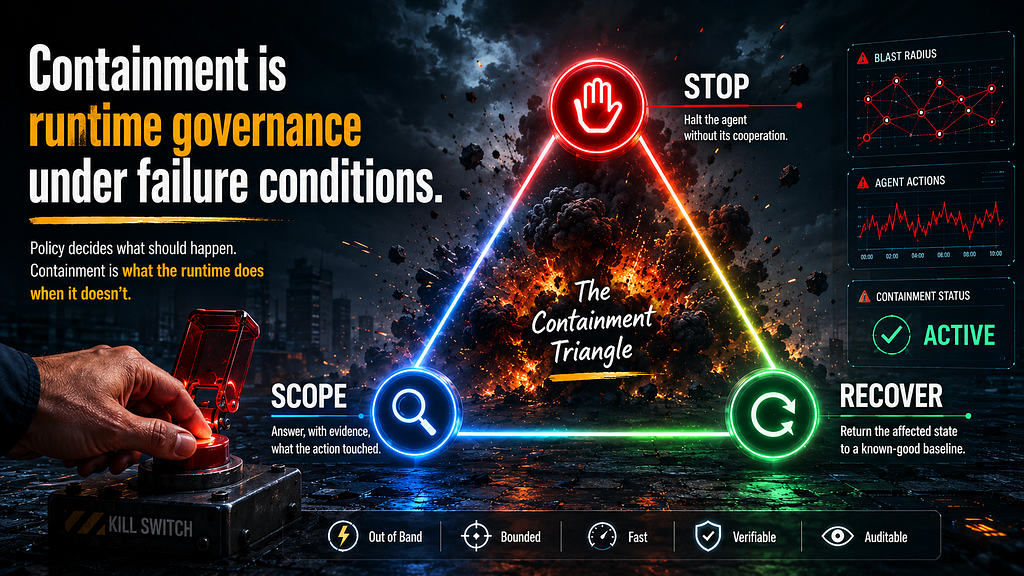
A prevenção reduz a probabilidade. A contenção limita a consequência.
A contenção tem de existir no ambiente de execução
É comum tratar a contenção como parte da resposta a incidentes. Nessa altura já é tarde.
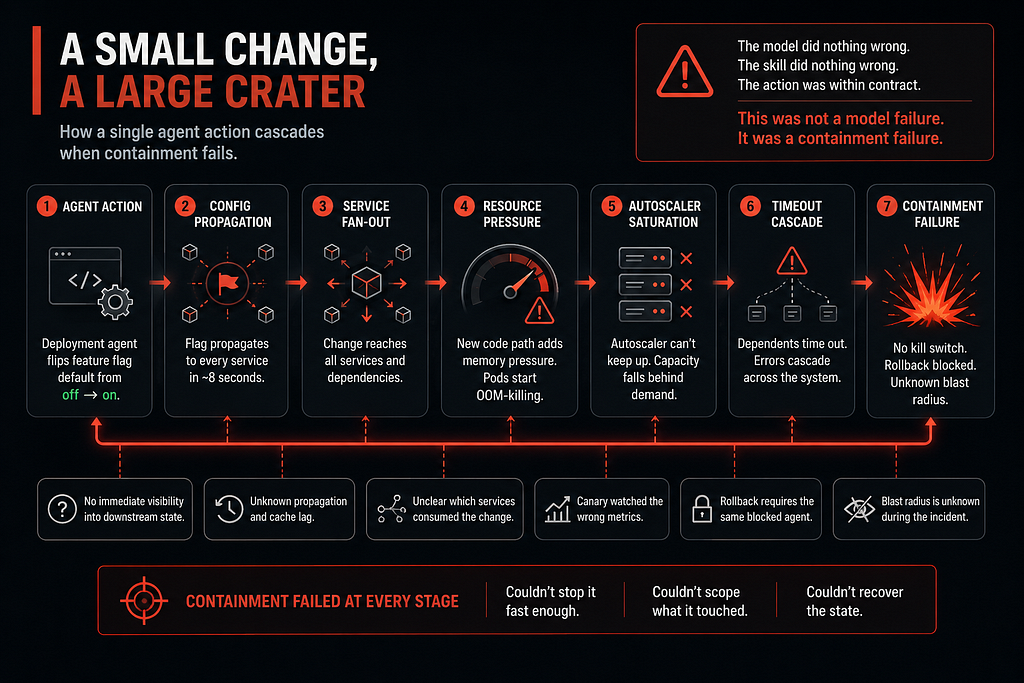
Se a primeira discussão séria sobre como parar um agente acontece durante o incidente, a equipa está a improvisar. Um ambiente de execução governado precisa de mecanismos de contenção antes da primeira falha, porque sistemas autónomos conseguem agir mais depressa e propagar uma decisão muito mais longe do que um operador humano.
Uma interpretação errada pode transformar-se em dezenas de chamadas a ferramentas. Uma alteração de configuração pode propagar-se a serviços dependentes. Uma permissão aparentemente limitada pode abrir uma superfície de ação muito maior do que o nome sugere. Um processo automático pode continuar a repetir tentativas muito depois do momento em que a decisão inicial devia ter sido revista.
Um desenho útil de contenção começa com três perguntas:
- Conseguimos parar a ação sem depender da cooperação do agente?
- Conseguimos provar o que foi afetado?
- Conseguimos repor o sistema num estado seguro e conhecido?
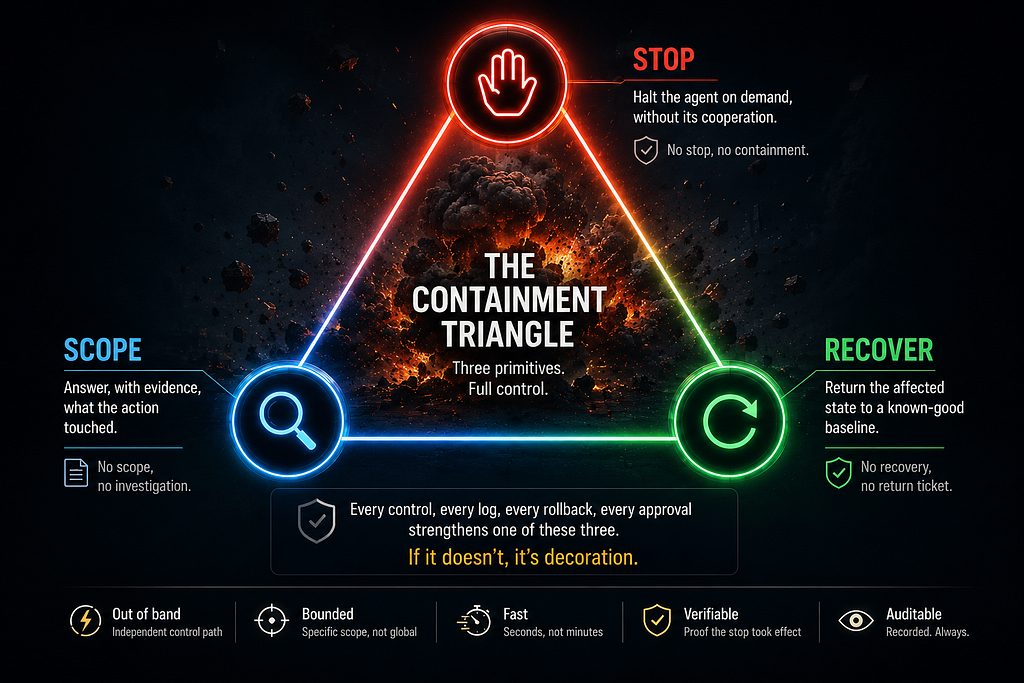
Estas três capacidades podem ser resumidas em PARAR, DELIMITAR, RECUPERAR.
Um sistema sem uma delas não está totalmente governado. Pode ser observável, mas observar os danos depois de acontecerem não é contenção.
PARAR: a autoridade tem de poder ser retirada de fora
Um mecanismo real de paragem não pode depender de o agente decidir obedecer-lhe.
O caminho de controlo deve estar separado do caminho de execução. Também deve ser seletivo. Parar um agente, uma ferramenta, um cliente ou uma capacidade é muito diferente de desligar toda a plataforma.
É útil distinguir vários mecanismos:
- pausa, quando a situação é ambígua e pode haver retoma;
- redução de âmbito, quando o sistema deve continuar com menos ferramentas ou privilégios;
- quarentena, quando a produção de resultados pode continuar, mas esses resultados não devem chegar a produção;
- corte completo, quando execução e autoridade têm de terminar imediatamente.
Em sistemas distribuídos, revogar credenciais é frequentemente um dos mecanismos mais fortes. Credenciais de curta duração, concessões renováveis e tokens com âmbito restrito criam pontos de controlo fora do ciclo de decisão do modelo.
A pergunta certa deixa de ser “o agente vai lembrar-se de parar?” e passa a ser “a infraestrutura consegue retirar-lhe a capacidade de agir?”.
DELIMITAR: o raio de impacto tem de ser conhecido antes do incidente
A contenção depende de perceber o impacto.
Para um operador humano, dizer que “esta ferramenta pode editar configuração” pode parecer informação suficiente. Para um agente autónomo, é incompleto. O ambiente de execução precisa de saber até onde uma ação pode propagar-se.
O raio de impacto pode ser classificado a partir de dimensões concretas:
- número de registos, serviços, clientes ou utilizadores afetados;
- sistemas a jusante que podem herdar a alteração;
- reversibilidade da ação;
- duração do efeito;
- probabilidade de o problema ser visível para monitorização e operadores.
O modelo de classificação exato é menos importante do que tornar a fronteira explícita.
Uma ação de baixo impacto pode avançar automaticamente. Uma ação intermédia pode exigir mais evidência ou execução faseada. Uma ação de alto impacto pode exigir aprovação humana assinada. Algumas ações de consequência catastrófica podem simplesmente ficar fora das capacidades disponíveis ao agente.
É aqui que a governação se torna sensível ao estado real do sistema. A mesma intenção pode ser aceite num contexto e recusada noutro porque as consequências possíveis são diferentes.
RECUPERAR: alterações produzidas por agentes têm de ser reversíveis
As equipas de engenharia já conhecem rollback para código e deployments. As ações de agentes tornam o problema mais complexo.
Um commit pode ser reversível enquanto o prompt, a skill, a regra de encaminhamento ou o conjunto de políticas que o produziu já mudou. Um agente também pode executar muitas pequenas alterações, cada uma reversível isoladamente, mas difíceis de reconstruir em conjunto.
A regra deve ser simples:
- se o agente consegue criar uma alteração, a plataforma deve saber anulá-la;
- se consegue promovê-la, a plataforma deve saber recuá-la;
- se consegue propagar uma ação, a recuperação tem de cobrir essa propagação.
O rollback também tem de ser ensaiado. Um caminho de recuperação que existe apenas em documentação é uma hipótese, não um controlo.
A operação de recuperação deve produzir evidência com a mesma qualidade da ação inicial: quem a iniciou, o que foi revertido, que versão foi restaurada e que sistemas foram confirmados como saudáveis no final.
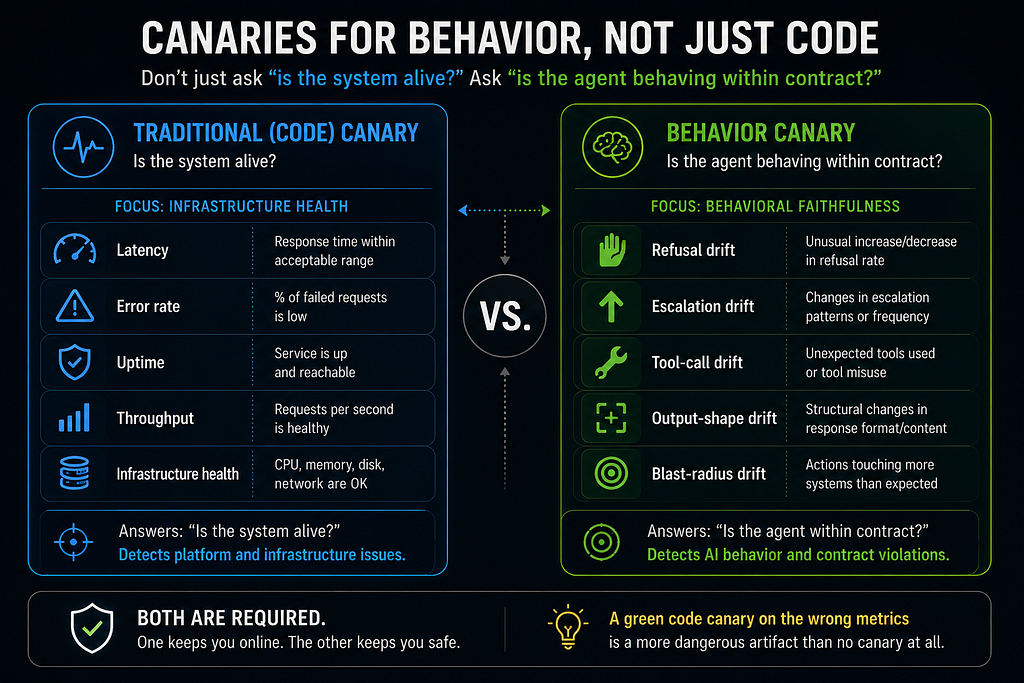
Os canários comportamentais são tão importantes como a saúde do serviço
Um canário tradicional responde sobretudo à pergunta: o software continua vivo?
Num sistema de agentes, há outra pergunta: o comportamento continua dentro do esperado?
Uma mudança de modelo, prompt, skill, fonte de recuperação de informação ou estrutura de uma ferramenta pode alterar decisões sem causar erro HTTP nem aumento de latência. O processo pode estar saudável enquanto o comportamento se desvia.
Por isso, um canário comportamental deve observar, por exemplo:
- taxa de recusas;
- taxa de escaladas;
- distribuição de chamadas a ferramentas;
- padrões de acesso inesperados;
- violações do formato de saída;
- alterações nas classes habituais de raio de impacto;
- qualidade da evidência produzida.
O objetivo não é criar uma linha de base perfeita. É tornar visíveis alterações importantes antes de se transformarem em incidentes.
A dívida de contenção é dívida operacional
As equipas acumulam dívida de contenção sempre que contornam um controlo temporariamente e depois não o repõem.
Os exemplos são familiares: rollback que não é ensaiado há meses, permissão de emergência que se tornou permanente, mecanismo de corte que nunca foi testado, credenciais que nunca rodam ou uma exceção que só existe na memória de alguém.
Cada atalho reduz a margem de reação da organização.
O custo raramente aparece em operação normal. Surge durante o incidente, através de interrupções mais longas, maior incerteza e recuperação mais lenta.
Os controlos de contenção devem, por isso, ser tratados como ativos operacionais com responsável, testes e datas de revisão.
Ordem prática de implementação
Não é preciso construir uma plataforma nova para começar.
Escolha a capacidade autónoma com maior consequência potencial e torne três coisas explícitas: como é parada, como se calcula o impacto possível e como se recupera o estado depois da ação.
Depois:
- implemente um caminho de paragem fora do fluxo principal;
- classifique o raio de impacto nas ferramentas e skills;
- associe ações de maior impacto a requisitos de aprovação mais fortes;
- implemente e ensaie rollback para uma classe de alteração produzida por agentes;
- adicione canários comportamentais às alterações de modelo, prompt, skill e ferramenta;
- exercite paragem, delimitação e recuperação fora de incidentes;
- registe todas as exceções e dê-lhes uma data de fim.
Esta sequência é deliberadamente operacional. A governação melhora quando os controlos podem ser executados e testados, não quando existem apenas num diagrama de arquitetura.
Conclusão
O objetivo da governação de IA não é provar que um agente nunca fará uma escolha errada.
Esse padrão é impossível.
O objetivo útil é limitar a falha.
Um sistema governado consegue retirar autoridade, calcular impacto e recuperar estado. Não depende de um modelo perfeito, de uma interpretação perfeita do prompt ou de todas as dependências funcionarem sempre da forma esperada.
É isso que permite dar mais autonomia com risco medido. Quando o impacto é pequeno, a paragem é rápida e a recuperação é rotina, as equipas podem assumir riscos controlados sem fingir que a prevenção vai funcionar sempre.
A pergunta importante já não é apenas:
“Podemos confiar neste agente?”
É também:
“Se essa confiança estiver errada, conseguimos contê-lo?”
A segunda pergunta tem uma resposta de engenharia: arquitetura, controlos e evidência.
Próximo artigo: Rastreabilidade: quem, ou o quê, escreveu esta linha de código?
Publicado originalmente por Reza Arani no Medium em 1 de junho de 2026. Adaptado para Aipolix como sexto artigo da série AI Governance in an AI-Native Software Development Company.
Comentários
Ainda não há comentários. Seja o primeiro a comentar.
Deixe um comentário