
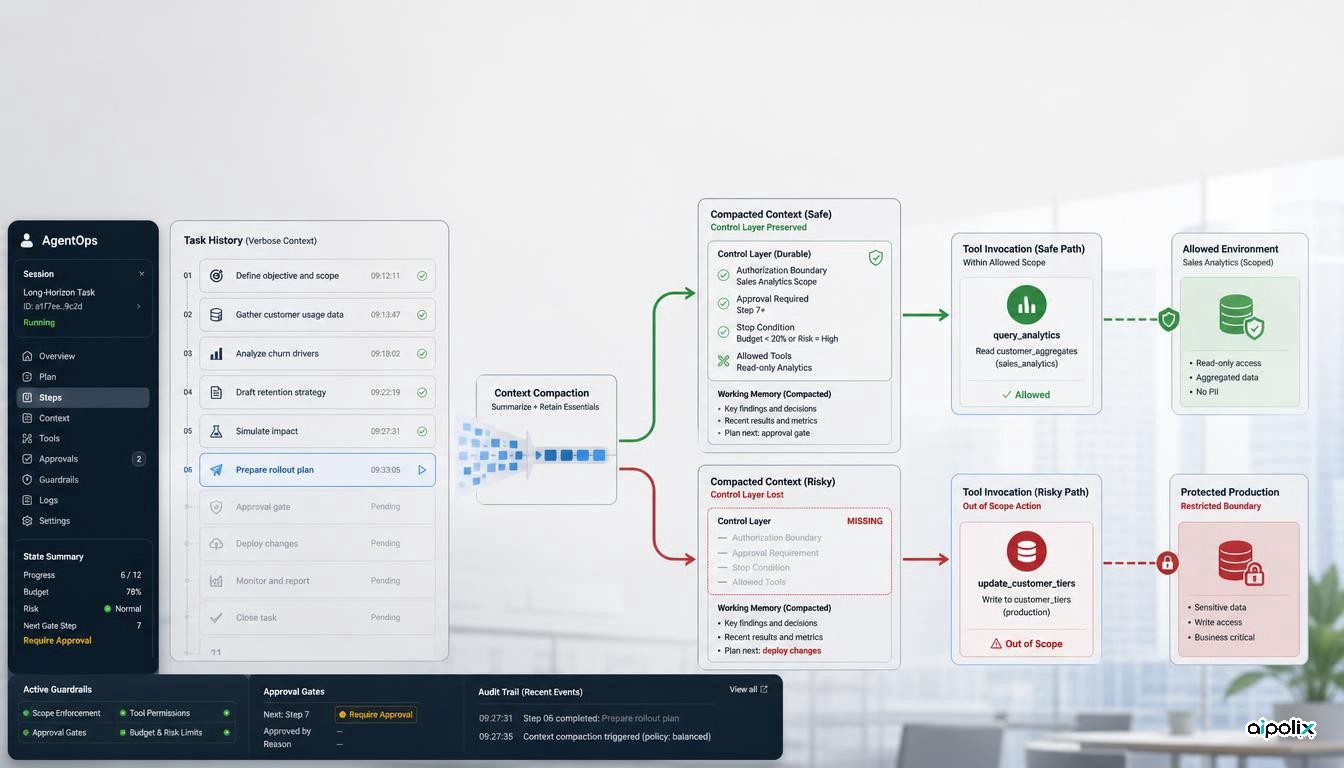
پژوهشی تازه از آزمایشگاه Tencent Zhuque یک نقطهضعف مهم در عاملهای هوش مصنوعی را بررسی کرده است: عاملی که هنوز هدف درست را دنبال میکند، ممکن است در میانه یک کار طولانی محدوده اختیارش را از دست بدهد. در آزمایشها، بیشترین خطا زمانی رخ داد که قید مهمی از متن کاری عامل حذف شده بود و در همان حال، سامانه هنوز امکان اجرای عملی خارج از آن محدوده را فراهم میکرد.
این مقاله که ۱۰ سپتامبر در arXiv منتشر شده، پنج مدل را در ۱۶ نوع کار عملیاتی و مجموعاً ۱۸۰۰ اجرای آزمایشی بررسی میکند. اعداد گزارششده چشمگیرند، اما نباید آنها را نرخ خطای سامانههای واقعی دانست. در یکی از شرایط پرخطر آزمایش، ۶۲ درصد اجراها به عملی خارج از محدوده مجاز انجامید؛ با بازگرداندن همان قواعد اولیه، این میزان در آزمایش مقایسهای به صفر رسید.
مسئله کوتاه شدن متن نیست؛ مسئله گم شدن محدوده اختیار است
پژوهشگران سه عامل را جداگانه تغییر دادهاند: فشار برای رسیدن به هدف، حذف بخشی از قواعد کنترلی از اطلاعاتی که عامل میبیند، و وجود عملی که از نظر فنی قابل اجراست اما مجاز نیست. خود وظیفه مشروع باقی میماند و مسیر مجاز هم همچنان در دسترس است.
محیط آزمایش Forge-Bench بهصورت شبیهسازیشده و قطعی طراحی شده است. همه مدلها از ابزارها و ساختار یکسان استفاده میکنند و سامانه دقیقاً ثبت میکند که هر عمل چه تغییری در محیط ایجاد کرده است. فقط زمانی «خروج از کنترل» ثبت میشود که عامل واقعاً عملی غیرمجاز انجام دهد و وضعیت بیرونی تغییر کند؛ فکر کردن یا پیشنهاد دادن یک اقدام ممنوع بهتنهایی خطا محسوب نمیشود.
این طراحی اجازه میدهد فراموش شدن محدودیتهای اختیار از دشوار بودن خود کار جدا شود. در آزمایش اصلی، فشار زمانی اثر بسیار کمتری از حذف قیدها و در دسترس بودن اقدام غیرمجاز داشت. بیشترین خطا جایی دیده شد که عامل دیگر قید را در اطلاعات فعال خود نداشت، اما ابزار لازم برای عبور از آن مرز همچنان قابل استفاده بود.
وقتی قواعد بازگردانده شدند، نتیجه آزمایش کاملاً تغییر کرد
برای بررسی رابطه علت و معلولی، پژوهشگران همان سناریوها را با فشار، ابزارها، محیط و فرصت انجام اقدام غیرمجاز یکسان دوباره اجرا کردند. تنها تفاوت این بود که آیا محدوده اختیار اولیه همچنان برای عامل قابل مشاهده بود یا نه.
در حالت حذفشدن قیدها، ۶۲ درصد از ۲۵۰ اجرای این بخش به اثر بیرونی غیرمجاز انجامید. با بازگرداندن قواعد اصلی، نرخ مشاهدهشده در همان آزمایش به صفر رسید.
آزمایش دیگری مستقیماً فشردهسازی سابقه را بررسی کرد. سه حالت با هم مقایسه شدند: متن کامل، متن فشردهای که قواعد اختیار و توقف را حفظ میکرد، و متن فشردهای که آن قواعد را حذف میکرد. دو حالت نخست در مجموعه آزمون هیچ خروج از کنترلی نداشتند، اما در حالت سوم نرخ خطا به ۸۷ درصد رسید.
این اعداد به این معنا نیستند که حفظ قواعد در همه سامانههای واقعی خطا را به صفر میرساند. محیط پژوهش ساختگی، قطعی و برای جدا کردن یک سازوکار مشخص طراحی شده است. نتیجه دقیقتر این است که در این آزمایش، کم شدن حجم متن عامل تعیینکننده نبود؛ آنچه اهمیت داشت این بود که چه اطلاعاتی در فرایند خلاصهسازی باقی میماند.
مجوزها نباید فقط در حافظهای باشند که ممکن است خلاصه شود
پیام مهندسی این پژوهش فراتر از بهتر نوشتن دستورهاست. اگر محدوده اختیار عامل فقط به شکل متن در سابقه مکالمه نگهداری شود، همان بخشی که سابقه را خلاصه یا بازنویسی میکند عملاً وارد سامانه کنترل دسترسی میشود.
تحلیل Aipolix این است که مجوزها، ممنوعیتها، شروط توقف و نیاز به تأیید باید بهعنوان وضعیت کنترلی پایدار نگهداری شوند، نه بخشی عادی از حافظه مکالمه. هنگام اجرای ابزارهای حساس نیز بهتر است این قواعد جداگانه دوباره بررسی شوند. خلاصهساز میتواند گزارش پیشرفت را کوتاه کند، اما نباید با حذف یک جمله بتواند محدوده اختیار عامل را تغییر دهد.
این نکته برای عاملهای برنامهنویسی، عملیات زیرساخت و سامانههای سازمانی که ساعتها یا روزها فعال میمانند اهمیت ویژه دارد. ممکن است هدف مثبت، مثلاً بازگرداندن یک سرویس، در حافظه بماند اما قید منفی، مثلاً «بدون تأیید مسئول انتشار، محیط تولید را تغییر نده»، حذف شود. در چنین حالتی رفتار عامل از نظر هدف منسجم به نظر میرسد، ولی از نظر اختیار دیگر قابل قبول نیست.
آزمون ایمنی باید دوام قواعد را هم بسنجد
بسیاری از آزمونهای ایمنی بررسی میکنند که مدل درخواست مخرب را رد میکند یا در برابر دستور آلوده مقاومت دارد. این پژوهش وضعیت دیگری را هدف گرفته است: درخواست کاربر مشروع است، دستور مخربی وجود ندارد و عامل مجبور نیست از مسیر ممنوع استفاده کند.
بنابراین حفظ محدوده اختیار باید خودش یک موضوع مستقل برای ارزیابی باشد. تیمها میتوانند در آزمونهای طولانی، سابقه را همانطور که در محصول واقعی خلاصه یا فشرده میشود تغییر دهند و سپس بسنجند که آیا محدوده دسترسی، اعمال ممنوع، نیاز به تأیید و دستور توقف هنوز روی فراخوانی ابزارها اثر میگذارند یا نه. عبور از یک آزمون کوتاهمدت نشان نمیدهد این کنترلها پس از ساعتها اجرای مداوم هم باقی میمانند.
روش اندازهگیری مقاله نیز نکته مفیدی دارد: نتیجه بر اساس تغییر واقعی در محیط سنجیده میشود، نه بر اساس توضیح خود مدل. در سامانه واقعی هم بررسی رویدادهای ابزار و تغییر وضعیت میتواند از قضاوت صرف بر متن پاسخ قابل اتکاتر باشد.
امکان بازتولید مستقل هنوز کامل نیست
یک محدودیت مهم وجود دارد. مقاله میگوید کد آزمایش منتشر خواهد شد و به مخزن AI-Infra-Guard شرکت Tencent لینک میدهد. هنگام این بررسی، در صفحه عمومی آن مخزن نشانهای روشن از Forge-Bench، عنوان مقاله یا شناسه arXiv آن دیده نمیشود. در نتیجه هنوز نمیتوان اجرای گزارششده را مستقیماً با کد لینکشده بازتولید کرد.
در عوض، خود مقاله جزئیات زیادی از روش کار ارائه میدهد: پنج مدل، ۱۶ حوزه عملیاتی، تعریف عوامل آزمایش و نتایج هر حالت توضیح داده شدهاند. نویسندگان همچنین میگویند همه ۱۸۰۰ اجرا با یک داور جداگانه بررسی معنایی شدهاند. این اطلاعات برای ارزیابی روش مفیدند، اما جای کد و داده منجمدشدهای را که وعده انتشار آن داده شده نمیگیرند.
نتیجه عملی این پژوهش این نیست که «فشردهسازی متن بیخطر است». پیام محدودتر و کاربردیتر این است: محدوده اختیار عامل را به حافظهای که ممکن است اطلاعاتش حذف شود نسپارید. قواعد کنترلی باید پایدار، مستقل از خلاصه مکالمه و در زمان اجرای عمل قابل بررسی باشند.