
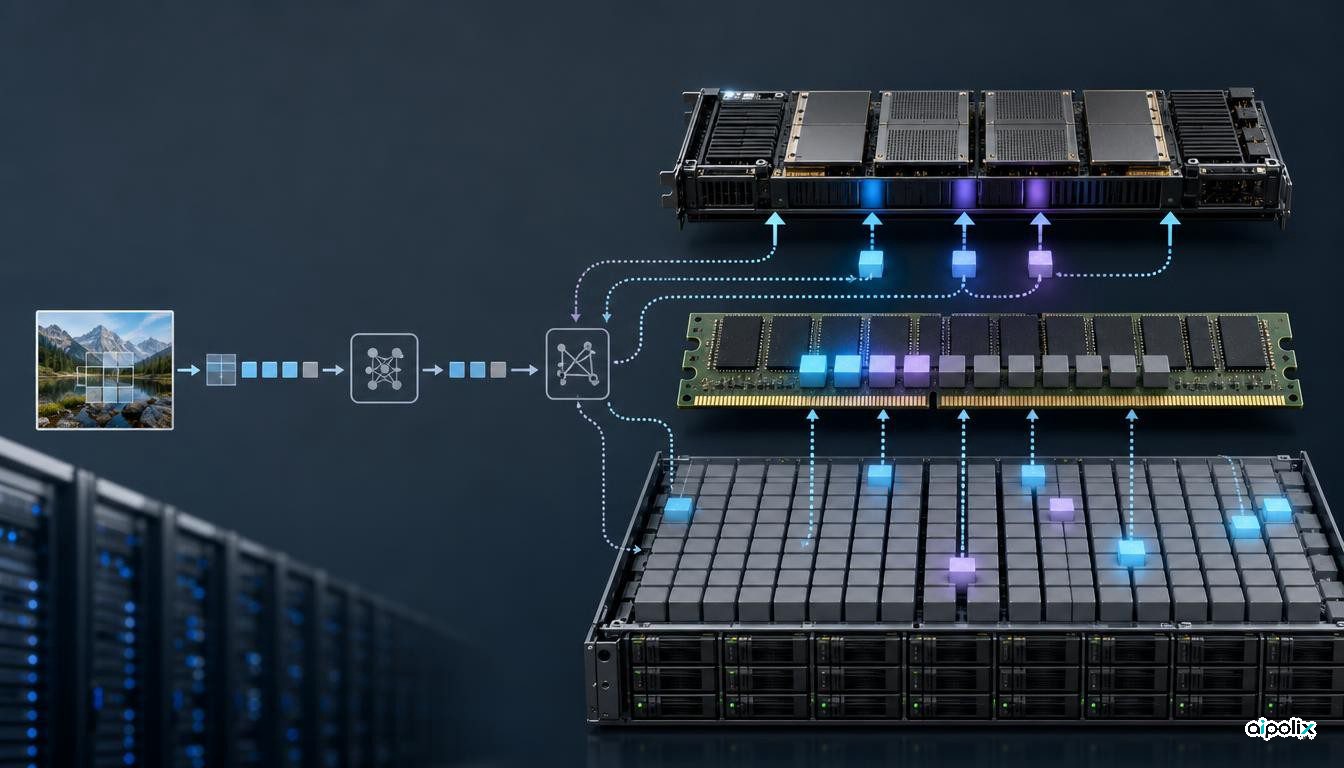
نسخه ۱.۱۱.۰ پروژه متنباز Colibrì پشتیبانی مستقیم از DeepSeek V4.1 Flash را اضافه کرده است. نتیجه این است که یک مجموعه وزنهای حدود ۵۱۰ گیگابایتی میتواند بدون تبدیل کامل وزنهای منتشرشده، روی سیستمی متکی به CPU و SSD اجرا شود. موتور Colibrì وزنهای متراکم fp8 و زیرشبکههای متخصصِ fp4 را در همان قالب اصلی میخواند و بخش بزرگی از مدل ۵۵۲ میلیاردپارامتری را روی فضای ذخیرهسازی نگه میدارد؛ فقط دادهای که برای هر توکن لازم است به لایههای سریعتر حافظه آورده میشود.
اهمیت این کار در این نیست که ناگهان چنین مدلی در حافظه عادی «جا میشود». Colibrì مسئله را طور دیگری حل میکند: ذخیرهسازی، RAM و حافظه شتابدهنده را یک سلسلهمراتب واحد در نظر میگیرد و از پراکندگی ساختار MoE استفاده میکند تا فقط بخش فعال مدل را در لحظه لازم بخواند.
این روش اجرای مدلی را ممکن میکند که در VRAM معمولی جا نمیشود، اما اعداد خود پروژه یک محدودیت مهم را هم روشن میکنند: اجراشدن با سریعبودن یکی نیست.
وزنها بدون تبدیل کامل خوانده میشوند
DeepSeek V4.1 Flash یک مدل Mixture-of-Experts با ۵۵۲ میلیارد پارامتر است. مستند فنی Colibrì مجموعه وزنهای آن را تقریباً به سه بخش تقسیم میکند: ۲۰۳ گیگابایت جدولهای Engram، حدود ۲۸۹ گیگابایت زیرشبکههای متخصصِ مسیریابیشونده و نزدیک ۱۸ گیگابایت وزنهای متراکم، بردارهای نهفته و بخش بینایی.
در نسخه ۱.۱۱.۰، فرمتهای fp8 و fp4 منتشرشده مستقیماً خوانده میشوند. پروژه میگوید چیدمان بایتهای زیرشبکههای متخصص با مسیری که پیشتر برای Kimi K3 استفاده میکرد سازگار است. در نتیجه، کاربر لازم نیست صدها گیگابایت وزن را پیش از اجرا به قالب اختصاصی دیگری تبدیل کند.
البته یک مرحله آمادهسازی کوچک باقی میماند. اسکریپت پروژه چند جدول جانبی میسازد که محاسبه آنها هنگام بارگذاری بهصرفه نیست؛ از جمله نگاشت توکنها و پارامترهای هش مربوط به Engram. مستندات توضیح میدهند که بعضی ضریبهای هش عمداً بهشکل رشته عددی ذخیره میشوند، چون گردکردن آنها در قالب ممیز شناور میتواند n-gram را بیسروصدا به ردیف دیگری بفرستد.
این جزئیات نشان میدهند موضوع فقط صرفهجویی در حافظه نیست. وقتی وضعیت مدل از دیسک جریان پیدا میکند، چیدمان فایل، هش، مالکیت کش و نحوه بازگرداندن وضعیت هم بخشی از مرز صحت اجرا میشوند.
پروژه فقط «خروجی گرفتن» را معیار صحت نمیداند
طبق گزارش تغییرات، موتور DeepSeek V4.1 Flash در چند ظرفیت متفاوت کش و در حالتهای مختلف رمزگشایی گمانهزن، توکنبهتوکن با یک پیادهسازی مرجع مستقل مبتنی بر PyTorch روی CPU مقایسه میشود. مسیر بینایی نیز با تحمل عددی مشخص سنجیده شده است.
این آزمون از یک نمایش ساده که فقط نشان دهد مدل متن تولید میکند ارزش بیشتری دارد. Colibrì زمان و محل خواندن وضعیت مدل را تغییر میدهد؛ بنابراین خطا در مسیریابی، مالکیت نمایه یا بازگرداندن وضعیت پس از رد یک پیشبینی میتواند خروجی ظاهراً معقولی بسازد اما دیگر با اجرای ترتیبی مدل برابر نباشد.
در DSpark چند توکن پیشنهادی ابتدا تولید و سپس دوباره با مدل اصلی بررسی میشوند. اگر بخشی از پیشبینی رد شود، وضعیت وابسته به موقعیت باید به حالت قبلی برگردد. پروژه همچنین آزمایشهایی را که کندتر بودهاند مستند کرده و کنار گذاشته است، نه اینکه فقط نتیجههای موفق را منتشر کند.
این آزمونها کیفیت کلی DeepSeek یا آمادگی Colibrì برای محیط تولید را بهطور مستقل ثابت نمیکنند. چیزی که مستند میشود محدودتر و دقیقتر است: مسیر بهینهشده باید معنای محاسباتی مدل را حفظ کند، هرچند محل نگهداری و زمان خواندن وزنها تغییر کرده باشد.
بعد از حل ظرفیت، پهنایباند ذخیرهسازی گلوگاه میشود
Colibrì برآورد میکند که برای هر توکن DeepSeek V4.1 Flash ممکن است حدود ۴.۵ گیگابایت داده داده زیرشبکههای متخصص خوانده شود. در مقابل، جدولهای Engram با وجود حجم ۲۰۳ گیگابایتی، در هر توکن فقط تعداد محدودی خواندن تصادفی کوچک دارند. همین تفاوت توضیح میدهد چرا نگهداشتن بخش بزرگتری از مجموعه وزنها روی دیسک ممکن است و در عین حال چرا مسیر ذخیرهسازی هنوز روی سرعت اثر تعیینکننده دارد.
در گزارش تغییرات آمده است که در یک آزمون سرد روی مجموعه وزنهای منتشرشده، زمان یک نوبت در طول توسعه از ۷۸.۷ ثانیه به ۲۵.۱ ثانیه رسیده و نرخ از ۰.۳۰۵ به ۰.۹۵۷ توکن بر ثانیه افزایش یافته است. برای یک گفتوگوی پنجنوبتی نیز نرخ ۱.۱۴ تا ۱.۵۸ توکن بر ثانیه گزارش شده است. اینها اندازهگیریهای خود پروژهاند و نباید به سختافزارهای دیگر تعمیم داده شوند.
یک آزمایش جداگانه در مستند فنی، روی سرور ۱۶ رشتهای که ۶۸ درصد زیرشبکههای متخصص را در حافظه سریعتر نگه میداشت، نشان میدهد رمزگشایی گمانهزن در یک بار کاری سرد ۲۴ توکنی نرخ را از ۰.۲۰۶ به ۰.۲۴۲ توکن بر ثانیه رسانده است. نویسندگان همانجا هشدار میدهند که گرمبودن کش صفحههای سیستمعامل میتواند از خود بهینهسازی نرمافزاری اثر بیشتری داشته باشد.
پس نتیجه مهم این نیست که اجرای محلی حالا به تأخیر سرویسهای ابری رسیده است. نکته این است که پس از حل مشکل ظرفیت با خواندن مرحلهای از دیسک، بودجه اصلی به ورودیوخروجی منتقل میشود: پهنایباند SSD، تأخیر خواندنهای تصادفی، وضعیت کش و تعداد زیرشبکههای متخصصیی که میتوان در حافظه سریع نگه داشت.
«اجرای محلی» دیگر فقط سؤال ظرفیت VRAM نیست
بحث اجرای محلی معمولاً با این سؤال شروع میشود که آیا مدل در حافظه GPU جا میشود یا نه. معماری Colibrì نشان میدهد برای مدلهای تنک این تعریف محدودکننده است.
میتوان بخشهای متراکم را در حافظه نگه داشت، زیرشبکههای متخصصی پرمصرف را کش کرد و SSD را لایه سرد در نظر گرفت. برای آزمایش، تحلیل آفلاین یا محیطی که کنترل محلی مهمتر از پاسخ آنی است، این روش دامنه سختافزار قابلاستفاده را واقعاً گسترش میدهد.
اما در عوض، رفتار عملی سیستم وابستگی بیشتری به بار کاری پیدا میکند. محبوبیت زیرشبکههای متخصص و گرمبودن کش بر سرعت اثر میگذارند. خرابی یا ناقصبودن داده روی دیسک باید صریحاً کنترل شود. مقایسه عملکرد بدون یکسانکردن وضعیت کش قابل اعتماد نیست. و سیستمی که از نظر فنی مدل را اجرا میکند ممکن است برای عامل تعاملی بیش از حد کند باشد.
برداشت Aipolix این است که نسخه ۱.۱۱.۰ Colibrì مرز اصلی را از «آیا وزنها جا میشوند؟» به «آیا سلسلهمراتب حافظه میتواند بخش فعال وزنها را با سرعت کافی تغذیه کند؟» منتقل میکند. برای مدلهای MoE بزرگ، این سؤال مهندسی کاربردیتری است.
نکتهای که توسعهدهنده باید از این انتشار بگیرد
این خبر را باید درباره سامانه استنتاج دید، نه درباره انتشار دوباره DeepSeek V4.1 Flash. Aipolix پیشتر خود مدل را پوشش داده است؛ اتفاق تازه این است که یک موتور اجرای متنباز مسیر مشخصی برای اجرای مجموعه وزنهای اصلی ارائه کرده است.
برای ارزیابی چنین ابزاری، تعداد ستارههای GitHub یا صرفاً بالا آمدن مدل معیار کافی نیست. مقایسه توکنبهتوکن با مرجع، سرعت در حالت سرد و گرم، پهنایباند دیسک، رفتار کش، تقسیم وزنها میان RAM و VRAM و تأخیری که در بار کاری واقعی حاصل میشود مهمترند.
Colibrì برای بخش زیادی از این پرسشها جزئیات قابلآزمایش منتشر کرده و محدودیتها را هم پنهان نکرده است. بعضی مسیرهای فرمان هنوز برای این خانواده مدل فعال نیستند، ثبت آمار هر نوبت اختیاری است و نتیجه عملکرد به سختافزار و وضعیت کش وابستگی زیادی دارد.
همین شفافیت ارزش فنی انتشار را بالا میبرد. Colibrì هزینه یک مدل ۵۱۰ گیگابایتی را حذف نمیکند؛ آن هزینه را از مسئله «ظرفیت حافظه» به مسئلهای قابلاندازهگیری در زمانبندی حافظه و ذخیرهسازی تبدیل میکند.