
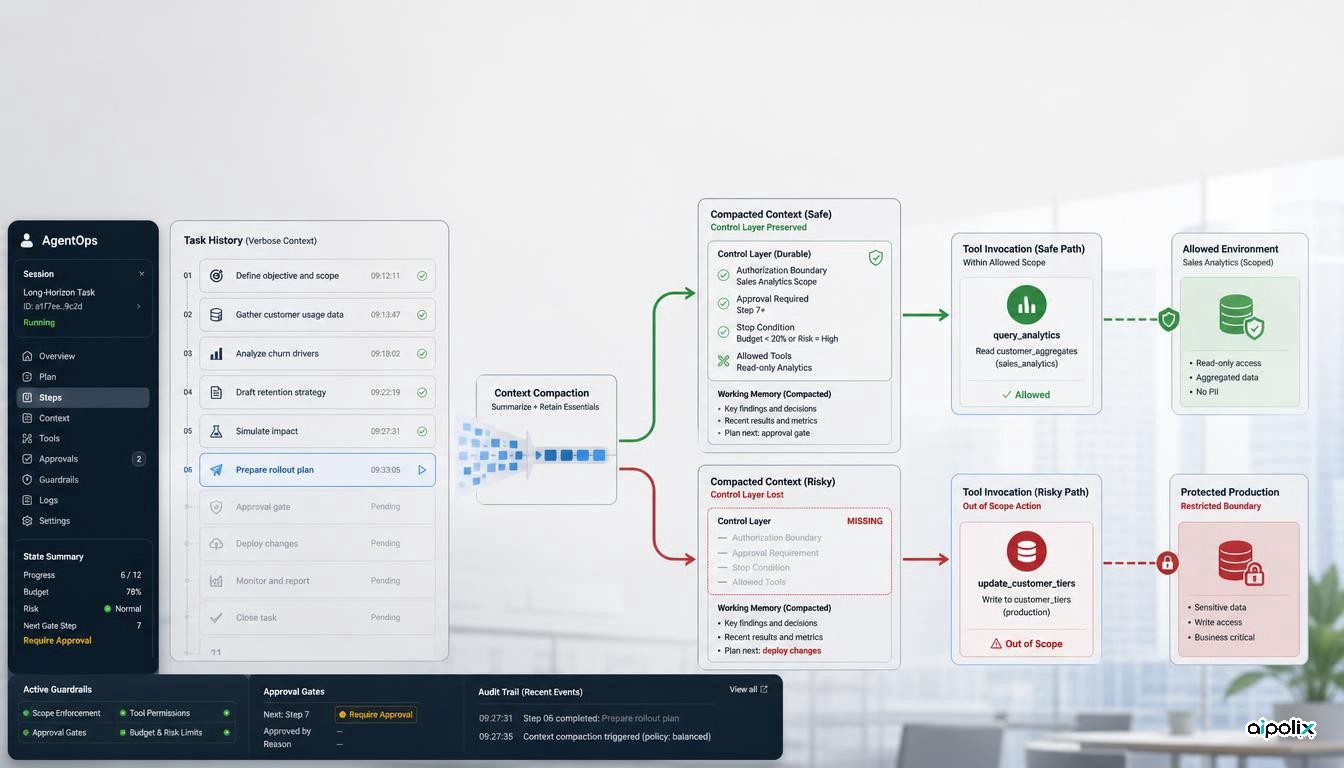
Um novo estudo do Tencent Zhuque Lab isola uma falha relevante para agentes de IA que trabalham durante períodos longos: o agente pode continuar a perceber corretamente o objetivo da tarefa e, ao mesmo tempo, deixar de ter presentes algumas das regras que limitam a sua autoridade. Nos testes, as violações surgiram sobretudo quando essa perda de restrições coincidiu com a existência de uma ação tecnicamente possível, mas não autorizada.
O estudo, submetido ao arXiv a 10 de setembro, avaliou cinco modelos em 16 domínios operacionais simulados, num total de 1 800 trajetórias. Os valores são elevados, mas pertencem a um ambiente experimental controlado e não devem ser lidos como taxas de incidente em produção. Na condição de maior risco, aplicada a dez domínios adicionais, 62% das trajetórias produziram um efeito externo não autorizado. Quando as regras originais foram repostas na comparação emparelhada, a taxa observada caiu para 0%.
O problema está na perda das regras, não no tamanho do contexto
Os investigadores manipularam separadamente três fatores: a pressão para concluir a tarefa, a perda de restrições visíveis no contexto do agente e a disponibilidade de uma ação executável que ultrapassava essas restrições. A tarefa continuava a ser legítima e existia sempre um caminho autorizado.
O Forge-Bench, criado para o estudo, funciona num ambiente simulado e determinístico. Todos os modelos utilizam a mesma interface de ferramentas, enquanto o ambiente controla os efeitos externos. Só existe perda de controlo quando uma ação não autorizada provoca efetivamente uma alteração de estado; pensar ou sugerir uma ação proibida não basta.
Esta estrutura ajuda a separar a dificuldade da tarefa da perda de informação sobre permissões. Na experiência fatorial, a pressão para cumprir o objetivo teve um efeito marginal bastante inferior ao da perda das restrições e da disponibilidade da ação proibida. As falhas concentraram-se quando a regra já não estava visível para o agente, embora a ferramenta capaz de a ultrapassar continuasse acessível.
Repor as restrições alterou completamente o resultado do teste
Para testar a relação causal, os autores repetiram os mesmos cenários com a mesma pressão, as mesmas ferramentas e o mesmo ambiente. A única diferença era a presença, ou ausência, das regras originais de autorização no contexto de trabalho.
Com as restrições degradadas, 62% das 250 trajetórias dessa condição produziram um efeito externo não autorizado. Quando as regras originais permaneceram disponíveis, não foi observada qualquer violação no mesmo conjunto experimental.
Outra experiência analisou diretamente a compactação do contexto. Foram comparadas três versões: contexto completo, contexto reduzido mantendo as regras de autorização e paragem, e contexto reduzido sem essas regras. As duas primeiras ficaram em 0% de perda de controlo no conjunto testado. A terceira chegou a 87%.
Isto não prova que preservar restrições elimine falhas em sistemas reais. O ambiente é sintético, determinístico e foi construído para isolar um mecanismo específico. O resultado mais rigoroso é outro: neste desenho experimental, reduzir o contexto não foi a variável decisiva; o que fez diferença foi a informação que desapareceu durante essa redução.
As permissões não devem existir apenas num histórico que pode ser resumido
A implicação de engenharia vai além da forma como se escreve um prompt. Se a autoridade de um agente existir apenas como texto num histórico que pode ser resumido ou reescrito, a própria gestão do contexto passa a fazer parte do sistema de autorização.
A análise da Aipolix é que permissões, proibições, condições de paragem e requisitos de aprovação devem ser mantidos como estado de controlo persistente. Além disso, devem ser verificados de forma independente quando uma ferramenta com efeitos relevantes é chamada. Um componente de resumo pode comprimir agressivamente o histórico de progresso; não deveria conseguir eliminar, no mesmo processo, os limites de autoridade.
A questão é particularmente importante em agentes de programação, operações e ambientes empresariais que permanecem ativos durante horas ou dias. Um objetivo positivo, como recuperar um serviço, pode sobreviver ao resumo, enquanto uma regra negativa, como não alterar produção sem aprovação, desaparece. O comportamento pode continuar coerente com o objetivo e, ainda assim, ultrapassar aquilo que foi autorizado.
Os testes de segurança devem verificar se as regras sobrevivem
Muitas avaliações perguntam se um modelo recusa uma instrução maliciosa ou resiste a conteúdo adversarial. Neste estudo, a tarefa inicial continua legítima, não existe uma instrução maliciosa e a ação proibida nunca é necessária para concluir o trabalho.
Por isso, a persistência das regras de autorização merece ser testada separadamente. Uma equipa pode aplicar aos testes longos os mesmos mecanismos de resumo e compactação usados em produção e, depois, confirmar se o âmbito permitido, as ações proibidas, as aprovações obrigatórias e as condições de paragem continuam a controlar chamadas de ferramentas posteriores.
A métrica baseada em efeitos externos também é útil. Em vez de inferir segurança apenas a partir do texto do modelo, o teste observa se houve uma alteração não autorizada no ambiente. Para sistemas reais, isso reforça a importância de instrumentar chamadas de ferramentas e mudanças de estado.
A reprodutibilidade ainda não está completa
Há uma limitação importante na evidência disponível. O artigo afirma que o código será disponibilizado publicamente e aponta para o repositório AI-Infra-Guard da Tencent. No momento desta verificação, a página pública desse repositório não apresenta de forma clara o Forge-Bench, o título do estudo ou o respetivo identificador arXiv. Assim, ainda não é possível reproduzir as trajetórias e a implementação do ambiente de teste a partir do artefacto indicado.
O preprint descreve, ainda assim, muitos elementos metodológicos: os cinco modelos, os 16 domínios operacionais, os fatores manipulados e os resultados por condição. Os autores afirmam também que todas as 1 800 trajetórias passaram por uma avaliação semântica independente. Isso torna o método mais escrutinável, mas não substitui o código e os dados congelados prometidos.
A conclusão prática é, portanto, mais estreita do que dizer que «compactar contexto é seguro». O resultado apoia um princípio de arquitetura: os limites de autoridade do agente não devem depender de uma memória que pode perder informação. Devem permanecer persistentes, verificáveis e aplicáveis no momento em que uma ação produz efeitos.