
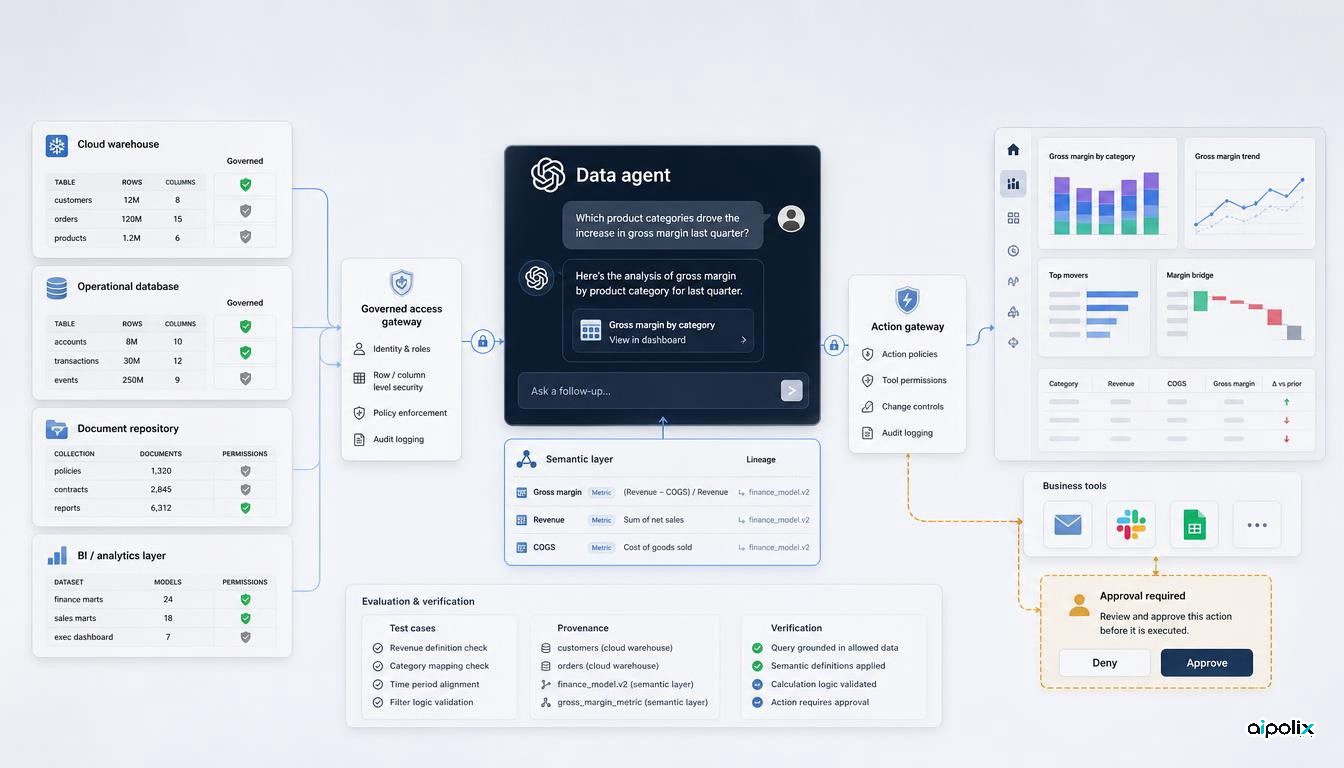
OpenAI عامل داده تازهای را در ChatGPT Work عرضه کرده است که به منابع مجاز سازمان وصل میشود، تغییر شاخصهای کسبوکار را بررسی میکند، داشبورد تعاملی میسازد و در صورت داشتن مجوز میتواند نتیجه تحلیل را به ابزارهای دیگر ببرد. در این طراحی، ChatGPT Work به جای ساختن یک مخزن داده تازه، روی سامانههایی قرار میگیرد که شرکت از قبل برای انبار داده، هوش تجاری و اسناد داخلی استفاده میکند.
جزئیات مهم، فقط تعداد اتصالها نیست. OpenAI میگوید درخواستها همان محدودیتهای حساب متصل را رعایت میکنند؛ از جمله محدودیت در سطح جدول، ردیف و ستون. عامل همچنین میتواند تعریف شاخصها، محاسبات و رابطههای دادهای سازمان را از لایههای معنایی و منابع مورد اعتماد دریافت کند. این ترکیب برای کنترل دسترسی لازم است، اما مسئله دیگری را حل نمیکند: آیا عامل شاخص درست را انتخاب کرده، دادهها را درست به هم پیوند داده و به نتیجه قابل اتکایی رسیده است یا نه.
عامل روی زیرساخت داده موجود کار میکند
در فهرست منابع پشتیبانیشده، Amazon Redshift، Datadog، Google BigQuery، ClickHouse، Databricks، MongoDB و Snowflake دیده میشوند. فایلها و اسناد نیز میتوانند از Google Drive و SharePoint وارد تحلیل شوند و نتیجه در ابزارهایی مانند Power BI، Tableau، ThoughtSpot، Sigma، Oracle BI و Omni به کار رود.
هدف این معماری آن است که شرکت مجبور نباشد همه اطلاعاتش را به یک محل تازه منتقل کند. عامل از سامانههای موجود زمینه میگیرد و کاربر میتواند با زبان طبیعی مسیر بررسی را تغییر دهد یا سؤالهای بعدی را مطرح کند. مدیران سازمان نیز تعیین میکنند چه اتصالهایی در دسترس چه نقشهایی باشند.
این تغییر، دسترسی به تحلیل را برای افراد بیشتری ممکن میکند. مدیر فروش یا محصول لازم نیست برای هر پرسش اول SQL بنویسد یا منتظر گزارش تیم داده بماند. اما آسان شدن پرسش، به معنی آسان شدن تضمین صحت پاسخ نیست.
کنترل دسترسی فقط یک بخش از حاکمیت داده است
مجوزها مشخص میکنند چه کسی حق دیدن یک ردیف یا ستون را دارد. اما تعیین نمیکنند «درآمد»، «ریزش مشتری» یا «کاربر فعال» دقیقاً در این سازمان چه تعریفی دارد، کدام منبع مرجع است یا آیا دو واحد شرکت از یک تعریف مشترک استفاده میکنند.
خود OpenAI نیز به این نیاز اشاره میکند: عامل میتواند از تعریف شاخصها و رابطههای ثبتشده در لایههای معنایی و منابع مورد اعتماد استفاده کند. بنابراین کیفیت پاسخ به میزان زیادی به کاری وابسته است که سازمان پیشتر برای منظم و قابل تفسیر کردن داده انجام داده است.
تحلیل Aipolix این است که بخشی از حاکمیت هوش مصنوعی در این محصول به لایه معنایی منتقل میشود. ممکن است کاربر به دو تعریف متفاوت از یک شاخص دسترسی قانونی داشته باشد؛ در چنین وضعی همه کنترلهای دسترسی موفقاند، اما نتیجه برای تصمیم مورد نظر همچنان میتواند نادرست باشد.
در استقرار جدی، باید بتوان منشأ نتیجه را دید: چه منبعی استفاده شده، کدام تعریف کسبوکار اعمال شده، بازه زمانی و فیلترها چه بودهاند و عامل در کجا ناچار به استنباط شده است.
برای دقت محصول هنوز معیار عمومی منتشر نشده است
OpenAI نمونههایی از استفاده مشتریان و استفاده داخلی ارائه میکند، اما این موارد جای سنجش عمومیِ صحت تحلیل را نمیگیرند. VentureBeat گزارش کرده که OpenAI برای نسخه بیرونی Data agent معیار منتشرشدهای برای دقت بازیابی یا صحت پاسخ ارائه نکرده است. بر اساس این گزارش، شرکت نتایج داخلی را با ابزارهای داده خود مقایسه میکند، ولی عدد عمومی برای این ارزیابی اعلام نشده است.
نبود چنین معیاری به معنی نادرست بودن محصول نیست. معنیاش این است که خریدار نمیتواند با یک عدد عمومی، دقت آن را با راهکارهای دیگر مقایسه کند یا نرخ خطا را برای دادههای خودش برآورد کند.
سازمانها بهتر است مجموعه آزمون خودشان را بسازند: پرسشهایی با پاسخ معلوم، اتصالهای دشوار میان جداول، نامهای مبهم برای شاخصها، داده ناقص، مرزهای دسترسی و مواردی که پاسخ درست باید درخواست توضیح بیشتر از کاربر باشد.
ظاهر حرفهای داشبورد هم نباید جای شواهد را بگیرد. هر نتیجه مهم باید به داده قابل ردیابی، محاسبه بازتولیدپذیر و میزان روشنی از قطعیت یا عدم قطعیت متصل باشد.
اجازه تحلیل با اجازه انجام عمل یکی نیست
OpenAI میگوید عامل داده میتواند پس از تحلیل، از طریق ابزارهای متصل اقدامات تأییدشده را انجام دهد. از اینجا به بعد، مرز میان «دیدن و تحلیل کردن» و «تغییر دادن» اهمیت عملی پیدا میکند.
کسی که اجازه مشاهده داده فروش را دارد، لزوماً نباید بتواند حساب مشتری را تغییر دهد، پیام بفرستد، کمپین را اصلاح کند یا رکوردی را در سامانه دیگری بهروزرسانی کند. این اختیارها پیامدهای متفاوتی دارند.
یک الگوی کنترل مناسب دستکم سه سطح را جدا میکند: دسترسی به داده، اجازه ساخت یا اشتراک خروجی تحلیلی، و اجازه ایجاد اثر بیرونی. برای کارهای حساس میتوان تأیید یا کنترل سیاستی سختگیرانهتری در نظر گرفت، حتی اگر خود تحلیل بدون دخالت انسان انجام شود.
این جداسازی برای ممیزی هم ضروری است. باید بتوان بعداً فهمید کدام داده پشت یک پیشنهاد بوده، کاربر دقیقاً چه چیزی را تأیید کرده و عامل در نهایت چه عملی انجام داده است.
کار اصلی استقرار به بخشهای زیربنایی منتقل میشود
Data agent نیاز کاربر عادی به نوشتن دستورهای تخصصی را کمتر میکند، اما نیاز به مهندسی داده، تعریف معنایی و ارزیابی را حذف نمیکند. حتی ممکن است اهمیت این بخشها بیشتر شود، چون افراد بیشتری مستقیماً پرسشهای مهم کسبوکار را مطرح میکنند.
بنابراین سؤال درست برای استقرار این نیست که آیا ابزار به Snowflake، BigQuery یا Power BI وصل میشود. سؤال این است که آیا سازمان تعریف معتبر شاخصها، مرزهای دسترسی، منشأ قابل بررسی، آزمونهای واقعبینانه و کنترل جداگانه برای انجام عمل دارد یا نه.
عرضه جدید OpenAI دسترسی به تحلیل سازمانی را از یک محیط عمومیتر هوش مصنوعی آسانتر میکند. نتیجه معماری روشن است: مجوز مشخص میکند عامل چه چیزی را میتواند ببیند؛ تعریفهای معنایی تعیین میکنند داده را چگونه بفهمد؛ ارزیابی نشان میدهد پاسخ تا چه حد قابل اعتماد است؛ و مجوز اجرای جداگانه مشخص میکند بعد از تحلیل چه کاری حق دارد انجام دهد.