
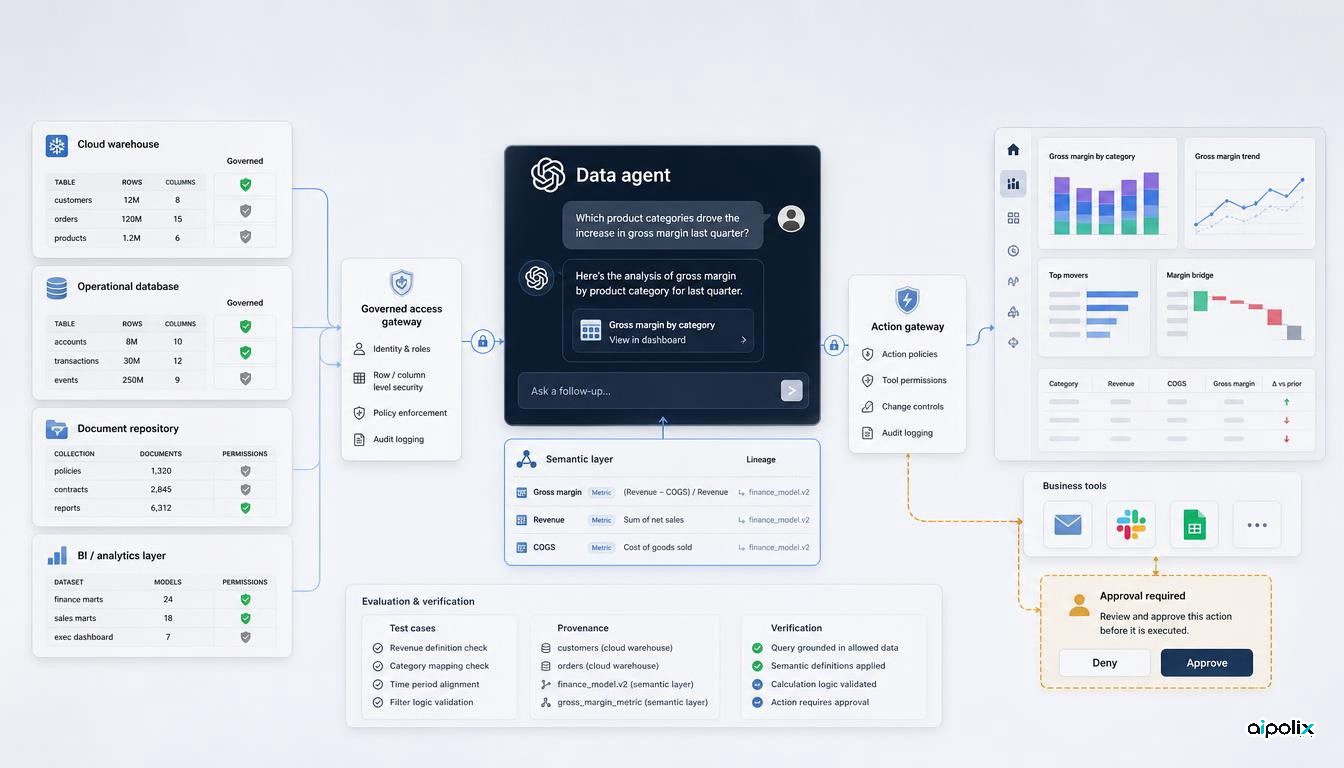
OpenAI lance un agent Data dans ChatGPT Work capable de se connecter aux sources autorisées d’une entreprise, d’examiner l’évolution de ses indicateurs, de produire des tableaux de bord interactifs et, lorsque les droits le permettent, de poursuivre le travail dans des outils connectés. ChatGPT Work devient ainsi une interface au-dessus de l’écosystème de données existant plutôt qu’un entrepôt supplémentaire.
Le point décisif n’est pas seulement le nombre de connecteurs. OpenAI indique que les requêtes respectent les droits du compte connecté, y compris les restrictions par table, ligne et colonne. L’agent peut aussi exploiter les définitions métier, calculs et relations décrits dans des couches sémantiques et des sources de confiance. Ces mécanismes encadrent l’accès, mais ils ne prouvent pas que l’agent a choisi le bon indicateur, associé les bonnes données ou tiré une conclusion correcte.
Une couche au-dessus des outils déjà en place
OpenAI cite notamment Amazon Redshift, Datadog, Google BigQuery, ClickHouse, Databricks, MongoDB et Snowflake parmi les sources compatibles. Google Drive et SharePoint peuvent fournir des documents, tandis que Power BI, Tableau, ThoughtSpot, Sigma, Oracle BI ou Omni peuvent accueillir ou alimenter les tableaux de bord.
L’architecture évite de demander aux entreprises de déplacer toutes leurs données vers un nouveau système. L’agent assemble le contexte disponible dans les outils existants, puis l’utilisateur affine l’analyse par la conversation. Les administrateurs décident quels connecteurs sont accessibles et à quels rôles.
Cette approche élargit nettement l’analytique en libre-service. Un responsable commercial, opérationnel ou produit peut explorer une question sans écrire de SQL ni attendre la production d’un rapport dédié. Mais rendre la question plus facile ne rend pas automatiquement la réponse plus fiable.
Les permissions ne couvrent qu’une partie de la gouvernance
Un contrôle d’accès détermine qui peut consulter une ligne ou une colonne. Il ne dit pas ce que signifie exactement « revenu », « churn » ou « utilisateur actif », quelle source fait foi ni si deux équipes utilisent la même définition.
La documentation d’OpenAI reconnaît implicitement cette difficulté : l’agent peut reprendre les définitions et relations présentes dans les couches sémantiques et les référentiels de confiance. Son efficacité dépend donc aussi du travail réalisé en amont pour rendre les données cohérentes et interprétables.
L’analyse d’Aipolix est qu’une partie de la gouvernance de l’IA se déplace ici vers la couche sémantique. Un utilisateur peut avoir légitimement accès à deux définitions contradictoires du même indicateur. Les contrôles d’accès seront alors respectés, alors que l’analyse pourra rester inadaptée à la décision recherchée.
Une mise en production solide doit rendre la provenance des conclusions importantes visible : sources interrogées, définition métier retenue, filtres et périodes appliqués, ainsi que les endroits où l’agent a dû inférer une règle au lieu de la retrouver explicitement.
Aucun benchmark public de précision pour le produit externe
OpenAI publie des témoignages de clients et décrit un usage interne important. Ces éléments renseignent sur l’adoption ou l’expérience, pas sur un taux public de justesse analytique. VentureBeat rapporte qu’OpenAI n’a pas publié de benchmark de précision de récupération ou de correction des réponses pour la version externe de l’agent. L’entreprise comparerait ses résultats internes avec ses propres outils, sans fournir de chiffre public.
Cette absence ne démontre pas que le produit est peu fiable. Elle signifie qu’une entreprise ne dispose pas d’un chiffre publié lui permettant de comparer directement sa précision à celle d’autres approches ou d’estimer le taux d’erreur sur ses propres données.
La validation doit donc être construite localement. Un jeu d’évaluation utile peut inclure des questions dont la réponse est connue, des jointures complexes, des noms de métriques ambigus, des données incomplètes, des frontières d’autorisation et des cas où la bonne réponse consiste à demander une précision.
Un tableau de bord élégant peut aussi donner une apparence de certitude à une analyse fragile. Les affirmations importantes doivent rester reliées à leurs données, à des calculs reproductibles et à une indication claire de l’incertitude.
Le droit d’analyser ne doit pas devenir un droit d’agir
OpenAI précise que l’agent peut aller au-delà de l’analyse et exécuter des actions approuvées via des outils connectés. La séparation entre lecture analytique et exécution devient alors une frontière de contrôle essentielle.
Pouvoir consulter les données commerciales ne devrait pas suffire pour modifier un compte, contacter un client, changer une campagne ou mettre à jour un autre système. Ces pouvoirs n’ont ni le même risque ni la même portée.
Un modèle de contrôle pratique distingue au minimum trois capacités : accéder aux sources, produire ou partager un objet analytique, puis provoquer un effet externe. Les actions sensibles peuvent ainsi exiger une confirmation ou un contrôle de politique supplémentaire même si l’analyse elle-même reste libre-service.
Cette séparation améliore aussi l’audit. L’entreprise doit pouvoir reconstituer les données ayant conduit à une recommandation, l’approbation donnée par l’utilisateur et l’action finalement exécutée par l’agent.
Le travail critique se déplace en amont
L’agent Data réduit le besoin de maîtriser la syntaxe des outils analytiques. Il ne supprime ni l’ingénierie des données, ni la gouvernance sémantique, ni l’évaluation. Leur importance peut même augmenter lorsque beaucoup plus de collaborateurs posent directement des questions susceptibles d’influencer des décisions.
La question de déploiement n’est donc pas seulement de savoir si l’agent sait se connecter à Snowflake, BigQuery ou Power BI. Il faut aussi vérifier que l’organisation possède des définitions de métriques fiables, des limites d’accès cohérentes, une provenance vérifiable, des cas de test réalistes et des autorisations distinctes pour les actions.
Avec cette sortie, OpenAI rend l’analytique d’entreprise plus accessible depuis un espace d’IA généraliste. La conséquence architecturale est simple : les permissions déterminent ce que l’agent peut voir, la couche sémantique façonne ce qu’il comprend, l’évaluation mesure la fiabilité de ses réponses et des droits d’exécution séparés définissent ce qu’il peut faire ensuite.