
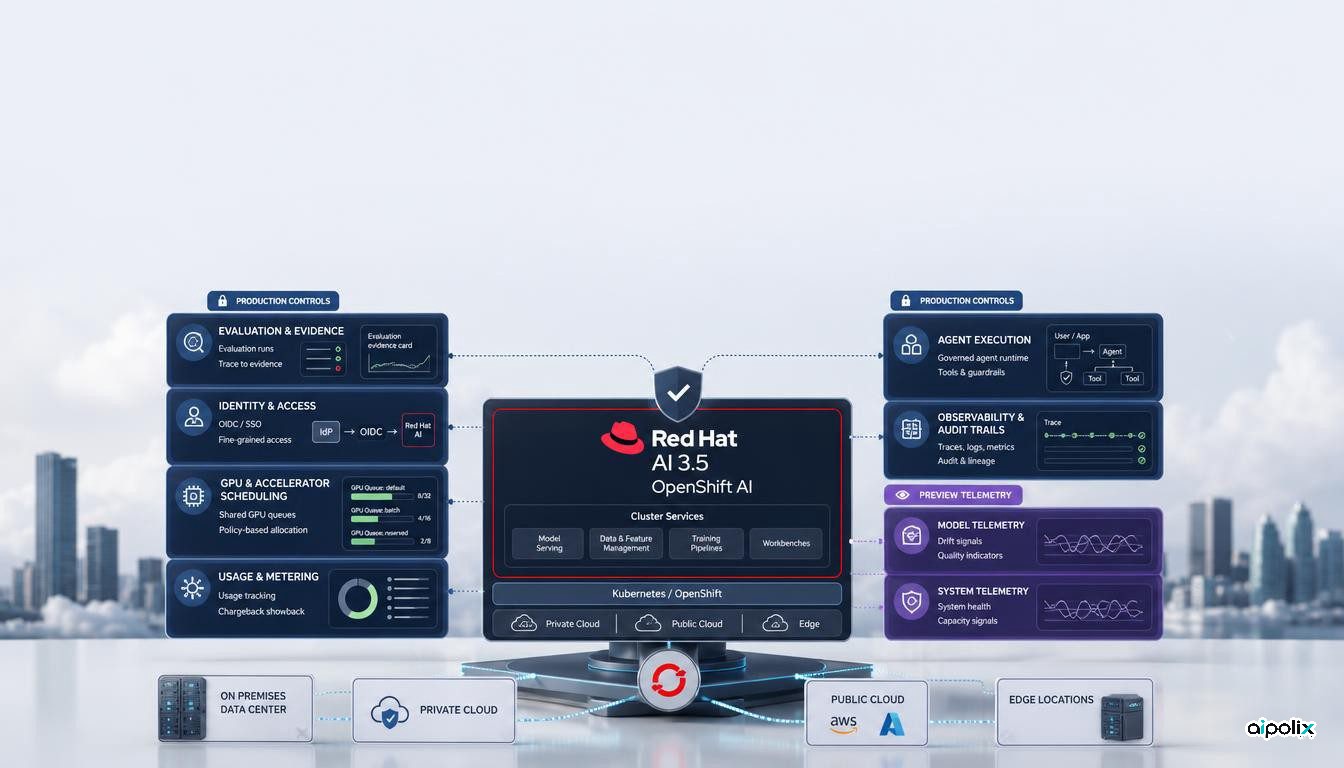
Red Hat نسخه ۳٫۵ مجموعه Red Hat AI را منتشر کرده و بخش مهمی از امکانات تازه را به کنترلهایی اختصاص داده است که برای اداره هوش مصنوعی در محیط تولید لازماند. EvalHub به وضعیت عرضه عمومی رسیده، ارزیابی امنیتی مدلها گستردهتر شده، کنترل استفاده مشترک از GPU و گزارش مصرف کاربران توسعه یافته و ابزارهایی برای ساخت و ارزیابی عاملها نیز به پلتفرم اضافه شدهاند.
اهمیت این نسخه در تعداد قابلیتها نیست. چند سازوکار که پیشتر معمولاً بیرون از مسیر اصلی استقرار قرار میگرفتند، حالا در خود زیرساخت جای گرفتهاند: میتوان پیش از استقرار برای مدل یا عامل شواهد ارزیابی تولید کرد، دسترسی به مدل را به سامانه هویت سازمانی پیوند داد، در زمان کمبود ظرفیت برای درخواستهای استنتاج اولویت تعیین کرد و مصرف را به کاربر یا گروه مشخص نسبت داد. در چنین معماریای، حاکمیت هوش مصنوعی بخشی از کار روزمره تیم پلتفرم میشود.
ارزیابی میتواند وارد فرایند انتشار شود
یکی از تغییرهای مهم OpenShift AI 3.5 عرضه عمومی EvalHub است. مستندات Red Hat میگویند این سامانه میتواند مدلها، برنامههای هوش مصنوعی، عاملها و ابزارها را ارزیابی کند و برای بررسی آسیبپذیری نیز به کار رود. SDK و ابزار خط فرمان، آزمون خودکار با Garak و کارتهای استاندارد ارزیابی نیز در این نسخه دیده میشوند.
نتیجه عملی این است که ارزیابی را میتوان به خط انتشار نرمافزار نزدیکتر کرد. بهجای آنکه نتیجه آزمون در یک نوتبوک یا داشبورد جدا بماند، تیم میتواند خروجی ساختیافتهای همراه نسخه مدل یا عامل نگه دارد و از آن در تصمیم استقرار استفاده کند.
اما این سازوکار بهتنهایی اعتبار ارزیابی را تضمین نمیکند. کارت ارزیابی نشان نمیدهد که بنچمارک انتخابشده برای یک فرایند تجاری کافی است، قاضی ارزیابی سوگیری ندارد یا یک امتیاز مشخص واقعاً به معنای ایمنی است. Red Hat تولید و نگهداری شواهد را سادهتر کرده، ولی تعریف معیار پذیرش و مسئول پذیرش همچنان بر عهده سازمان است.
هویت، اولویت و هزینه حالا بخشی از سرویسدهی مدلاند
در OpenShift AI 3.5 میتوان دسترسی Models-as-a-Service را به ارائهدهنده هویت مبتنی بر OpenID Connect متصل کرد. عضویت گروهی میتواند مبنای دسترسی و سهمیه باشد. Red Hat همچنین از زمانبندی منصفانه GPU، اولویتبندی درخواستها، نمایش مصرف توکن برای هر کاربر و جداسازی قویتر مستأجرها با لایههای کنترلی مجزا و مجازیسازی صحبت میکند.
این مجموعه قابلیتها مرز کنترل را تغییر میدهد. پلتفرم بهتر میتواند پاسخ دهد چه کسی حق استفاده از یک مدل را دارد، هنگام کمبود منابع کدام بار کاری مقدم است و هزینه مصرف به کدام کاربر یا واحد برمیگردد. این همان نوع کنترلی است که تیمهای زیرساختی سالها برای پایگاه داده، خوشه و APIهای داخلی اعمال کردهاند.
در سامانههای هوش مصنوعی، سیاست منابع میتواند مستقیماً رفتار برنامه را تغییر دهد. یک ارزیابی پسزمینه ممکن است برای درخواست عاملِ کاربرمحور عقب بیفتد، سهمیه میتواند ادامه کار عامل را متوقف کند و سیاست هویتی ممکن است دسترسی به مدلی را ببندد که برنامه از نظر فنی قادر به فراخوانی آن است. بنابراین آزمایش خطا و رفتار جایگزین باید بخشی از طراحی باشد.
ابزارهای عامل از سطح برنامه به سطح پلتفرم نزدیک میشوند
این نسخه AutoRAG را گسترش میدهد، الگوهای آماده برای کارهایی مانند بازبینی کد و پردازش سند ارائه میکند، از Responses API پشتیبانی میکند و کنترلهای حفاظتی را به این مسیر نزدیکتر میسازد. ارزیابی و آزمون امنیتی نیز میتوانند در اطراف عاملها اجرا شوند، نه فقط روی مدل پایه.
این تغییر معماری ارزشمند است. بسیاری از تیمها عامل را با مجموعهای از کتابخانههای جداگانه برای بازیابی اطلاعات، مجوزها، ارزیابی و ردیابی میسازند. انتقال بخشی از این وظایف به یک لایه مشترک، استانداردسازی را آسانتر میکند.
در مقابل، وابستگی به پلتفرم بیشتر میشود. رفتار عامل فقط به کد برنامه وابسته نیست و ممکن است از تنظیمات خوشه، هویت، مسیردهی یا سرویس ارزیابی اثر بگیرد. بهتر است نسخه سیاستهای پلتفرم و پیکربندی اجرا نیز در کنار نسخه برنامه ثبت شود تا هنگام افت کیفیت بتوان تغییر زیرساخت را از تغییر کد جدا کرد.
همه قابلیتهای ۳٫۵ وضعیت پشتیبانی یکسان ندارند
عبارت «Red Hat AI 3.5 بهطور عمومی عرضه شده است» نباید به این برداشت منجر شود که همه قابلیتهای مرتبط با این نسخه آماده استفاده در مسیرهای حساس تولید هستند. مستندات رسمی Red Hat برخی امکانات را صراحتاً در وضعیت Technology Preview قرار دادهاند. سامانه متمرکز مشاهدهپذیری برای گردآوری متریک، ردگیری و هشدار یکی از این موارد است و بعضی امکانات دسترسی به لاگهای EvalHub نیز هنوز آزمایشیاند.
این تفاوت برای طراحی معماری مهم است. تیم پلتفرم نباید از عرضه عمومی کل نسخه نتیجه بگیرد که هر داشبورد، مسیر تلهمتری یا یکپارچهسازی تازه همان سطح پشتیبانی EvalHub یا سایر قابلیتهای پایدار را دارد.
پیشنهاد عملی Aipolix این است که پیش از استقرار، جدولی از وضعیت پشتیبانی اجزا تهیه شود. قابلیتهای پایدار که میتوانند در بخشهای حیاتی محیط تولید به کار گرفته شوند از امکانات آزمایشی جدا شوند؛ اجزای آزمایشی بهتر است اختیاری و قابل جایگزینی بمانند و حسابرسی یا پاسخ به رخداد به آنها وابسته نشود.
حاکمیت به زیرساخت نزدیکتر شده، مسئولیت تصمیمگیری نه
ارزش Red Hat AI 3.5 در کنار هم قرار دادن ارزیابی، کنترل دسترسی، تخصیص منابع، نسبت دادن هزینه و ابزارهای عامل است. این ترکیب میتواند اداره هوش مصنوعی را از مجموعهای از راهکارهای پراکنده تیمی به یک سرویس سازمانی منسجمتر تبدیل کند.
با این حال، مسئله اصلی سازمانی همچنان باقی است. EvalHub آزمون را اجرا میکند، OIDC هویت را مشخص میکند و سرویسدهی میتواند سیاست ظرفیت را اعمال کند، اما هیچکدام تعیین نمیکنند کدام آزمون اجباری است، چه امتیازی قابل قبول است، استثنا را چه کسی تأیید میکند یا کدام قابلیت آزمایشی اجازه ورود به یک فرایند مقرراتی را دارد.
برای مدیران فنی، گام مناسب فعال کردن همه امکانات نسخه جدید نیست. هر کنترل باید صاحب مشخص و سطح پشتیبانی معلوم داشته باشد و بخشهای پایدار به فرایندهای موجود انتشار، مدیریت هویت، پاسخ به رخداد و FinOps متصل شوند. Red Hat ابزار اجرای سیاست را بیشتر وارد زیرساخت کرده است؛ قراردادهایی که این ابزارها باید اجرا کنند همچنان باید در خود سازمان تعریف شوند.