
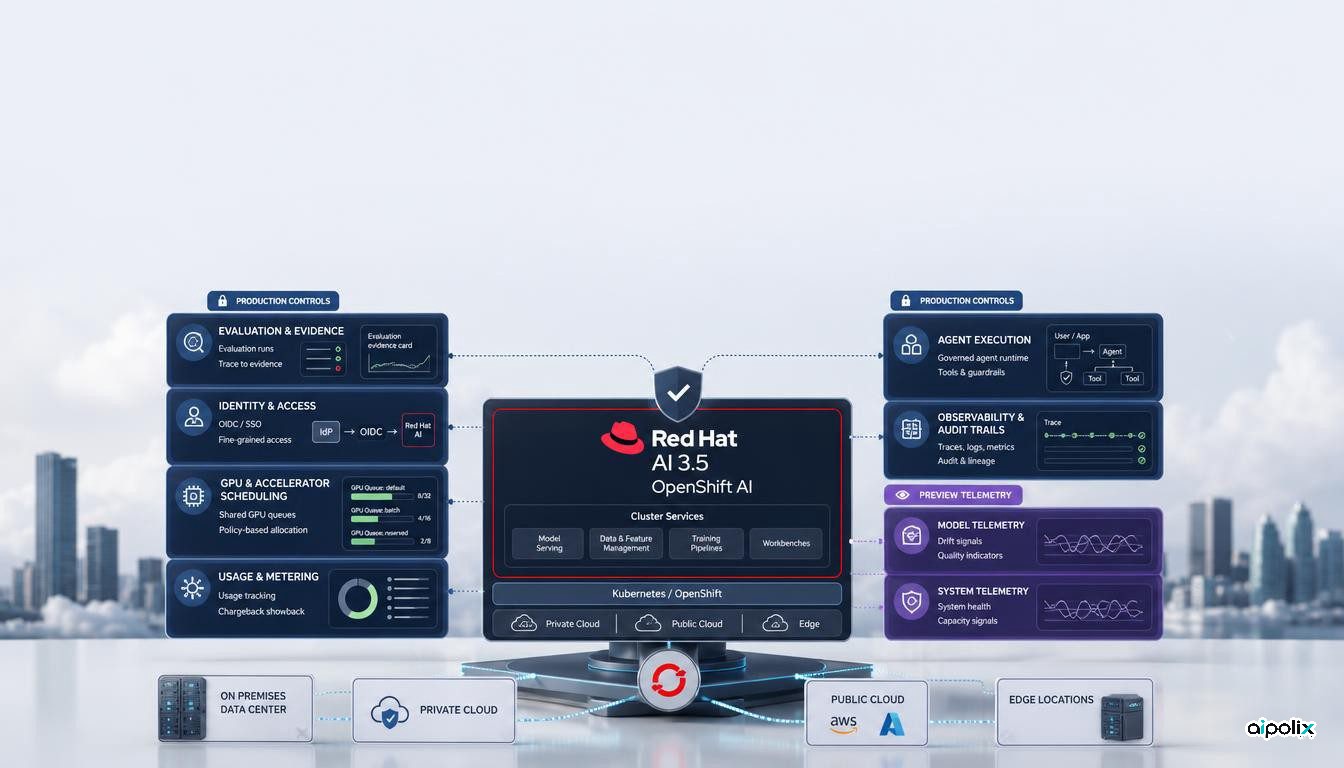
Red Hat a lancé Red Hat AI 3.5 avec une série de fonctions destinées à faire de l'IA un service de production partagé plutôt qu'un assemblage de points d'accès à des modèles. EvalHub est désormais disponible de façon générale, l'analyse adversariale des modèles validés est renforcée, les mécanismes de partage des GPU évoluent et la plateforme ajoute des outils d'observation de la consommation ainsi que des briques pour les agents.
L'intérêt de cette version tient surtout au déplacement des contrôles vers l'infrastructure. L'évaluation peut produire des éléments de preuve avant le déploiement, l'accès aux modèles peut s'appuyer sur l'identité d'entreprise, le service d'inférence peut donner la priorité à certains flux et l'usage peut être attribué à des utilisateurs. La gouvernance de l'IA devient ainsi davantage une responsabilité opérationnelle de l'équipe plateforme.
L'évaluation peut devenir une étape de mise en production
EvalHub constitue l'un des changements les plus nets d'OpenShift AI 3.5. La documentation de Red Hat le classe désormais en disponibilité générale et précise qu'il peut orchestrer des évaluations de modèles, d'applications, d'agents et d'outils, ainsi que des analyses de vulnérabilité. La version ajoute également un SDK, une interface en ligne de commande, des tests adversariaux automatisés avec Garak et des cartes d'évaluation structurées.
Pour une équipe d'ingénierie, cela permet de rapprocher l'évaluation du processus de livraison. Les résultats peuvent accompagner une version et alimenter une décision de déploiement, au lieu de rester dans un notebook ou un tableau de bord sans lien direct avec la chaîne de publication.
Il faut toutefois conserver une frontière claire. Une carte d'évaluation ne prouve pas que les tests choisis sont suffisants pour un métier donné, que le juge est exempt de biais ou qu'un score déterminé garantit la sécurité. Red Hat facilite la production des éléments de preuve; l'organisation doit encore définir ce qui constitue une preuve acceptable et qui peut l'approuver.
Identité, priorité et coût entrent dans le service des modèles
OpenShift AI 3.5 permet de relier Models-as-a-Service à un fournisseur d'identité OpenID Connect externe. Les groupes peuvent être associés aux abonnements et aux droits d'accès. Red Hat décrit aussi un partage plus équitable des GPU, une gestion des requêtes par priorité, la visibilité de la consommation de jetons par utilisateur et une isolation renforcée des locataires.
Ces fonctions déplacent la limite de contrôle. La plateforme peut mieux déterminer qui peut appeler un modèle, quel trafic doit être servi en premier lorsque la capacité manque et à qui imputer la consommation. Ce sont des questions familières aux équipes qui exploitent déjà des bases de données, des clusters ou des API internes.
Avec l'IA, les politiques de ressources peuvent néanmoins modifier directement le comportement d'une application. Une évaluation en arrière-plan peut être retardée au profit d'un agent interactif; un quota peut interrompre une tâche; une règle d'identité peut bloquer un modèle pourtant connu du code. Il faut donc tester les scénarios de défaillance autant que le fonctionnement normal.
Les agents deviennent aussi un sujet de plateforme
Red Hat AI 3.5 enrichit AutoRAG, propose des modèles de départ pour des usages comme la revue de code ou le traitement documentaire, prend en charge Responses API et rapproche les garde-fous de la chaîne d'exécution. Les services d'évaluation et de tests de sécurité peuvent eux aussi être appliqués aux agents.
Cette évolution est intéressante sur le plan architectural. Beaucoup d'équipes assemblent aujourd'hui permissions, recherche documentaire, évaluation et traçage directement dans chaque application. En transférant une partie de ces responsabilités vers une couche partagée, il devient possible de les normaliser.
Cette normalisation crée aussi une dépendance supplémentaire. Le comportement d'un agent peut varier à cause d'un changement de configuration du cluster, d'une règle d'identité, d'un mécanisme de routage ou d'un service d'évaluation. Les politiques et paramètres de la plateforme devraient donc être versionnés avec les applications afin de distinguer une régression logicielle d'un changement d'infrastructure.
Toutes les fonctions 3.5 n'ont pas le même niveau de maturité
L'annonce indique que Red Hat AI 3.5 est disponible de façon générale, mais cela ne signifie pas que toutes les fonctions associées à la branche 3.5 ont le même statut de support. La documentation officielle place encore plusieurs éléments en Technology Preview. L'observabilité centralisée, avec sa pile dédiée de métriques, traces et alertes, en fait partie; certaines fonctions d'accès aux journaux EvalHub restent également en préversion.
Cette nuance est essentielle pour une architecture de production. Une équipe ne devrait pas supposer qu'un tableau de bord, une chaîne de télémétrie ou une intégration récente bénéficie du même engagement de support qu'EvalHub GA ou que les autres fonctions stabilisées.
La lecture pratique d'Aipolix consiste à établir une matrice de maturité avant l'adoption. Les composants GA peuvent entrer dans un processus critique après validation; les fonctions en Technology Preview ou Developer Preview devraient rester optionnelles, isolées ou remplaçables. Un dispositif de conformité ou de réponse à incident ne devrait pas dépendre sans précaution d'un composant que Red Hat ne présente pas encore comme pleinement pris en charge en production.
La plateforme fournit les mécanismes, pas les décisions
Red Hat AI 3.5 rapproche évaluation, contrôle d'accès, allocation des ressources, suivi des coûts et développement d'agents dans une même couche opérationnelle. Cette convergence peut aider les entreprises à traiter l'IA comme un service interne gouverné plutôt que comme une collection d'intégrations propres à chaque équipe.
La responsabilité de la politique reste néanmoins humaine et organisationnelle. EvalHub peut exécuter les tests, OIDC identifier l'appelant et le service d'inférence appliquer une règle de capacité, mais la plateforme ne décide pas quels tests sont obligatoires, quel niveau est acceptable, qui peut autoriser une exception ni quelles fonctions en préversion sont admises dans un processus réglementé.
La bonne étape suivante n'est donc pas d'activer tout le catalogue 3.5. Il faut associer chaque contrôle à un responsable et à un niveau de support, puis intégrer les composants stables aux processus existants de livraison, d'identité, de gestion d'incident et de FinOps. Red Hat rapproche les mécanismes de gouvernance de l'infrastructure; les contrats qu'ils appliquent doivent toujours être définis par l'organisation.