
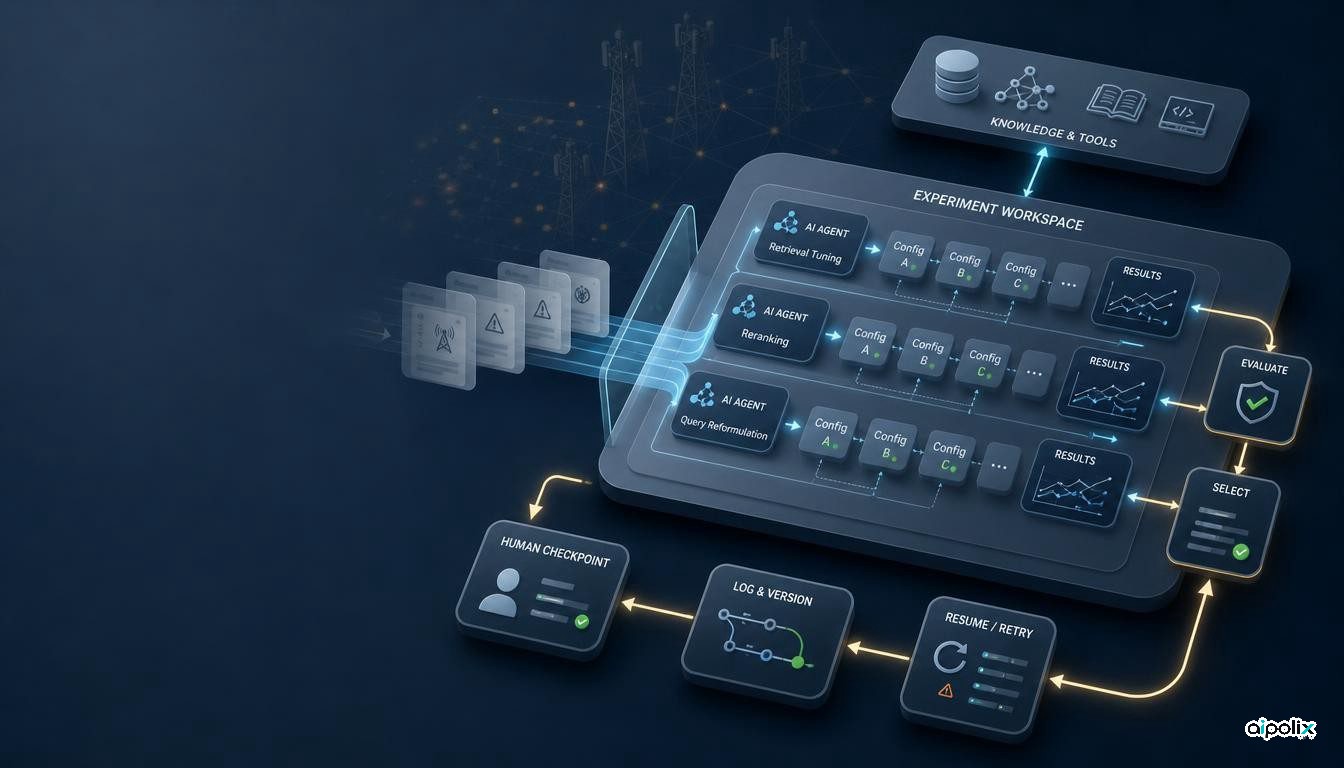
یک مطالعه روی دادههای واقعی یک شرکت مخابراتی، تصویر کاربردیتری از «پژوهش خودکار با عاملهای هوش مصنوعی» ارائه میکند: آیا عاملهای کدنویسی میتوانند بدون اینکه پژوهشگر تکتک تصمیمها را بگیرد، در یک مسئله باز مهندسی جستوجو کنند، آزمایش اجرا کنند و به مدلی رقابتی برسند؟
پژوهشگران Georgetown University و Nokia Bell Labs این ایده را روی بازیابی تیکتهای فنی مخابرات آزمودند. آنها Cursor Composer 2.5، Claude Sonnet 5 و مدل GPT-OSS 120B را که بهصورت محلی اجرا میشد، داخل حلقههای پژوهشی خودکار قرار دادند. بهترین سامانهای که عاملها ساختند به Recall@1 برابر ۰٫۳۴۳ رسید؛ حدود ۹۰ درصد عملکرد سامانه داخلی ساختهشده توسط انسان با امتیاز ۰٫۳۸۰. اجرای فرایند خودکار از ابتدا تا انتها ۱۰ هفته طول کشید و مجموعاً به اندازه یک هفته استفاده از GPU محاسبات مصرف کرد. نویسندگان این عدد را با حدود ۱۰ ماه زمان توسعه سامانههای انسانی مقایسه میکنند.
اما ارزش اصلی مقاله فقط این نیست که عاملها چقدر به رکورد انسانی نزدیک شدند. بخش مهمتر، چیزهایی است که خودکار نشد. عاملها به یک چارچوب اجرایی دقیق، حلقهای قطعی بیرون از خود مدل و دخالت انسان در زمان شکست هماهنگی نیاز داشتند. آنها در جستوجوی عمیق داخل یک فضای از پیش تعریفشده خوب بودند، اما در پیدا کردن ایدههای ساختاری تازه که مزیت سامانه انسانی را ساخته بود، ضعف داشتند.
عاملها نزدیک شدند، اما دستور پخت انسانی را دوباره کشف نکردند
داده پژوهش از یک محیط واقعی مخابراتی میآید: حدود ۲۵۰ هزار تیکت رخداد، ۲۰۴ هزار تحلیل خرابی و ۸۹ هزار تحلیل فنی. برای ارزیابی نیز ۷۶۰۰ پرسوجوی کنارگذاشتهشده و ۱۲۰۰ سند پاسخ مرجع در برابر کل مجموعه قرار گرفتند.
سامانه داخلی انسانی Recall@1 برابر ۰٫۳۸۰ داشت و از روشهایی مانند تولید داده با کمک LLM و بازرتبهبندی استفاده میکرد. بهترین نتیجه خودکار پس از ۱۷ آزمایش یکتا توسط یک حلقه تکعاملی Cursor به ۰٫۳۴۳۳ رسید. یک اجرای Claude بدون اطلاع قبلی از راهحل انسانی ۰٫۳۳۷۸ گرفت و GPT-OSS محلی در شرایط مشابه به ۰٫۳۳۵۳ رسید.
این نزدیکی مهم است، چون یک فرض رایج را زیر سؤال میبرد: اینکه مدل قویتر یا معماری چندعاملی پیچیدهتر الزاماً پژوهش خودکار بهتری میسازد. در این مطالعه، چند عامل متفاوت با وجود تفاوت چشمگیر در مدل و شیوه اجرا، نزدیک به یک سقف عملکردی مشترک متوقف شدند. ساختارهای چندعاملی نیز از بهترین حلقههای تکعاملی جلو نزدند.
به گفته نویسندگان، عاملها بیشتر سراغ تغییرات آشنا رفتند: نسبت نمونهها، طول توالی، تعداد دورههای آموزش و دیگر پارامترهای آموزش. اما ایدههای سطح بالاتری مثل بازرتبهبندی، افزایش داده و ترکیب چند مدل که سامانه انسانی از آنها استفاده میکرد، بهطور مستقل کشف نشد.
محصول پنهان این پژوهش، خودِ چارچوب اجرایی بود
قابلانتقالترین نتیجه مقاله احتمالاً یک الگوریتم تازه نیست، بلکه تجربه عملی ساخت محیط اجرای عاملهاست.
اینکه صرفاً به عامل گفته شود «آزمایش را ادامه بده» قابل اتکا نبود. کنترلکنندههای پایش دورهای مبتنی بر Python هم گاهی متوقف میشدند یا آزمایشهای تکراری راه میانداختند. در نهایت پژوهشگران تداوم اجرا را از اختیار عامل خارج کردند: یک حلقه قطعی در پوسته فرمان همان نشست را دوباره باز میکرد و از عامل میخواست به بهبود Recall@1 ادامه دهد.
در این چارچوب، ساختار داده، دامنه مسئله، سختافزار در دسترس و معیار بهینهسازی نیز صریحاً نوشته شده بود. با وجود این، مدلهای متنباز در هماهنگکردن زیرعاملها مشکل داشتند. مقاله گزارش میکند GPT-OSS 120B با وجود دستور روشن و افزونه مخصوص، در دهها تلاش فقط یک بار توانست زیرعاملها را بهدرستی راهاندازی کند. تلاشهای Qwen Coder 30B نیز در این بخش قابل اتکا نبودند. عاملهای تجاری در ساخت و مدیریت زیرعاملها پایدارتر عمل کردند.
این جزئیات معنای «پژوهش خودکار» را عوض میکند. پژوهشگران یک مدل را بدون محدودیت در آزمایشگاه رها نکردند. آنها هدفی محدود، فرایند اندازهگیری روشن، نسخهبندی کد، فضای جستوجوی مشخص و یک ناظر قطعی بیرون از عامل ساختند.
از این زاویه، سامانه بیشتر شبیه یک موتور خودکار بهینهسازی است تا جایگزین پژوهشگر؛ و همین تمایز برای تیمهای مهندسی مهم است.
هزینه پایین جذاب است، اما مقایسه کامل نیست
برآورد مقاله برای یک کمپین ۱۰ تا ۲۰ آزمایشی با Cursor Composer 2.5 حدود ۱۵۰ تا ۲۰۰ دلار هزینه API است. اجرای مشابه با Claude Sonnet 5 حدود دو تا سه برابر بیشتر هزینه داشت. GPT-OSS نیز چون روی زیرساخت محلی اجرا شد، هزینه API نداشت.
با این حال این اعداد هزینه آمادهسازی مخزن و ساخت چارچوب اجرایی را شامل نمیشوند. زمان نظارت پژوهشگر، اجرای ناموفق، سختافزار GPU، ساخت ارزیابی و کاری که قبلاً برای تعریف مسئله و ساخت سامانههای انسانی انجام شده نیز در این رقم نیست.
مقایسه «۱۰ هفته در برابر ۱۰ ماه» هم آزمایش کنترلشده بهرهوری نیست. عاملها زمانی وارد شدند که مسئله، داده، معیار و خطوط مبنا از قبل وجود داشتند. سامانه انسانی همچنان نتیجه بهتری داشت و از ایدههایی استفاده میکرد که عاملها نتوانستند خودشان پیدا کنند.
نتیجه قابل دفاع محدودتر است: وقتی مسئله و چرخه سنجش از قبل آماده باشد، عاملها میتوانند بخش بزرگی از آزمایشهای تکراری را با هزینه حاشیهای نسبتاً پایین فشرده کنند.
طراحی فضای جستوجو از نام مدل مهمتر بود
یکی از جالبترین یافتهها این است که برند مدل سقف عملکرد را تعیین نکرد.
پژوهشگران انتظار داشتند Claude از Cursor بهتر باشد، Cursor از GPT-OSS بهتر عمل کند و تیم چندعاملی از حلقه تکعاملی جلو بزند. دادهها این ترتیب را تأیید نکردند. چند اجرای تکعاملی در محدوده Recall@1 حدود ۰٫۳۰ تا ۰٫۳۴ به هم نزدیک شدند و بعضی تیمهای چندعاملی، با وجود تعداد آزمایش بیشتر، نتیجه ضعیفتری داشتند.
عامل تعیینکنندهتر، نحوه تعریف فضای جستوجو بود. بدون راهنمایی صریح، عاملها به بهینهسازی معمول پارامترها برمیگشتند. وقتی پژوهشگران متغیرهایی برای نمایش داده، تولید نمونه و معماری در اختیارشان گذاشتند، دامنه آزمایش وسیعتر شد؛ اما باز هم بیشتر گزینههایی بررسی شد که انسان از قبل در محیط قرار داده بود.
برای تیمی که میخواهد سامانه تحقیقاتی عاملمحور بسازد، پیام عملی روشن است: قبل از ارتقای مدل، قرارداد آزمایش را جدی بگیرید. مشخص کنید چه چیزهایی قابل تغییرند، چه چیزهایی نباید تغییر کنند، نتیجه چگونه تأیید میشود، شکست چگونه برگشت میخورد و اجرای قطعشده چگونه ادامه پیدا میکند. مدل قویتر نمیتواند محیط پژوهشی مبهم را جبران کند.
خودمختاری امروز بیشتر شبیه «جستوجوی هدایتشده» است
این مقاله خودمختاری عمومی علمی را ثابت نمیکند. فقط یک مسئله بازیابی صنعتی، یک مجموعهداده داخلی، یک خط مبنای منتشرنشده داخلی و تعداد محدودی کمپین را بررسی میکند. دادهها برای بررسی مستقل در دسترس نیستند و مقاله فعلاً یک پیشچاپ arXiv است.
با این حال ارزش مطالعه در همین کنار هم گذاشتن توانایی و محدودیت است. عاملها میتوانند تعداد زیادی آزمایش منظم اجرا کنند و به یک سامانه انسانی قوی نزدیک شوند. هزینه مستقیم مدل نیز نسبتاً پایین است. اما هنوز انسان باید محیط را طراحی کند، اجرای عامل را پایدار نگه دارد و زمانی که مسئله به «ایده تازه» نیاز دارد، نه صرفاً آزمایش بیشتر، مسیر را عوض کند.
بنابراین شکل واقعبینانه پژوهش خودکار در کوتاهمدت احتمالاً «دانشمند هوش مصنوعی که جای آزمایشگاه را میگیرد» نیست. مدل عملیتر، یک حلقه پژوهشی کنترلشده است: انسان هدف و مرزها را تعیین میکند، عاملها درون آن فضا با سرعت زیاد جستوجو میکنند و هرجا جستوجوی محلی به بنبست میرسد، تصمیم راهبردی دوباره به انسان برمیگردد.
این تصویر شاید هیجان کمتری از خودمختاری کامل داشته باشد، اما به چیزی که تیمهای فنی امروز واقعاً میتوانند بسازند نزدیکتر است.