
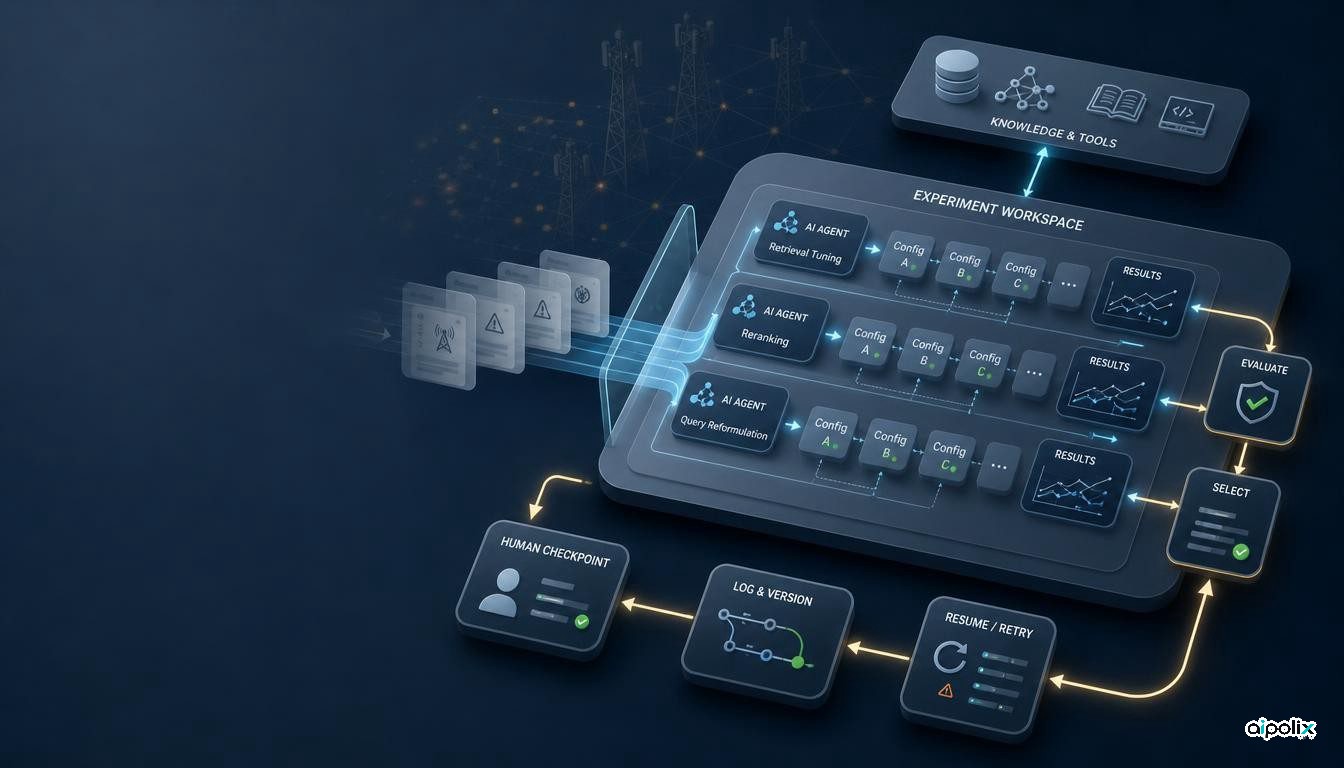
Une étude menée sur des données réelles d’un opérateur télécom apporte un test plus instructif de la recherche autonome en apprentissage automatique qu’un nouveau benchmark fermé : des agents de programmation peuvent-ils explorer un problème d’ingénierie ouvert, lancer des expériences et trouver un système compétitif sans qu’un chercheur choisisse chaque étape ?
Des chercheurs de Georgetown University et de Nokia Bell Labs ont appliqué cette idée à la recherche de tickets d’incident télécom. Ils ont utilisé Cursor Composer 2.5, Claude Sonnet 5 et GPT-OSS 120B exécuté localement dans des boucles de recherche autonomes. Le meilleur système découvert par les agents atteint un Recall@1 de 0,343, soit environ 90 % des 0,380 obtenus par un système interne conçu par des humains. La campagne autonome a duré dix semaines de bout en bout et consommé l’équivalent d’une semaine-GPU ; les auteurs comparent ce délai à environ dix mois de développement pour les systèmes humains.
Mais l’intérêt principal du papier tient autant à ce qui résiste à l’automatisation. Les agents ont eu besoin d’un environnement d’exécution soigneusement conçu, d’une boucle déterministe externe et d’interventions humaines lorsque l’orchestration échouait. Ils se montrent efficaces pour approfondir une recherche paramétrique bien délimitée, beaucoup moins pour inventer les idées de haut niveau qui donnent encore l’avantage au système humain.
Les agents approchent le résultat humain sans retrouver sa stratégie
Le jeu de données est issu d’un environnement télécom réel : environ 250 000 tickets d’incident, 204 000 analyses de panne et 89 000 analyses techniques. L’évaluation repose sur 7 600 requêtes réservées et 1 200 documents de résolution de référence confrontés à l’ensemble du corpus.
Le meilleur système humain interne obtient 0,380 en Recall@1 et s’appuie notamment sur de l’augmentation de données assistée par LLM et du reclassement. Le meilleur résultat autonome, produit par une boucle Cursor à agent unique après 17 expériences distinctes, atteint 0,3433. Une campagne Claude non informée atteint 0,3378 ; une campagne locale GPT-OSS non informée, 0,3353.
La proximité de ces résultats affaiblit une hypothèse courante : un modèle de base plus puissant ou une architecture multi-agent plus complexe ne garantit pas une meilleure recherche autonome. Dans cette expérience, plusieurs configurations convergent vers une limite assez proche. Les équipes multi-agents ne dépassent pas les meilleures boucles à agent unique.
Les agents découvrent surtout des optimisations conventionnelles : composition des paires d’entraînement, longueur de séquence, nombre d’époques et autres hyperparamètres. Ils ne reconstruisent pas spontanément les idées plus structurelles du système humain, comme le reclassement, l’augmentation de données ou l’assemblage de plusieurs modèles.
Le véritable produit est peut-être le harnais d’exécution
La contribution la plus réutilisable de l’étude est probablement opérationnelle.
Demander simplement à l’agent de continuer à expérimenter ne s’est pas révélé fiable. Des contrôleurs de surveillance périodique écrits en Python se bloquaient eux aussi ou relançaient des expériences redondantes. Les chercheurs ont finalement déplacé la continuité hors de l’agent : une boucle shell déterministe rouvrait la même session et lui demandait de poursuivre l’amélioration du Recall@1.
L’environnement documentait également la structure des données, le périmètre de la tâche, les ressources matérielles et la métrique cible. Malgré cela, les modèles ouverts rencontraient des difficultés pour orchestrer des sous-agents. Le papier indique que GPT-OSS 120B, malgré des consignes explicites et une extension dédiée, n’a réussi à en lancer correctement qu’une seule fois sur des dizaines de tentatives. Les essais avec Qwen Coder 30B ont présenté le même type de fragilité. Les agents commerciaux se sont montrés plus fiables sur ce point.
Cette observation change ce que recouvre le mot « autonome ». Il ne s’agit pas d’un modèle lâché librement dans un laboratoire. L’autonomie repose sur un objectif étroit, des expériences instrumentées, du versionnement, un espace de recherche préstructuré et un superviseur de processus extérieur au modèle.
On est donc plus proche d’un service d’optimisation automatisé que d’un chercheur artificiel général.
Des coûts attrayants, mais une comparaison incomplète
Les auteurs estiment qu’une campagne de 10 à 20 expériences avec Cursor Composer 2.5 coûte environ 150 à 200 dollars en API. Une campagne équivalente avec Claude Sonnet 5 coûterait deux à trois fois plus ; les exécutions GPT-OSS évitent les frais d’API grâce à l’infrastructure locale.
Ces chiffres n’incluent toutefois ni la préparation du dépôt ni le développement du harnais. Ils ne chiffrent pas non plus la supervision humaine, les exécutions ratées, le matériel GPU, la construction de l’évaluation ou le travail antérieur nécessaire pour définir le problème et produire les systèmes de comparaison.
De même, « dix semaines contre dix mois » n’est pas une expérience contrôlée de productivité. Le travail autonome intervient après la définition de la tâche, la disponibilité des données et l’existence de références humaines. Le système humain reste meilleur et emploie des idées que les agents n’ont pas inventées.
La conclusion défendable est plus précise : une fois le problème et la boucle de mesure en place, les agents peuvent comprimer une quantité importante d’expérimentation itérative pour un coût marginal de modèle relativement faible.
La définition de l’espace de recherche compte plus que la marque du modèle
Un autre résultat fort concerne le choix du modèle.
Les chercheurs s’attendaient à voir Claude devancer Cursor, Cursor devancer GPT-OSS, et les équipes multi-agents dépasser les boucles simples. Les résultats ne suivent pas cette hiérarchie. Plusieurs exécutions à agent unique se regroupent autour de 0,30 à 0,34 en Recall@1, tandis que certaines équipes multi-agents obtiennent de moins bons résultats malgré davantage d’expériences.
La manière de cadrer la recherche semble plus déterminante. Sans consigne précise, les agents reviennent à l’optimisation classique des hyperparamètres. Lorsque les chercheurs exposent des variables liées à la représentation, à la génération de données et à l’architecture, l’exploration s’élargit, mais elle reste largement limitée aux options préparées par les humains.
Pour une équipe qui construit un système de R&D agentique, la priorité devrait donc être le contrat expérimental : ce qui peut changer, ce qui reste invariant, comment un résultat est validé, comment une expérience ratée est annulée et comment l’exécution reprend après une interruption. Un meilleur modèle ne compense pas un environnement de recherche mal spécifié.
L’autonomie actuelle ressemble surtout à une recherche dirigée
Cette étude ne démontre pas une autonomie scientifique générale. Elle porte sur un seul problème industriel de recherche d’information, un jeu de données interne, une référence interne non publiée et un nombre limité de campagnes. Les données ne sont pas accessibles pour vérification indépendante et le document reste un preprint arXiv.
Sa valeur vient justement de la coexistence du progrès et de la friction. Les agents peuvent mener suffisamment d’expériences disciplinées pour approcher une forte référence humaine, à un coût direct de modèle modeste. Mais des humains doivent encore concevoir l’environnement, stabiliser l’exécution et apporter les idées structurelles lorsque la recherche locale cesse de progresser.
Le scénario crédible à court terme n’est donc pas « un scientifique IA remplace le laboratoire ». Il ressemble davantage à une boucle de recherche gouvernée : l’humain fixe l’objectif et les limites, les agents explorent agressivement à l’intérieur, puis l’humain reprend la main lorsqu’il faut une nouvelle hypothèse plutôt qu’un essai supplémentaire.
C’est moins spectaculaire que l’autonomie complète, mais beaucoup plus proche d’un système que des équipes d’ingénierie peuvent réellement déployer aujourd’hui.