
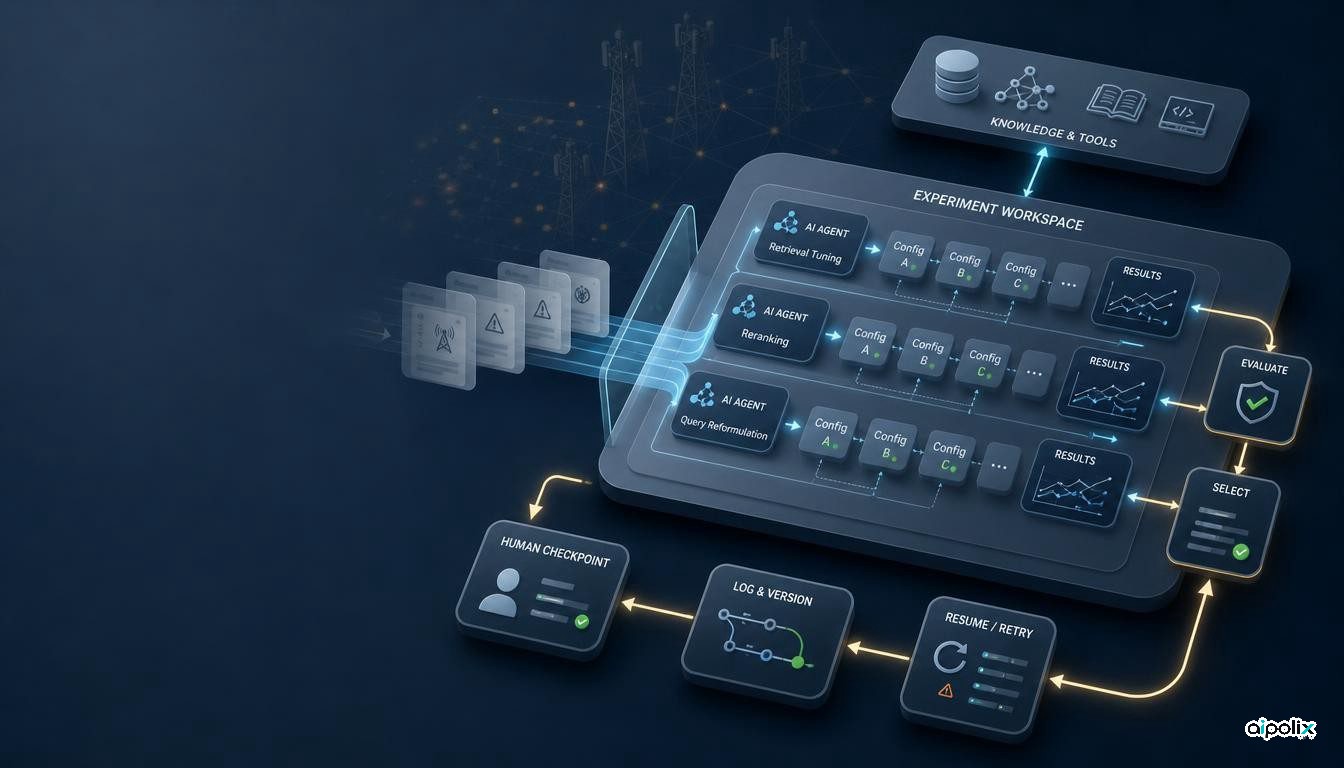
Um estudo realizado com dados reais de telecomunicações oferece um teste mais útil à investigação autónoma em aprendizagem automática do que mais um benchmark fechado: conseguem agentes de programação explorar um problema de engenharia aberto, executar experiências e encontrar uma solução competitiva sem um investigador decidir cada passo?
Investigadores da Georgetown University e da Nokia Bell Labs aplicaram esta ideia à recuperação de tickets técnicos de telecomunicações. Usaram Cursor Composer 2.5, Claude Sonnet 5 e GPT-OSS 120B executado localmente em ciclos autónomos de investigação. O melhor sistema encontrado pelos agentes atingiu Recall@1 de 0,343, cerca de 90% dos 0,380 obtidos por um sistema interno desenvolvido por humanos. A campanha autónoma demorou dez semanas de ponta a ponta e consumiu o equivalente a uma semana de GPU; os autores comparam esse período com cerca de dez meses de desenvolvimento dos sistemas humanos.
O resultado é promissor, mas o artigo é especialmente relevante pelo que não foi possível automatizar de forma limpa. Os agentes precisaram de uma estrutura de execução cuidadosamente desenhada, de um ciclo determinístico externo e de intervenção humana quando a orquestração falhava. Foram eficazes a explorar profundamente um espaço já definido, mas mostraram pouca capacidade para inventar as ideias estruturais que deram vantagem ao sistema humano.
Os agentes aproximaram-se, mas não redescobriram a estratégia humana
O estudo usa um corpus interno de telecomunicações com cerca de 250 mil tickets de incidente, 204 mil análises de falhas e 89 mil análises técnicas. A avaliação utiliza 7.600 consultas reservadas e 1.200 documentos de resolução de referência, comparados com o corpus completo.
O melhor sistema humano interno obteve Recall@1 de 0,380 e incluía técnicas como aumento de dados assistido por LLM e reordenação. O melhor resultado autónomo, produzido por um único agente Cursor após 17 experiências distintas, chegou a 0,3433. Uma campanha Claude sem informação prévia sobre a solução humana chegou a 0,3378 e uma campanha local com GPT-OSS nas mesmas condições atingiu 0,3353.
Esta proximidade enfraquece uma suposição comum: um modelo de base mais forte ou uma arquitetura multiagente mais complexa não produz necessariamente melhor investigação autónoma. Neste ensaio, configurações muito diferentes convergiram para um teto semelhante. As equipas multiagente também não ultrapassaram os melhores ciclos com um único agente.
Segundo os autores, os agentes descobriram sobretudo otimizações convencionais: composição dos pares de treino, comprimento das sequências, número de épocas e outros hiperparâmetros. Não chegaram de forma independente às ideias de nível mais alto usadas pelo sistema humano, como reordenação, aumento de dados e combinação de modelos.
O produto escondido foi a estrutura de execução
A conclusão mais reutilizável do trabalho pode ser operacional, não algorítmica.
Dizer simplesmente ao agente para continuar a experimentar não foi fiável. Controladores periódicos em Python também bloqueavam ou repetiam experiências. Os investigadores acabaram por retirar a continuidade do controlo do próprio agente: um ciclo determinístico em shell reabria a mesma sessão e pedia que continuasse a melhorar o Recall@1.
A estrutura também documentava os dados, o âmbito da tarefa, o hardware disponível e a métrica de otimização. Mesmo assim, os modelos abertos tiveram dificuldades em orquestrar subagentes. O artigo relata que o GPT-OSS 120B só conseguiu criar subagentes corretamente uma vez em dezenas de tentativas, apesar de instruções explícitas e de uma extensão dedicada. As tentativas com Qwen Coder 30B também não foram fiáveis. Os agentes comerciais foram mais consistentes nesta função.
Isto muda a interpretação de «investigação autónoma». Não se tratou de deixar um modelo trabalhar livremente num laboratório. A autonomia foi construída à volta de um objetivo estreito, experiências instrumentadas, controlo de versões, um espaço de pesquisa preparado e um supervisor determinístico exterior ao modelo.
Na prática, o sistema aproxima-se mais de um serviço automático de otimização do que de um investigador artificial generalista.
A economia é interessante, mas a comparação não é direta
Os autores estimam que uma campanha de 10 a 20 experiências com Cursor Composer 2.5 custe cerca de 150 a 200 dólares em API. Campanhas equivalentes com Claude Sonnet 5 custaram aproximadamente duas a três vezes mais. As execuções com GPT-OSS evitaram custos de API porque usaram infraestrutura local.
Estes valores, porém, não incluem a preparação do repositório nem o desenvolvimento da estrutura de execução. Também não contabilizam supervisão humana, execuções falhadas, hardware GPU, construção da avaliação ou o trabalho anterior necessário para definir o problema e criar os sistemas de comparação.
Da mesma forma, «dez semanas contra dez meses» não é uma experiência controlada de produtividade. O trabalho autónomo começou quando o problema, os dados e as referências humanas já existiam, e otimizou uma métrica conhecida. O sistema humano continuou a obter melhor resultado e incorporava ideias que os agentes não conseguiram inventar.
A conclusão mais prudente é esta: quando o problema e o ciclo de medição já estão preparados, os agentes conseguem condensar uma quantidade substancial de experimentação iterativa a um custo marginal de modelo relativamente baixo.
O desenho do espaço de pesquisa importou mais do que o nome do modelo
Um dos resultados mais interessantes é que a marca do agente não definiu o limite de desempenho.
Os investigadores esperavam que Claude superasse Cursor, Cursor superasse GPT-OSS e uma equipa multiagente superasse um ciclo simples. Os resultados não confirmaram essa ordem. Várias execuções com um único agente convergiram para Recall@1 entre cerca de 0,30 e 0,34; algumas equipas multiagente ficaram abaixo, mesmo depois de realizarem muito mais experiências.
A forma como a pesquisa foi enquadrada teve mais peso. Sem orientação explícita, os agentes regressavam à afinação habitual de hiperparâmetros. Quando os investigadores expuseram variáveis de representação, geração de dados e arquitetura, a exploração alargou-se, mas continuou sobretudo limitada às opções que os humanos já tinham codificado no ambiente.
Para equipas que pretendem construir sistemas de I&D com agentes, há uma implicação prática: investir primeiro no contrato experimental. É preciso definir o que pode mudar, o que permanece invariável, como se valida um resultado, como se reverte uma falha e como se retoma uma execução interrompida. Um modelo mais capaz não compensa um ambiente de investigação mal especificado.
A autonomia atual parece mais forte como pesquisa dirigida
O artigo não demonstra autonomia científica geral. Analisa um único problema industrial de recuperação, um conjunto de dados interno, uma referência interna não publicada e um número limitado de campanhas. Os dados não podem ser auditados de forma independente e o trabalho é, por enquanto, um preprint no arXiv.
Ainda assim, o estudo é útil precisamente porque mostra capacidade e fricção ao mesmo tempo. Os agentes conseguem executar experiências disciplinadas suficientes para se aproximarem de uma referência humana forte e fazê-lo com custos diretos de modelo modestos. Mas os humanos continuam a ter de desenhar o ambiente, estabilizar a execução e fornecer a intuição estrutural necessária quando já não basta testar mais uma variante.
O modelo mais realista para o curto prazo não é, portanto, «um cientista de IA substitui o laboratório». É um ciclo de investigação governado: os humanos definem o objetivo e os limites, os agentes exploram agressivamente dentro desse espaço e os humanos intervêm quando a próxima melhoria exige uma nova ideia, não apenas mais uma experiência.
É menos espetacular do que autonomia total, mas está muito mais próximo de algo que equipas de engenharia podem implementar hoje.