
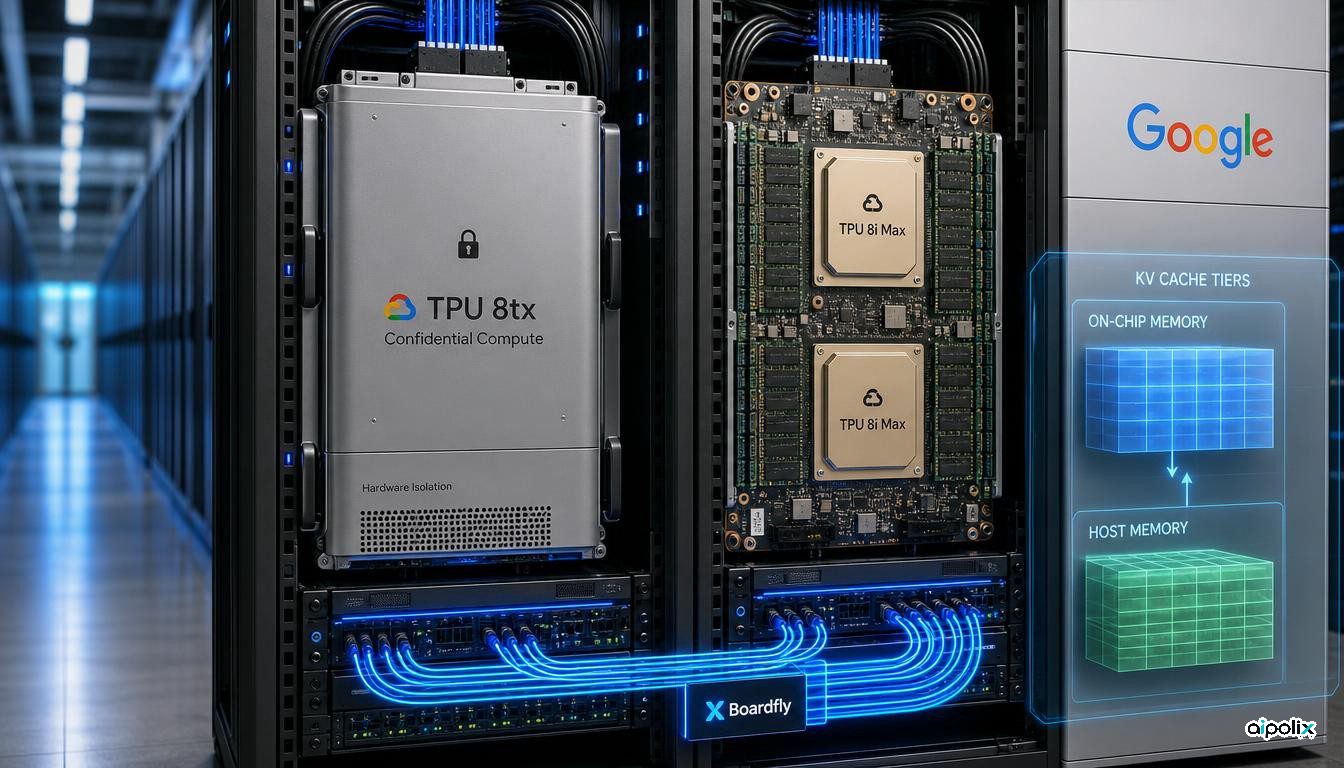
گوگل در ۹ نوامبر ۲۰۲۶ خانواده شتابدهندههای نسل هشتم خود را با دو سامانه تازهای گسترش داد که به گفته امین وحدت، معاون ارشد و فناور ارشد هوش مصنوعی و زیرساخت، برای بارهای کاری عاملها طراحی شدهاند. نخستین سامانه برای استنتاج امن و محرمانه معرفی شده و دومین سامانه دو تراشه را در یک بسته جمع میکند تا پنجرههای بافت بسیار بزرگ و چگالی محاسبه بالاتر در همان فضای رک را پوشش دهد. وحدت نوشت این نخستین سالی است که شرکت چهار سامانه از این نسل را معرفی میکند: دو سامانهای که در آوریل در رویداد ابری بهار رونمایی شدند و دو سامانهای که امروز اعلام شدند.
وحدت میان تراشه جدید، که طراحی و ساخت آن سالها طول میکشد، و سامانه جدید که بستهبندی و حافظه و شبکه و امنیت را حول سیلیکون موجود بازآرایی میکند تمایز گذاشت. سامانه محرمانه همان سیلیکون مدل آموزش این نسل را به کار میبرد و در نوشته رسمی با میزبانهای پردازنده نسل پنجم ایامدی همراه شده است. شرکت میگوید دادههای حساس و وزن مدل حتی هنگام پردازش در لایه سختافزار ایزوله میمانند و از شبکه کمتأخیر بوردفلای استفاده میشود. گوگل مدعی است تأخیر نسبت به سامانه آموزش تا دو برابر کمتر میشود و افت عملکرد نزدیک به صفر است و مشتریان میتوانند مدل را روی داده خصوصی تنظیم کنند، آن را تقطیر کنند و عاملها را با یادگیری تقویتی روی همان سامانه آموزش دهند، بدون جابهجایی داده میان خوشهها.
سامانه دوم دو تراشه استنتاج کمتأخیر را در یک بسته قرار میدهد. شرکت میگوید این کار محاسبه، حافظه روی تراشه و پهنای باند حافظه پهنباند را نسبت به نسخه تکتراشه دو برابر میکند و جا دادن دو برابر سیلیکون در رک فعلی، توان را در هر متر مربع و هر وات بالا میبرد. سامانههای آوریل همچنان پایه این نسل هستند: گوگل میگوید مدل آموزش تا ۲٫۷ برابر عملکرد بهتر نسبت به نسل قبل دارد و مدل استنتاج حدود ۸۰ درصد نسبت قیمت به عملکرد بهتری ارائه میکند. وحدت نوشت این شتابدهندهها اکنون نزدیک به صد مشتری دارند و میتوانند داخل خود شرکت، روی ابر رسمی یا در مرکز داده مشتری اجرا شوند.
همان نوشته یک پشته نرمافزاری را هم معرفی میکند که استفاده از این سامانهها را سادهتر کند. گوگل میگوید ماه گذشته پل پایتورچ را متنباز کرده تا کد و مدلهای مخزن هاگینگفیس بهصورت بومی روی این شتابدهندهها اجرا شوند، بههمراه پشتیبان برای موتورهای سرودهی متنباز شناختهشده، مجموعه آزمایشی عامل ویژه این سختافزار برای ابزارهای کدنویسی محبوب، و یک موتور سرویسدهی سطح پایین متنباز. به گفته شرکت، نرمافزار تازه مدیریت محاسبه عامل، نشستهای بیکار را معلق میکند و حافظه کاری را در چند میلیثانیه از روی تراشه خارج میکند. گوگل همچنین لایه همگامسازی حالت مدل را متنباز میکند. در نوشته مکمل بخش ابری، فنگهویی ژانگ و ویرن یو میگویند این کتابخانه در آزمونهای داخلی روی مدلهای خبره ترکیبی بزرگ، تأخیر انتقال حافظه نهان کلید-مقدار را بیش از ۹۰ درصد و زمان تا نخستین نشانه را حدود ۹۰ درصد کم میکند.
زماناجرای توزیعشدهای که آزمایشگاه عمیق این شرکت برای آموزش و ارائه مدلهای مرزی ساخته، اکنون روی موتور کوبرنتیز ابری بهصورت عمومی در دسترس است. گوگل میگوید مشتریان در نود روز گذشته بیش از صد و سی میلیون ساعتتراشه را با این زماناجرا مصرف کردهاند و پیشنمایشی آن را به خوشههای علمی نیز میرساند. برش پویا روی همان موتور ارکستراسیون نیز عمومی شده است. شرکت میگوید با سوییچ نوری، مکعبهای شتابدهنده را به توپولوژی بزرگتر میدوزد یا آنها را به برشهای جداگانه کوچکتر تقسیم میکند و زمان شروع کار را تا پنج برابر و بازیابی را تا چهار و نیم برابر نسبت به بازسازی استخرهای گره ثابت کاهش میدهد.
تمام ارقام عملکرد، تعداد مشتری و بهرهوری بالا ادعاهای خود گوگل هستند. همراه این خبر آزمون مستقلی از دو سامانه تازه منتشر نشد و بهبودهای اعلامشده برای لایه همگامسازی به آزمایشهای آزمایشگاهی ژوئیه ۲۰۲۶ برمیگردد. گوگل مخاطبان را به پخش زنده ساعت نه صبح به وقت اقیانوس آرام در روز انتشار دعوت کرد.