
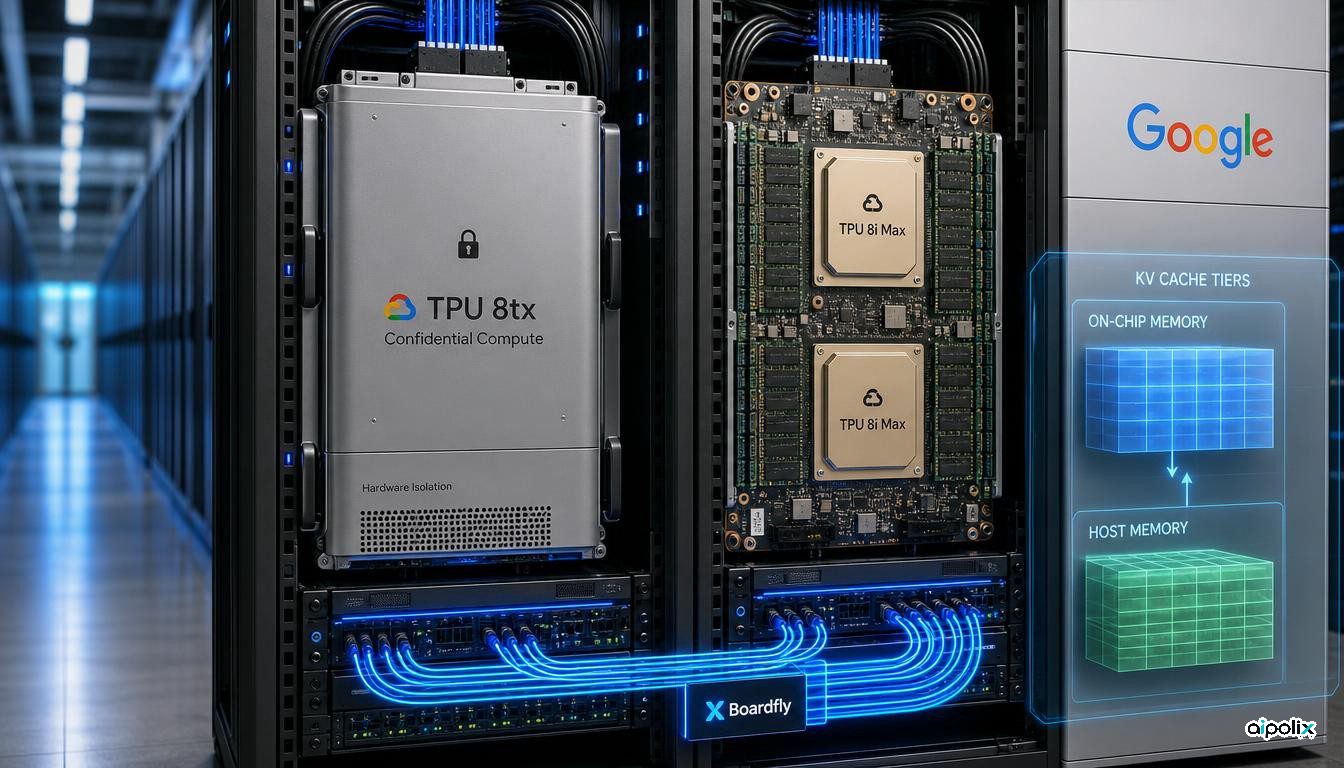
Google a élargi le 9 novembre 2026 sa famille de TPU de huitième génération avec deux systèmes destinés aux charges d'agents, selon un billet d'Amin Vahdat, vice-président senior et directeur technique pour l'intelligence artificielle et l'infrastructure. Le TPU 8tx est présenté comme une configuration pour une inférence sécurisée et confidentielle. Le TPU 8i Max assemble deux puces dans un seul boîtier, pour de très grandes fenêtres de contexte et une densité de calcul plus élevée dans le même espace de baie. Vahdat a indiqué qu'il s'agit de la première année où Google lance quatre systèmes TPU: le TPU 8t et le TPU 8i, révélés lors de Google Cloud Next en avril, puis les deux annonces du jour.
Vahdat distingue une nouvelle puce, dont la conception et la fabrication prennent des années, d'un nouveau système qui réorganise le boîtier, la mémoire, le réseau et la sécurité autour d'un silicium déjà existant. Le TPU 8tx reprend le silicium du TPU 8t et, dans le billet Google, est associé à des hôtes AMD EPYC de 5e génération. L'entreprise affirme que les données sensibles et les poids du modèle restent isolés au niveau matériel pendant le traitement, et qu'elle reprend le réseau à faible latence Boardfly. Elle revendique jusqu'à deux fois moins de latence que le TPU 8t, avec une perte de performances quasi nulle, et dit que les clients peuvent affiner des modèles, les distiller et entraîner des agents par apprentissage par renforcement sur un seul système, sans déplacer des données privées d'un cluster à l'autre.
Le TPU 8i Max place deux puces TPU 8i dans le même boîtier. Google affirme que cela double le calcul, la SRAM embarquée et la bande passante HBM par rapport au TPU 8i, et que faire tenir deux fois plus de silicium dans la baie actuelle augmente la capacité par mètre carré et par watt. Les systèmes d'avril restent la base de cette génération: Google indique que le TPU 8t offre jusqu'à 2,7 fois de meilleures performances d'entraînement que la génération précédente, et que le TPU 8i améliore d'environ 80 pour cent le rapport prix-performances en inférence. Vahdat a écrit que les TPU servent désormais près de 100 clients et peuvent tourner chez Google, sur Google Cloud ou dans le propre centre de données d'un client.
Le même texte présente une pile logicielle destinée à faciliter l'usage de ces systèmes. Google dit avoir ouvert le code de TorchTPU le mois dernier afin que le code PyTorch et les modèles Hugging Face s'exécutent nativement sur TPU, avec des backends pour vLLM et SGLang, une suite d'agents TPU en aperçu pour des outils comme Claude Code, Cursor et Google Antigravity, et un XLA Serving Engine libre. Un nouvel Agent Compute Engine, selon Google, suspend les sessions d'agents inactives et déplace la mémoire de travail hors de la puce en quelques millisecondes. Google ouvre aussi TPU Sync, décrit comme la couche d'état du modèle pour les grappes de TPU. Dans un article complémentaire sur Google Cloud, Fenghui Zhang et Weiren Yu indiquent que la bibliothèque réduit de plus de 90 pour cent la latence de transfert du cache clé-valeur et le délai avant le premier jeton, d'après des tests internes sur de grands modèles mixture-of-experts.
Cloud Pathways, l'environnement d'exécution distribué que Google DeepMind a conçu pour entraîner et servir des modèles dont Gemini, devient généralement disponible sur Google Kubernetes Engine. Google affirme que ses clients ont consommé plus de 130 millions d'heures de puces Cloud TPU avec Pathways sur GKE au cours des 90 derniers jours, et qu'un aperçu l'étend aux grappes Slurm via Cluster Director. Le découpage dynamique GKE devient lui aussi généralement disponible. L'entreprise dit s'appuyer sur la commutation optique pour assembler des cubes TPU en topologie plus large ou les partitionner en tranches isolées plus petites, ce qui réduirait jusqu'à cinq fois le démarrage des tâches et jusqu'à 4,5 fois la reprise, par rapport à la recréation de groupes de nœuds statiques.
Tous les chiffres de performances, de clients et d'efficacité ci-dessus sont des affirmations de Google. Aucun banc d'essai indépendant du TPU 8tx et du TPU 8i Max n'accompagnait l'annonce, et les gains attribués à TPU Sync proviennent d'essais de laboratoire menés par Google en juillet 2026 sur des hôtes TPU v7x. Google a invité le public à une diffusion à 9 heures, heure du Pacifique, le jour de la publication.