
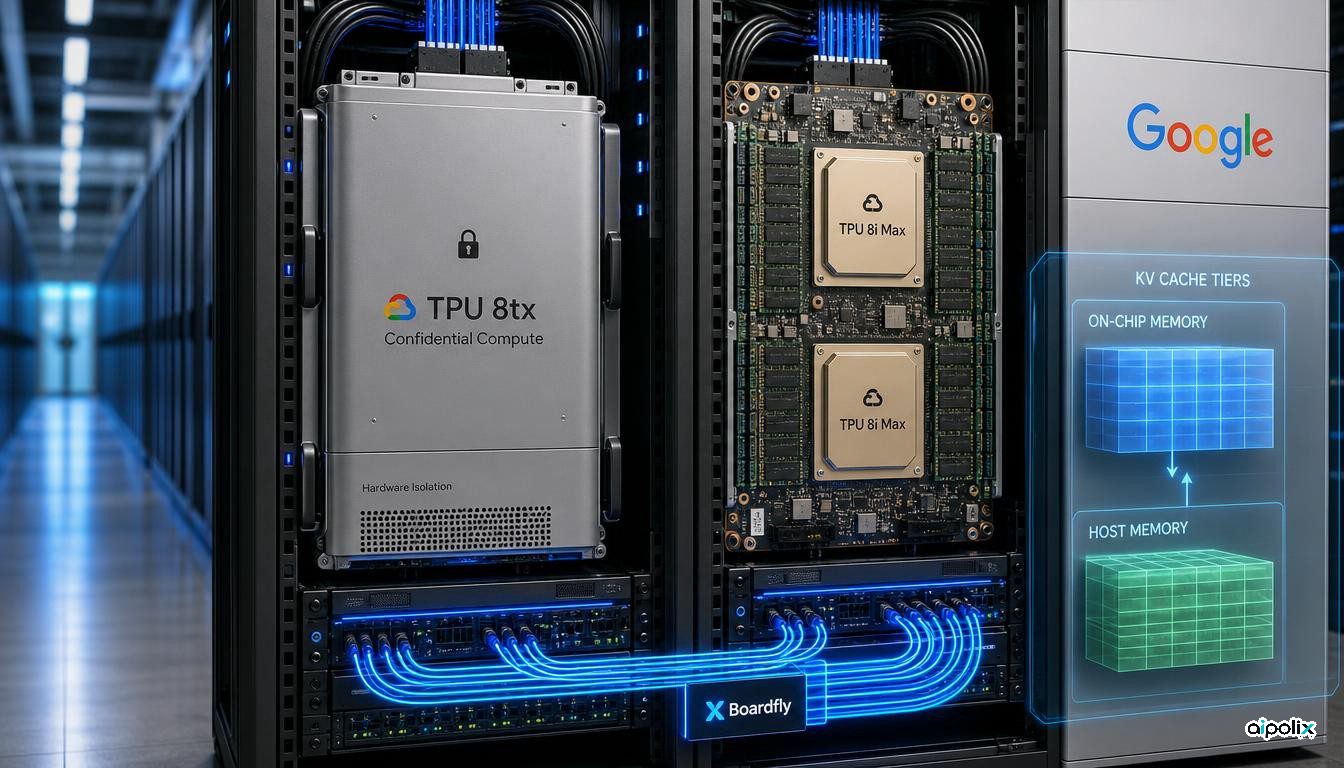
A Google alargou a 9 de novembro de 2026 a sua família TPU de oitava geração com dois sistemas pensados para cargas de agentes, segundo um artigo de Amin Vahdat, vice-presidente sénior e técnico-chefe de inteligência artificial e infraestrutura. O TPU 8tx é apresentado como uma configuração para inferência segura e confidencial. O TPU 8i Max junta dois chips num só encapsulamento, virado para janelas de contexto muito grandes e para mais capacidade de cálculo no mesmo espaço de bastidor. Vahdat afirmou que este é o primeiro ano em que a empresa apresenta quatro sistemas TPU: o TPU 8t e o TPU 8i, revelados na Google Cloud Next em abril, e os dois agora anunciados.
Vahdat distingue um chip novo, cujo desenho e fabrico levam anos, de um sistema novo que reorganiza encapsulamento, memória, rede e segurança em torno do silício já existente. O TPU 8tx usa o mesmo silício do TPU 8t e, no artigo da Google, é emparelhado com processadores anfitrião AMD EPYC de quinta geração. A empresa diz que os dados sensíveis e os pesos do modelo ficam isolados ao nível do hardware mesmo durante o processamento, e que adota a rede de baixa latência Boardfly. Alega até o dobro da redução de latência face ao TPU 8t, quase sem perda de desempenho, e afirma que os clientes podem afinar modelos, destilá-los e treinar agentes com aprendizagem por reforço no mesmo sistema, sem mover dados privados entre clusters.
O TPU 8i Max coloca dois chips TPU 8i no mesmo encapsulamento. A Google diz que isto duplica o cálculo, a SRAM no chip e a largura de banda HBM face ao TPU 8i, e que caber o dobro do silício no bastidor atual aumenta a capacidade por metro quadrado e por watt. Os sistemas de abril continuam a ser a base desta geração: a Google afirma que o TPU 8t oferece até 2,7 vezes melhor desempenho de treino do que a geração anterior e que o TPU 8i melhora cerca de 80 por cento a relação preço-desempenho na inferência. Vahdat escreveu que as TPU servem agora cerca de 100 clientes e podem correr dentro da Google, na Google Cloud ou no próprio centro de dados do cliente.
O mesmo texto apresenta uma pilha de software para facilitar o uso destes sistemas. A Google diz ter aberto o código do TorchTPU no mês passado para que código PyTorch e modelos Hugging Face corram de forma nativa nas TPU, com backends para vLLM e SGLang, um conjunto experimental de agentes TPU para ferramentas como Claude Code, Cursor e Google Antigravity, e um XLA Serving Engine de código aberto. Um novo Agent Compute Engine, segundo a empresa, suspende sessões de agentes inativas e retira a memória de trabalho do chip em milissegundos. A Google também disponibiliza em código aberto o TPU Sync, descrito como a camada de estado do modelo em clusters TPU. Num artigo complementar na Google Cloud, Fenghui Zhang e Weiren Yu afirmam que a biblioteca reduz em mais de 90 por cento a latência de transferência da cache de pares chave-valor e o tempo até ao primeiro token em testes internos com modelos mixture-of-experts de grande dimensão.
O Cloud Pathways, o runtime distribuído que a Google DeepMind usou para treinar e servir modelos incluindo o Gemini, passa a estar geralmente disponível no Google Kubernetes Engine. A Google afirma que os clientes consumiram mais de 130 milhões de horas de chip Cloud TPU com Pathways no GKE nos últimos 90 dias, e que uma pré-visualização o alarga a clusters Slurm através do Cluster Director. O fatiamento dinâmico no GKE também fica geralmente disponível. A empresa diz que usa comutação ótica para juntar cubos TPU em topologias maiores ou dividi-los em fatias isoladas mais pequenas, reduzindo o arranque dos trabalhos até cinco vezes e a recuperação até 4,5 vezes face a recriar conjuntos de nós estáticos.
Todos os números de desempenho, clientes e eficiência acima são afirmações da Google. Não foram publicados testes independentes do TPU 8tx e do TPU 8i Max com o anúncio, e os ganhos referidos para o TPU Sync resultam de ensaios de laboratório da Google em julho de 2026 em anfitriões TPU v7x. A empresa convidou o público para uma emissão às 9h00, hora do Pacífico, no dia da publicação.