
Recherche
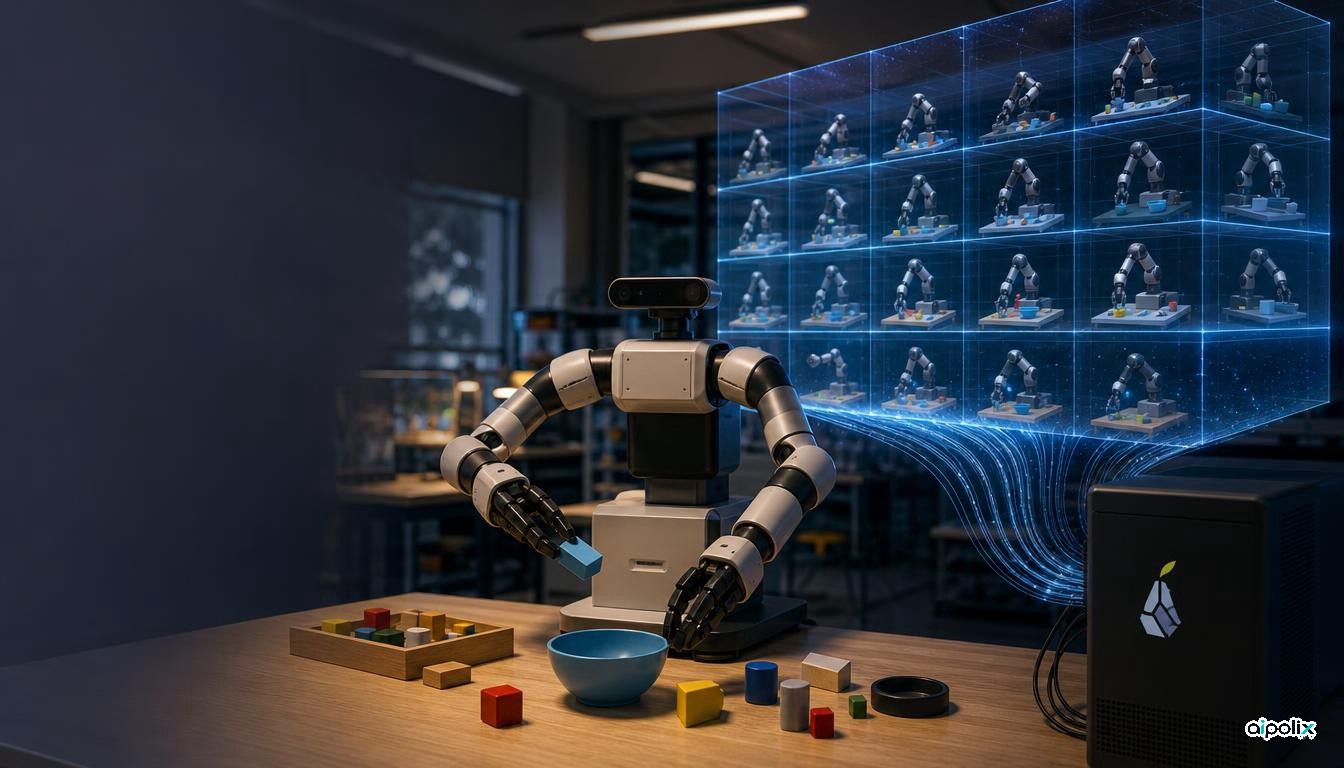
Le MIT Han Lab entraîne un modèle de raisonnement ouvert de 27B à piloter de vrais robots par le seul apprentissage par renforcement en simulation, et publie en open source le moteur PEAR
Une équipe menée par Jiaming Tang, Zhuoyang Zhang, Junxian Guo et Song Han a publié PEAR le 13 novembre 2026, avec l'article arXiv 2611.18562. À partir de Qwen3.8-27B et sans démonstration, l'apprentissage par renforceme…