
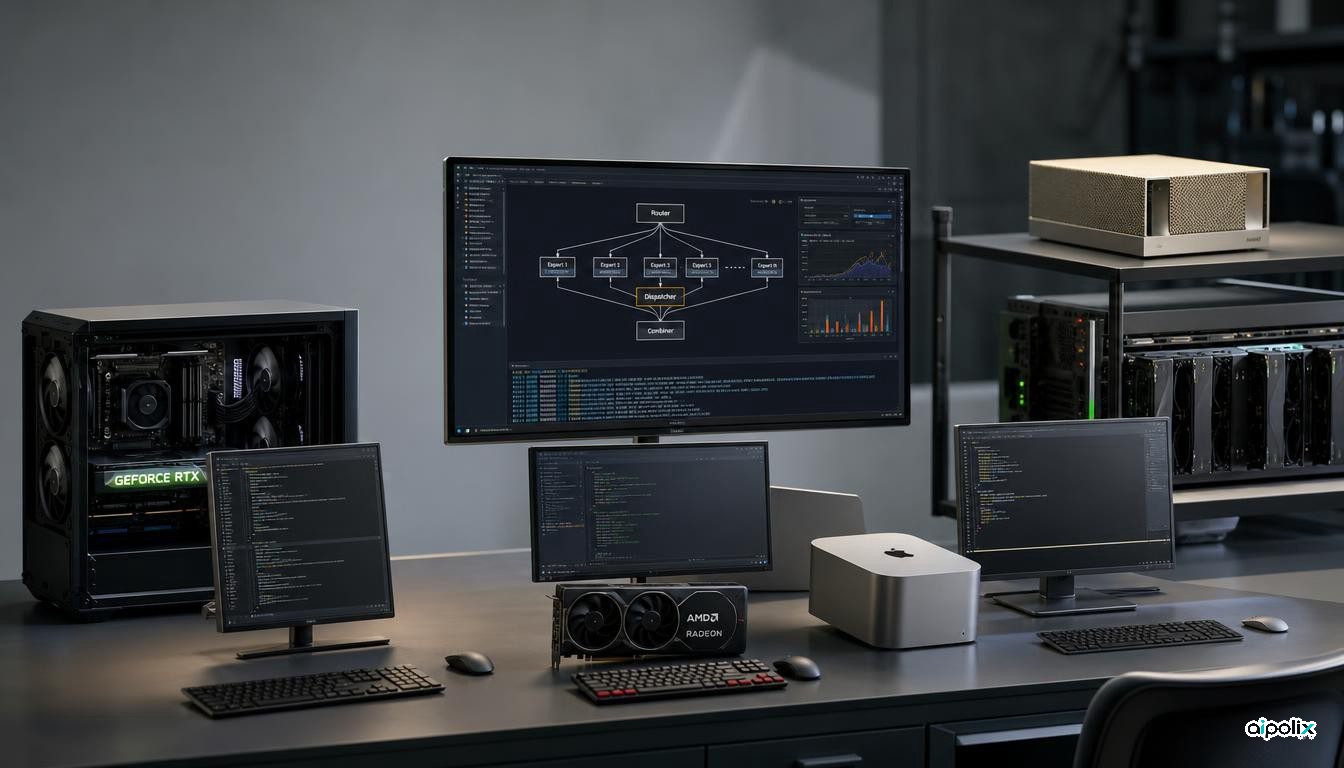
O FreeToken já é conhecido por executar modelos Mixture-of-Experts muito grandes em equipamento de consumo e de posto de trabalho, mas o desafio seguinte vai além de espremer mais parâmetros numa memória gráfica limitada. O projecto publicou agora um plano de rumo 2026 que pretende tirar o FreeToken do ambiente de execução actual centrado na NVIDIA e transformá-lo numa plataforma de IA local mais heterogénea.
O plano de rumo oficial, publicado pelos responsáveis em August 23, lista apoio nativo a Apple Silicon através de um motor Metal, a GPU AMD através de ROCm, e a DGX Spark através de rodas aarch64, núcleos sm_121 e um modo de memória unificada.
Visa também entrada de imagem multimodal para as famílias Qwen3.5, Qwen3.6, Qwen3.8 e Gemma-4, paralelismo tensorial em vários GPU, apoio GGUF mais amplo em arquitecturas de modelo e técnicas de descodificação especulativa incluindo MTP, DFlash e Dspark.
O apoio actual continua a ser só NVIDIA
O plano de rumo importa em parte porque destaca os limites do lançamento actual.
A FAQ dos responsáveis ainda define o apoio oficial como equipamento x86_64 com um GPU NVIDIA da geração Ampere em diante, na prática a série RTX 30 e mais recente, com controlador r580+ e CUDA 13. Windows e Linux são suportados através do FreeToken Desktop, enquanto o pacote Python é suportado em Linux.
A documentação de instalação torna o mesmo requisito explícito: Linux x86_64, GPU NVIDIA e CUDA 13 para o ambiente de execução empacotado.
Isso significa que AMD, macOS e DGX Spark não são produtos recém-suportados hoje. São compromissos do plano de rumo.
Esta distinção importa porque o próprio plano está marcado como trabalho em curso. Tratá-lo como anúncio de lançamento exageraria o estado actual do projecto.
Adaptações da comunidade já ensaiam o caminho AMD
O ponto interessante é que o alvo AMD já não é apenas teórico.
Um contribuidor da comunidade relatou uma adaptação Windows 11 mais ROCm a correr o FreeToken num AMD RX 9070 XT sem cadeia de ferramentas NVIDIA. O relatório diz que o carregamento do modelo, o preenchimento prévio, a descodificação, o fluxo SSE e a interface web incluída estavam todos a funcionar no ramo, com um teste Qwen2.5-3B a atingir cerca de 57 tokens per second em BF16.
Essa adaptação não é apoio oficial do repositório de origem. O mesmo relatório diz que a descarga de peritos Mixture-of-Experts ainda não tinha sido plenamente ensaiada e que vários percursos GGUF e de quantização estavam incompletos.
Um segundo relatório da comunidade foi mais longe. Num RX 9060 XT, um contribuidor afirma ter levantado de ponta a ponta o percurso packed-GGUF tanto para cargas densas como Mixture-of-Experts, ao mesmo tempo que identificou problemas de baixo nível de memória anfitriã e ponteiros de dispositivo por detrás de um aborto de descodificação com descarga em RDNA4.
Esses relatórios são úteis porque mostram que pelo menos parte da arquitectura centrada em CUDA do FreeToken pode ser adaptada a ROCm. Não provam que o apoio AMD esteja pronto para produção ou próximo de um lançamento oficial.
Porque é que o plano de rumo importa
A proposta de valor original do FreeToken é a elasticidade de equipamento: usar em conjunto a memória do GPU, a RAM do sistema, a execução em CPU e a largura de banda de interligação disponível, em vez de tratar a memória gráfica como fronteira rígida.
Esse desenho torna-se estrategicamente mais interessante se funcionar em vários fabricantes de GPU.
Hoje, a infra-estrutura de IA local está altamente fragmentada. A NVIDIA tem o ecossistema de software mais forte, mas os programadores querem cada vez mais correr modelos em computadores de secretária AMD, sistemas Apple Silicon e máquinas mais pequenas de memória unificada, sem reescrever o conjunto de disponibilização para cada plataforma.
Se o FreeToken conseguir manter o mesmo modelo de disponibilização em CUDA, ROCm e Metal, o seu papel muda. Deixaria de ser apenas um ambiente de execução especializado Mixture-of-Experts para equipamento RTX; poderia tornar-se uma camada de portabilidade para grandes modelos locais em máquinas pessoais heterogéneas.
O plano de rumo de vários GPU empurra na mesma direcção. O paralelismo tensorial permitiria a um único modelo abranger vários GPU num posto de trabalho, enquanto o apoio planeado a DGX Spark estenderia o sistema rumo a máquinas compactas de IA ligadas.
O multimodal e a descodificação especulativa alargam o alvo
O plano de rumo não é só sobre equipamento.
A entrada de imagem para modelos de língua e visão Qwen e Gemma faria o FreeToken ultrapassar os agentes locais só de texto. Um apoio GGUF mais amplo tornaria mais fácil usar o grande ecossistema existente de pontos de verificação quantizados pela comunidade, em vez de depender sobretudo de safetensors e de um conjunto mais estreito de percursos de quantização suportados.
A descodificação especulativa também pode importar para agentes interactivos. Técnicas como MTP e DFlash visam reduzir a latência de descodificação ao prever vários tokens ou sequências de rascunho à frente do modelo principal. Isso complementaria o enfoque existente do FreeToken no movimento de memória e na utilização da largura de banda.
Em conjunto, estas funções sugerem que os responsáveis tentam transformar o FreeToken de uma implementação de investigação numa plataforma mais ampla de disponibilização local.
O que vigiar a seguir
O plano é suficientemente ambicioso para que a execução importe mais do que a lista de funções.
O primeiro marco a vigiar é o apoio oficial AMD. Os ramos da comunidade mostraram que a montagem RDNA4 é possível, mas a integração no repositório de origem, o empacotamento, a cobertura de núcleos, a fiabilidade da descarga Mixture-of-Experts e o desempenho repetível continuam a ser problemas de engenharia separados.
O Apple Silicon pode ser ainda mais significativo. Um motor nativo Metal abriria o FreeToken a máquinas com grandes configurações de memória unificada, um perfil de equipamento naturalmente atractivo para modelos locais sobredimensionados.
O paralelismo tensorial em vários GPU é outro ensaio maior, porque muda o FreeToken de um ambiente de um só dispositivo mais memória anfitriã para um sistema local de disponibilização distribuída.
Por agora, o desenvolvimento-chave não é que o FreeToken passe de súbito a apoiar todas as grandes plataformas de equipamento. Não apoia. A notícia significativa é que o projecto definiu publicamente um caminho para além do lançamento só NVIDIA, e a sua comunidade já começa a validar peças desse caminho em equipamento AMD.