
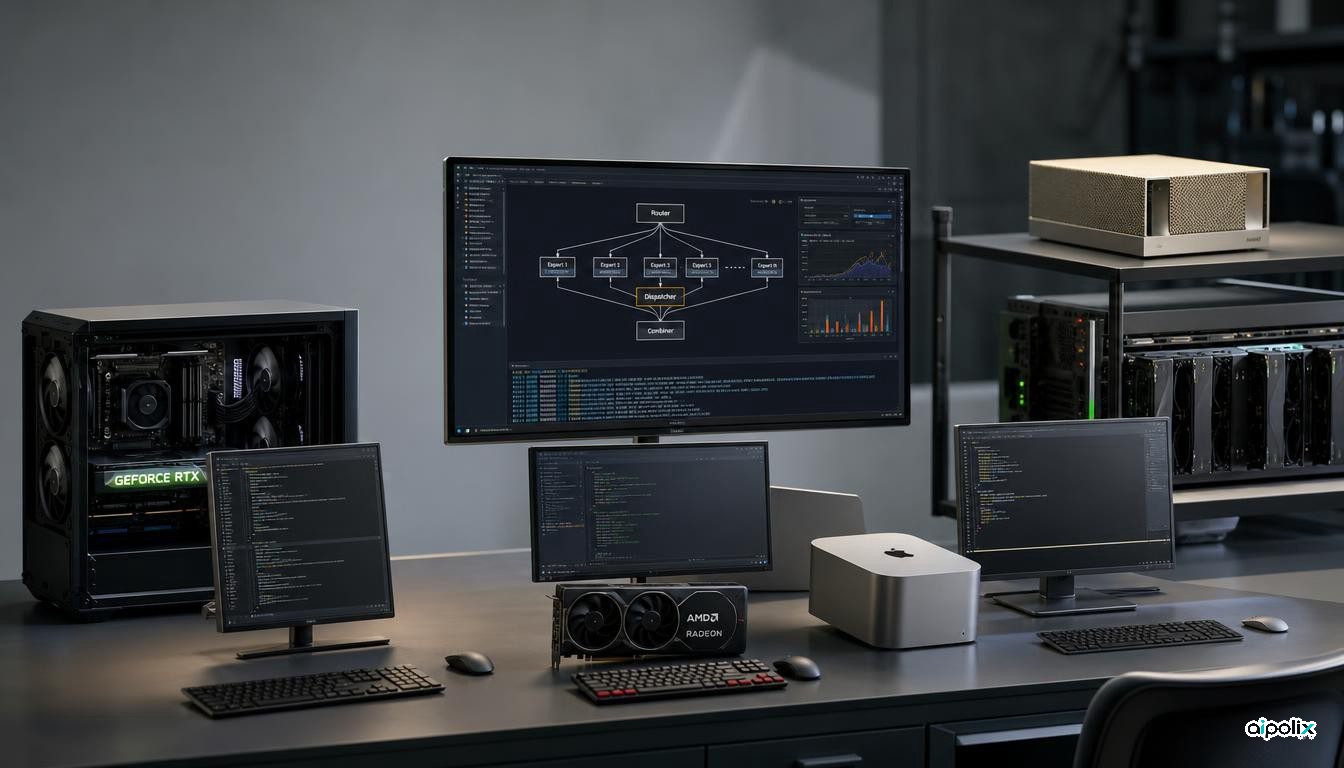
FreeToken از پیش بهخاطر اجرای مدلهای بسیار بزرگ Mixture-of-Experts روی سختافزار مصرفی و ایستگاه کاری شناخته میشود، اما چالش بعدیاش فراتر از فشردن پارامترهای بیشتر در حافظهٔ تصویری محدود است. پروژه اکنون نقشهٔ راه ۲۰۲۶ را منتشر کرده که میخواهد FreeToken را از محیط اجرای فعلی متمرکز بر NVIDIA بیرون ببرد و به سکوی ناهمگونتر هوش مصنوعی محلی تبدیل کند.
نقشهٔ راه رسمی، که نگهدارندگان در August 23 منتشر کردند، پشتیبانی بومی Apple Silicon از طریق موتور Metal، پردازندههای گرافیکی AMD از طریق ROCm، و DGX Spark از طریق چرخهای aarch64، هستههای sm_121 و حالت حافظهٔ یکپارچه را فهرست میکند.
همچنین ورود تصویر چندرسانهای برای خانوادههای Qwen3.5، Qwen3.6، Qwen3.8 و Gemma-4، موازیسازی تانسوری روی چند GPU، پشتیبانی گستردهتر GGUF در معماریهای مدل، و فنون رمزگشایی گمانی از جمله MTP، DFlash و Dspark را هدف میگیرد.
پشتیبانی فعلی همچنان فقط NVIDIA است
اهمیت نقشهٔ راه تا حدی از آن روست که محدودیتهای عرضهٔ فعلی را برجسته میکند.
پرسشهای متداول نگهدارنده هنوز پشتیبانی رسمی را سختافزار x86_64 با GPU نسل Ampere به بعد NVIDIA تعریف میکند؛ عملاً سری RTX 30 و جدیدتر، با رانندهٔ r580+ و CUDA 13. ویندوز و لینوکس از طریق FreeToken Desktop پشتیبانی میشوند و بستهٔ پایتون روی لینوکس پشتیبانی میشود.
مستندات نصب پروژه همان الزام را صریح میکند: لینوکس x86_64، GPU از NVIDIA و CUDA 13 برای محیط اجرای بستهبندیشده.
یعنی AMD، macOS و DGX Spark امروز محصولات تازهپشتیبانیشده نیستند. تعهدهای نقشهٔ راهاند.
این تمایز اهمیت دارد چون خود نقشهٔ راه بهعنوان کار در جریان علامت خورده است. تلقی آن بهعنوان اعلام عرضه، وضعیت فعلی پروژه را بیش از واقع نشان میدهد.
درگاههای جامعه مسیر AMD را از پیش میآزمایند
نکتهٔ جالب این است که هدف AMD دیگر صرفاً نظری نیست.
یک مشارکتکنندهٔ جامعه از درگاه Windows 11 بهعلاوهٔ ROCm خبر داده که FreeToken را روی AMD RX 9070 XT بدون زنجیرهٔ ابزار NVIDIA اجرا کرده است. گزارش میگوید بارگذاری مدل، پیشپرسازی، رمزگشایی، جریان SSE و رابط وب همراه همگی روی انشعاب کار میکردند و آزمون Qwen2.5-3B تقریباً به 57 tokens per second در BF16 رسیده است.
این درگاه پشتیبانی رسمی مخزن اصلی نیست. همان گزارش میگوید تخلیهٔ خبرهٔ Mixture-of-Experts هنوز کاملاً آزموده نشده و چند مسیر GGUF و کمیسازی ناتمام بودهاند.
گزارش دوم جامعه فراتر رفت. روی RX 9060 XT، یک مشارکتکننده میگوید مسیر packed-GGUF را از ابتدا تا انتها برای بارهای کاری متراکم و Mixture-of-Experts بالا آورده و همزمان مشکلات سطح پایین حافظهٔ میزبان و اشارهگر دستگاه را پشت یک فروپاشی رمزگشایی تخلیهشده روی RDNA4 شناسایی کرده است.
این گزارشها مفیدند چون نشان میدهند دستکم بخشی از معماری CUDA-محور FreeToken را میتوان به ROCm تطبیق داد. ثابت نمیکنند پشتیبانی AMD آمادهٔ تولید یا نزدیک به عرضهٔ رسمی است.
چرا نقشهٔ راه اهمیت دارد
گزارهٔ ارزش اولیهٔ FreeToken کشسانی سختافزار است: استفادهٔ همزمان از حافظهٔ GPU، RAM سامانه، اجرای CPU و پهنای باند اتصال موجود، بهجای آنکه حافظهٔ تصویری را مرز سخت بدانند.
این طراحی اگر روی چند فروشندهٔ GPU کار کند، از نظر راهبردی جذابتر میشود.
امروز زیرساخت هوش مصنوعی محلی بهشدت پراکنده است. NVIDIA نیرومندترین زیستبوم نرمافزاری را دارد، اما توسعهدهندگان بیشازپیش میخواهند مدلها را روی رایانههای رومیزی AMD، سامانههای Apple Silicon و ماشینهای کوچکتر با حافظهٔ یکپارچه اجرا کنند، بدون آنکه مجموعهٔ ارائه را برای هر سکو از نو بنویسند.
اگر FreeToken بتواند همان مدل ارائه را روی CUDA، ROCm و Metal نگه دارد، نقشش عوض میشود. دیگر فقط محیط اجرای تخصصی Mixture-of-Experts برای سختافزار RTX نخواهد بود؛ میتواند لایهٔ قابلیتحمل برای مدلهای بزرگ محلی روی ماشینهای شخصی ناهمگون شود.
نقشهٔ راه چند GPU در همان سو فشار میآورد. موازیسازی تانسوری اجازه میدهد یک مدل واحد چند GPU یک ایستگاه کاری را پوشش دهد و پشتیبانی برنامهریزیشدهٔ DGX Spark سامانه را بهسوی ماشینهای فشردهٔ متصل هوش مصنوعی امتداد میدهد.
چندرسانهای و رمزگشایی گمانی دامنهٔ هدف را گسترده میکنند
نقشهٔ راه فقط دربارهٔ سختافزار نیست.
ورود تصویر برای مدلهای زبان-بینایی Qwen و Gemma، FreeToken را از عاملهای متنی محلی فراتر میبرد. پشتیبانی گستردهتر GGUF استفاده از زیستبوم بزرگ موجود نقاط بازرسی کمیسازیشدهٔ جامعه را آسانتر میکند، بهجای اتکای عمدتاً به safetensors و مجموعهٔ باریکتری از مسیرهای کمیسازی پشتیبانیشده.
رمزگشایی گمانی نیز میتواند برای عاملهای تعاملی اهمیت داشته باشد. فنونی چون MTP و DFlash میکوشند تأخیر رمزگشایی را با پیشبینی چند توکن یا دنبالههای پیشنویس جلوتر از مدل اصلی کاهش دهند. این کار تمرکز موجود FreeToken بر جابهجایی حافظه و بهرهبرداری از پهنای باند را تکمیل میکند.
در مجموع، این قابلیتها نشان میدهند نگهدارندگان میکوشند FreeToken را از یک پیادهسازی پژوهشی به سکوی وسیعتر ارائهٔ محلی بدل کنند.
بعد چه باید دید
نقشهٔ راه بهاندازهای بلندپروازانه است که اجرا مهمتر از فهرست قابلیتهاست.
نخستین سنگنشان برای تماشا، پشتیبانی رسمی AMD است. انشعابهای جامعه نشان دادهاند برپایی RDNA4 ممکن است، اما یکپارچهسازی مخزن اصلی، بستهبندی، پوشش هسته، اطمینان تخلیهٔ Mixture-of-Experts و عملکرد تکرارپذیر مسائل مهندسی جداگانهاند.
Apple Silicon شاید حتی مهمتر باشد. یک پسزمینهٔ بومی Metal، FreeToken را به ماشینهایی با پیکربندی بزرگ حافظهٔ یکپارچه میگشاید؛ مشخصات سختافزاری که ذاتاً برای مدلهای محلی بزرگتر از اندازهٔ معمول جذاب است.
موازیسازی تانسوری چند GPU آزمون عمدهٔ دیگری است چون FreeToken را از محیط اجرای تکدستگاه بهعلاوهٔ حافظهٔ میزبان به سامانهٔ ارائهٔ محلی توزیعشده بدل میکند.
فعلاً تحول کلیدی این نیست که FreeToken ناگهان از هر سکوی سختافزاری عمده پشتیبانی میکند. نمیکند. خبر معنادار این است که پروژه آشکارا مسیری فراتر از عرضهٔ صرفاً NVIDIA تعریف کرده و جامعهاش از پیش در حال اعتبارسنجی قطعاتی از آن مسیر روی سختافزار AMD است.