
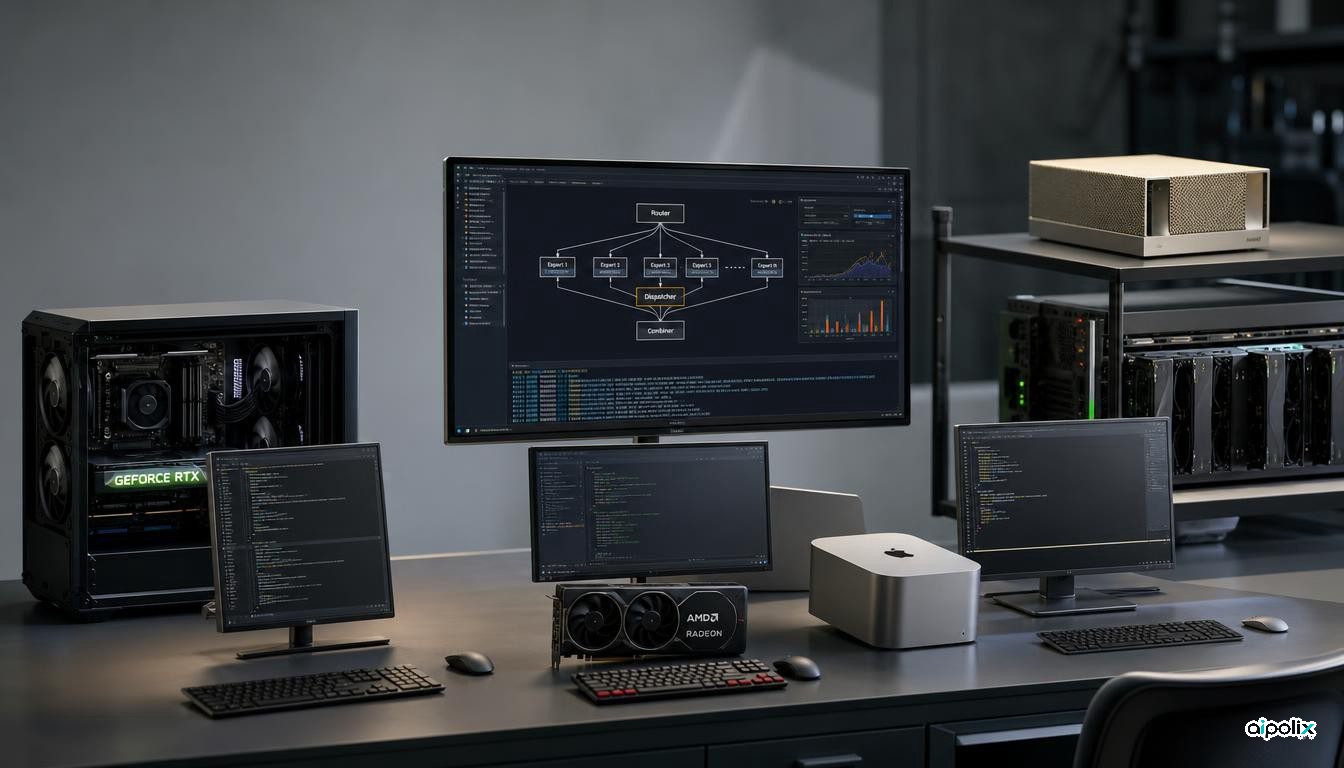
FreeToken est déjà connu pour faire tourner de très grands modèles Mixture-of-Experts sur du matériel grand public et de station de travail, mais le défi suivant dépasse le fait d’entasser davantage de paramètres dans une mémoire graphique limitée. Le projet a désormais publié une feuille de route 2026 qui vise à faire sortir FreeToken de son environnement d’exécution actuel centré sur NVIDIA et à en faire une plateforme d’IA locale plus hétérogène.
La feuille de route officielle, publiée par les mainteneurs le August 23, recense un soutien natif à Apple Silicon via un moteur Metal, aux GPU AMD via ROCm, et à DGX Spark via des roues aarch64, des noyaux sm_121 et un mode mémoire unifiée.
Elle vise aussi l’entrée d’image multimodale pour les familles Qwen3.5, Qwen3.6, Qwen3.8 et Gemma-4, le parallélisme tensoriel sur plusieurs GPU, un soutien GGUF plus large à travers les architectures de modèles, et des techniques de décodage spéculatif dont MTP, DFlash et Dspark.
Le soutien actuel reste exclusivement NVIDIA
La feuille de route compte en partie parce qu’elle met en lumière les limites de la publication actuelle.
La FAQ des mainteneurs définit encore le soutien officiel comme du matériel x86_64 avec un GPU NVIDIA de génération Ampere ou plus récente, concrètement la série RTX 30 et au-delà, avec pilote r580+ et CUDA 13. Windows et Linux sont pris en charge via FreeToken Desktop, tandis que le paquet Python l’est sous Linux.
La documentation d’installation rend la même exigence explicite : Linux x86_64, GPU NVIDIA et CUDA 13 pour l’environnement d’exécution empaqueté.
Cela signifie qu’AMD, macOS et DGX Spark ne sont pas aujourd’hui des produits nouvellement pris en charge. Ce sont des engagements de feuille de route.
Cette distinction compte parce que la feuille de route elle-même est marquée comme travail en cours. La traiter comme une annonce de mise à disposition surestimerait l’état actuel du projet.
Des portages communautaires testent déjà le chemin AMD
Le point intéressant est que la cible AMD n’est plus seulement théorique.
Un contributeur communautaire a rapporté un portage Windows 11 plus ROCm faisant tourner FreeToken sur un AMD RX 9070 XT sans chaîne d’outils NVIDIA. Le compte rendu indique que le chargement du modèle, le préremplissage, le décodage, le flux SSE et l’interface web fournie fonctionnaient tous sur la branche, un essai Qwen2.5-3B atteignant environ 57 tokens per second en BF16.
Ce portage n’est pas un soutien officiel du dépôt d’origine. Le même compte rendu indique que le déchargement d’experts Mixture-of-Experts n’avait pas encore été pleinement essayé et que plusieurs parcours GGUF et de quantification étaient incomplets.
Un second compte rendu communautaire est allé plus loin. Sur un RX 9060 XT, un contributeur dit avoir fait monter de bout en bout le parcours packed-GGUF pour des charges à la fois denses et Mixture-of-Experts, tout en identifiant des problèmes de bas niveau de mémoire hôte et de pointeurs de périphérique derrière un plantage de décodage avec déchargement sur RDNA4.
Ces comptes rendus sont utiles parce qu’ils montrent qu’au moins une partie de l’architecture centrée sur CUDA de FreeToken peut être adaptée à ROCm. Ils ne prouvent pas que le soutien AMD soit prêt pour la production ou proche d’une publication officielle.
Pourquoi la feuille de route compte
La proposition de valeur d’origine de FreeToken est l’élasticité matérielle : utiliser ensemble la mémoire GPU, la RAM système, l’exécution CPU et la bande passante d’interconnexion disponible, plutôt que de traiter la mémoire graphique comme une frontière dure.
Cette conception devient plus intéressante stratégiquement si elle fonctionne chez plusieurs fabricants de GPU.
Aujourd’hui, l’infrastructure d’IA locale est très fragmentée. NVIDIA a l’écosystème logiciel le plus fort, mais les développeurs veulent de plus en plus faire tourner des modèles sur des bureaux AMD, des systèmes Apple Silicon et des machines plus petites à mémoire unifiée, sans réécrire l’ensemble de mise à disposition pour chaque plateforme.
Si FreeToken peut conserver le même modèle de mise à disposition sur CUDA, ROCm et Metal, son rôle change. Il ne serait plus seulement un environnement d’exécution spécialisé Mixture-of-Experts pour le matériel RTX ; il pourrait devenir une couche de portabilité pour de grands modèles locaux sur des machines personnelles hétérogènes.
La feuille de route multi-GPU pousse dans la même direction. Le parallélisme tensoriel permettrait à un seul modèle de s’étendre sur plusieurs GPU dans une station de travail, tandis que le soutien prévu à DGX Spark étendrait le système vers des machines d’IA compactes reliées.
Le multimodal et le décodage spéculatif élargissent la cible
La feuille de route ne concerne pas seulement le matériel.
L’entrée d’image pour les modèles langue-vision Qwen et Gemma ferait passer FreeToken au-delà des agents locaux uniquement textuels. Un soutien GGUF plus large faciliterait l’usage du vaste écosystème existant d’instantanés quantifiés par la communauté, plutôt que de s’appuyer surtout sur safetensors et un ensemble plus étroit de parcours de quantification pris en charge.
Le décodage spéculatif peut aussi compter pour les agents interactifs. Des techniques comme MTP et DFlash visent à réduire la latence de décodage en prédisant plusieurs jetons ou des séquences brouillon en avance du modèle principal. Cela compléterait l’accent déjà mis par FreeToken sur le mouvement mémoire et l’utilisation de la bande passante.
Ensemble, ces fonctions suggèrent que les mainteneurs tentent de faire passer FreeToken d’une implémentation de recherche à une plateforme plus large de mise à disposition locale.
Ce qu’il faut surveiller ensuite
La feuille de route est assez ambitieuse pour que l’exécution importe davantage que la liste de fonctions.
Le premier jalon à surveiller est le soutien officiel AMD. Les branches communautaires ont montré qu’une mise en route RDNA4 est possible, mais l’intégration dans le dépôt d’origine, l’empaquetage, la couverture des noyaux, la fiabilité du déchargement Mixture-of-Experts et des performances reproductibles restent des problèmes d’ingénierie distincts.
Apple Silicon peut être encore plus significatif. Un moteur Metal natif ouvrirait FreeToken à des machines aux grandes configurations de mémoire unifiée, un profil matériel naturellement attractif pour des modèles locaux surdimensionnés.
Le parallélisme tensoriel multi-GPU est un autre essai majeur, parce qu’il fait passer FreeToken d’un environnement à un seul périphérique plus mémoire hôte à un système local de mise à disposition distribuée.
Pour l’instant, le fait saillant n’est pas que FreeToken soutienne soudain toutes les grandes plateformes matérielles. Ce n’est pas le cas. La nouvelle qui compte est que le projet a publiquement défini un chemin au-delà de sa mise à disposition uniquement NVIDIA, et que sa communauté commence déjà à valider des morceaux de ce chemin sur du matériel AMD.