Investigação
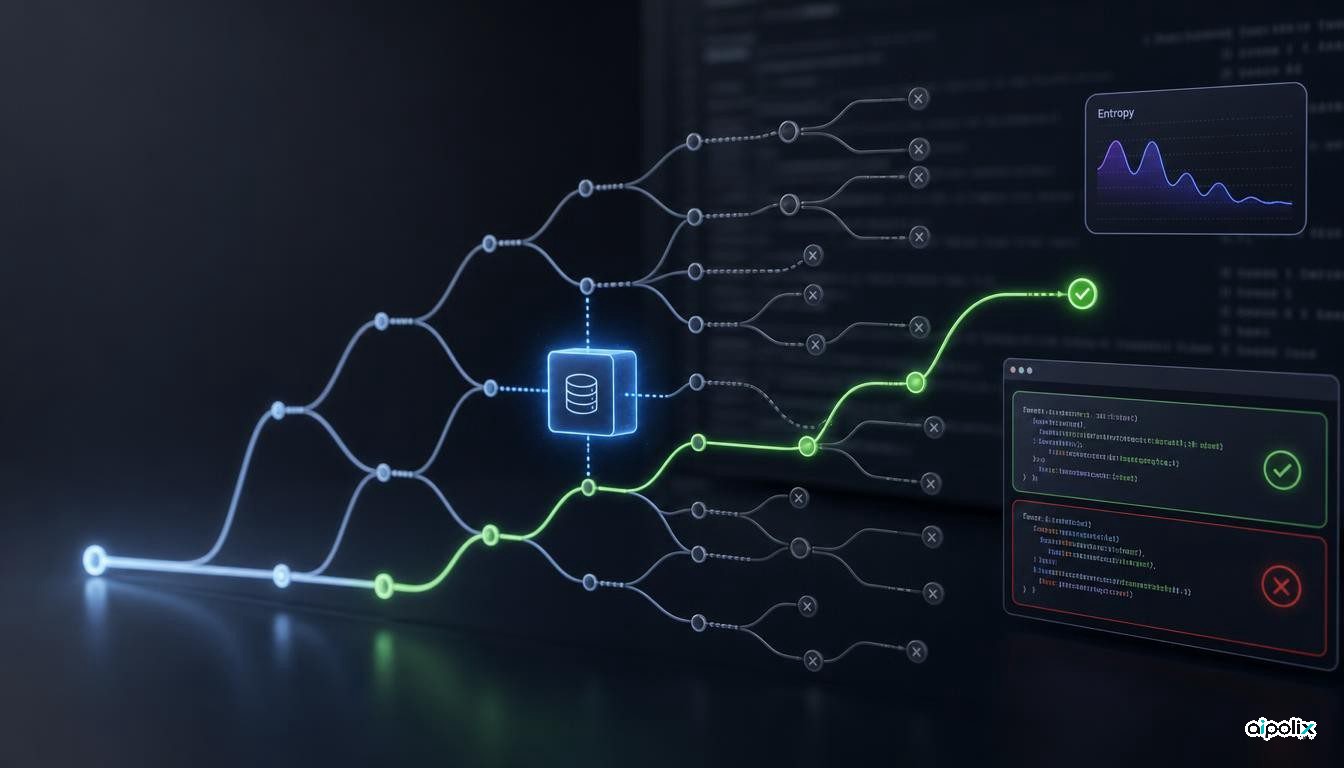
FLEET transforma amostragem repetida de LLM em pesquisa com memória
FLEET reporta melhor Pass@32 no LiveCodeBench e cerca de 3× de eficiência de amostragem ao reutilizar informação de trajetórias anteriores.

FLEET reporta melhor Pass@32 no LiveCodeBench e cerca de 3× de eficiência de amostragem ao reutilizar informação de trajetórias anteriores.
Home, Code, Autopilot e Managed Runtime transformam o Copilot numa camada governada para executar software e agentes persistentes.
Foundry Routines oferece execução agendada e orientada por eventos com identidade, histórico e continuação geridos.
Rollouts e Security Review estendem os agentes Cursor à saúde das implementações e à análise contextual de vulnerabilidades.
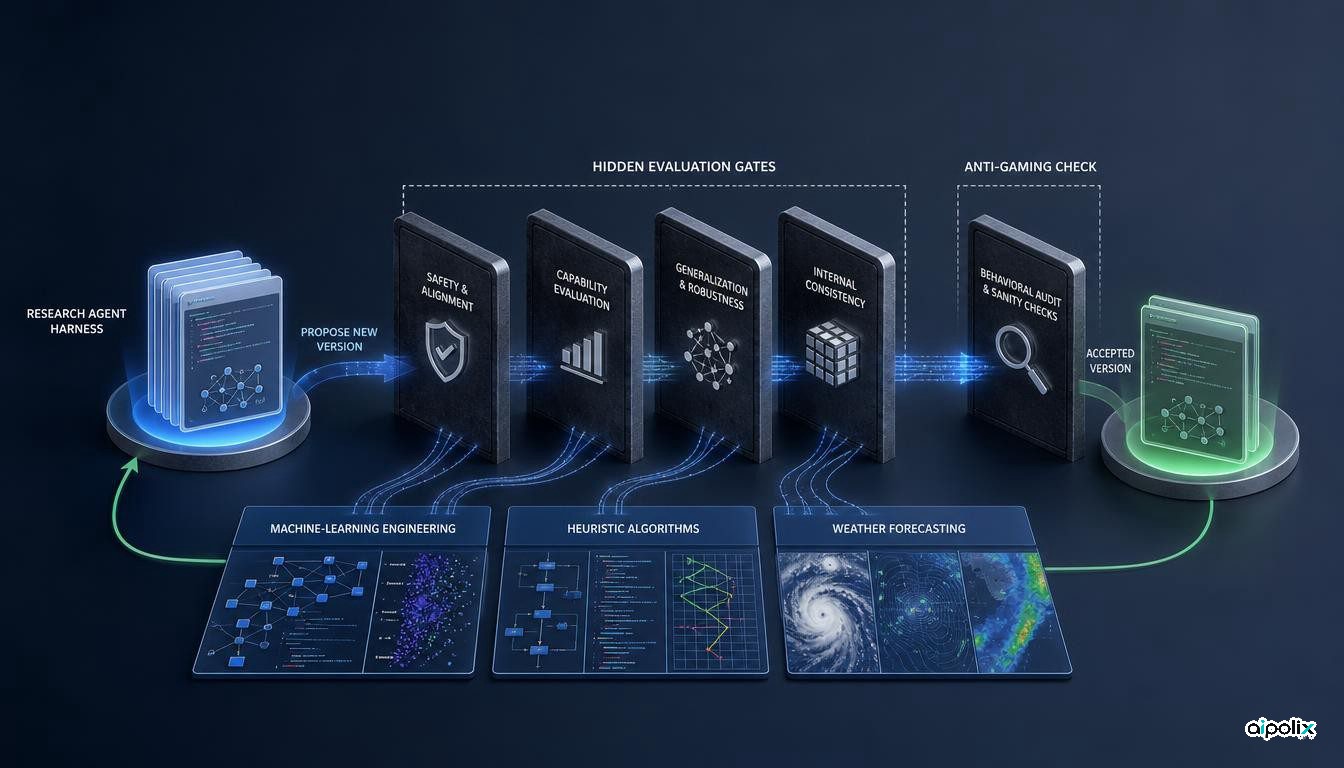
O AIDE² reescreveu o próprio harness durante oito dias e transferiu ganhos para testes reservados. A principal fronteira de controlo continua a ser a qualidade da avaliação.
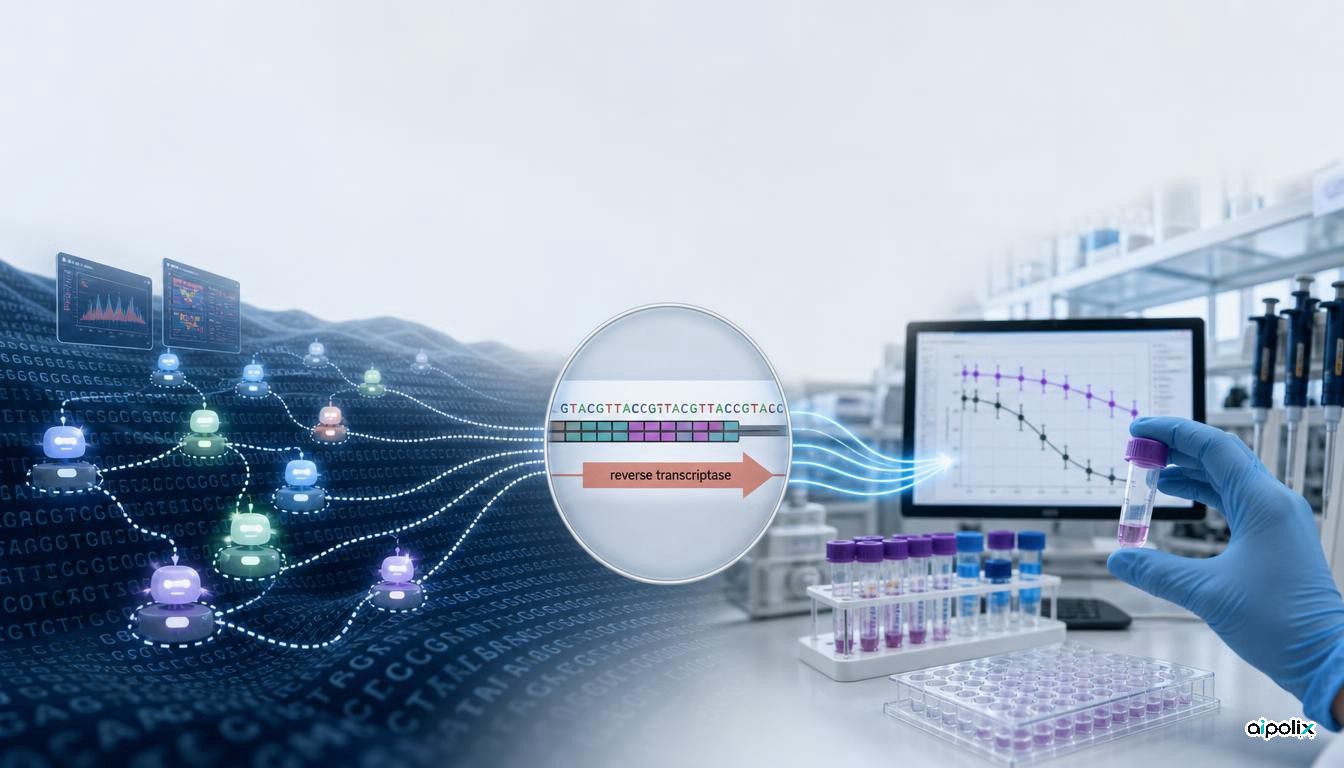
A Anthropic diz que agentes Claude encontraram um sistema enzimático desconhecido. A validação inicial é promissora, mas a função de ART continua por determinar.
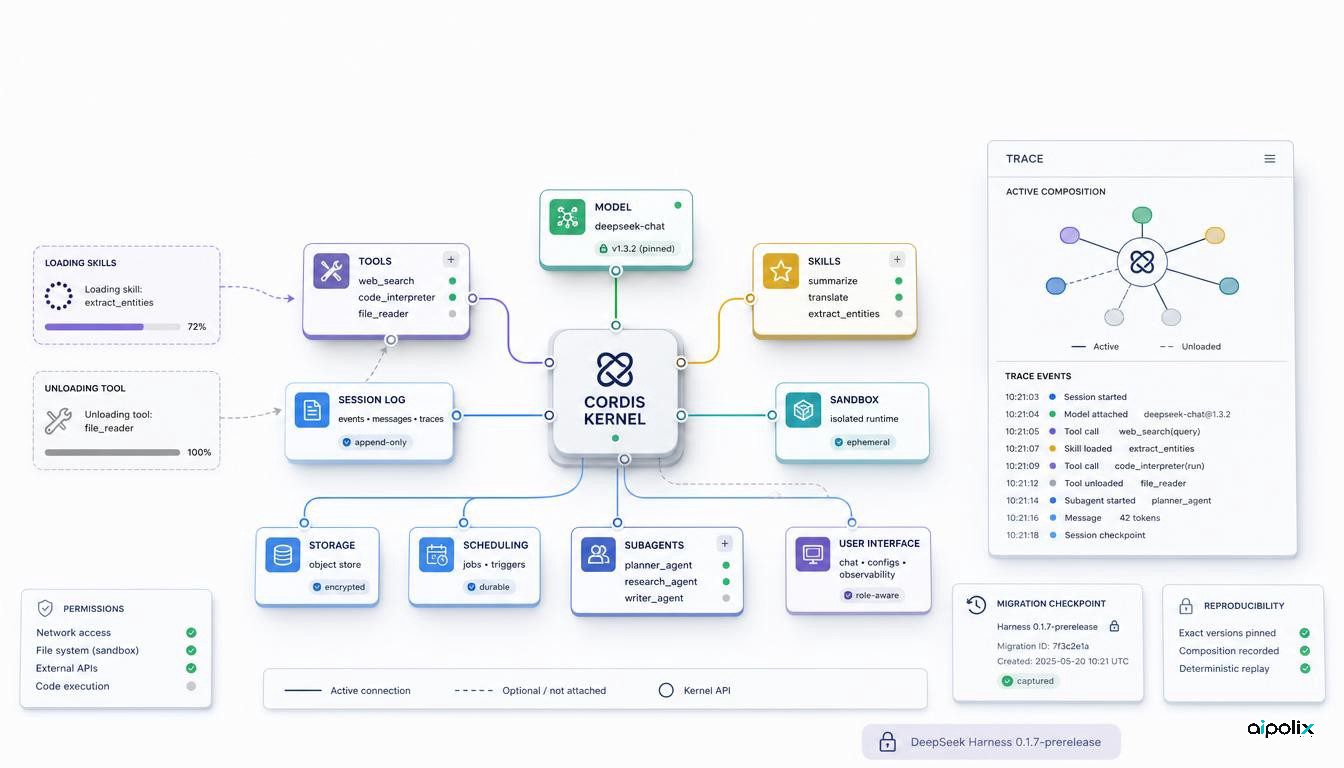
DeepSeek Harness 0.1.7 torna as capacidades de agentes mais componíveis em execução. Aipolix analisa os benefícios e riscos operacionais.
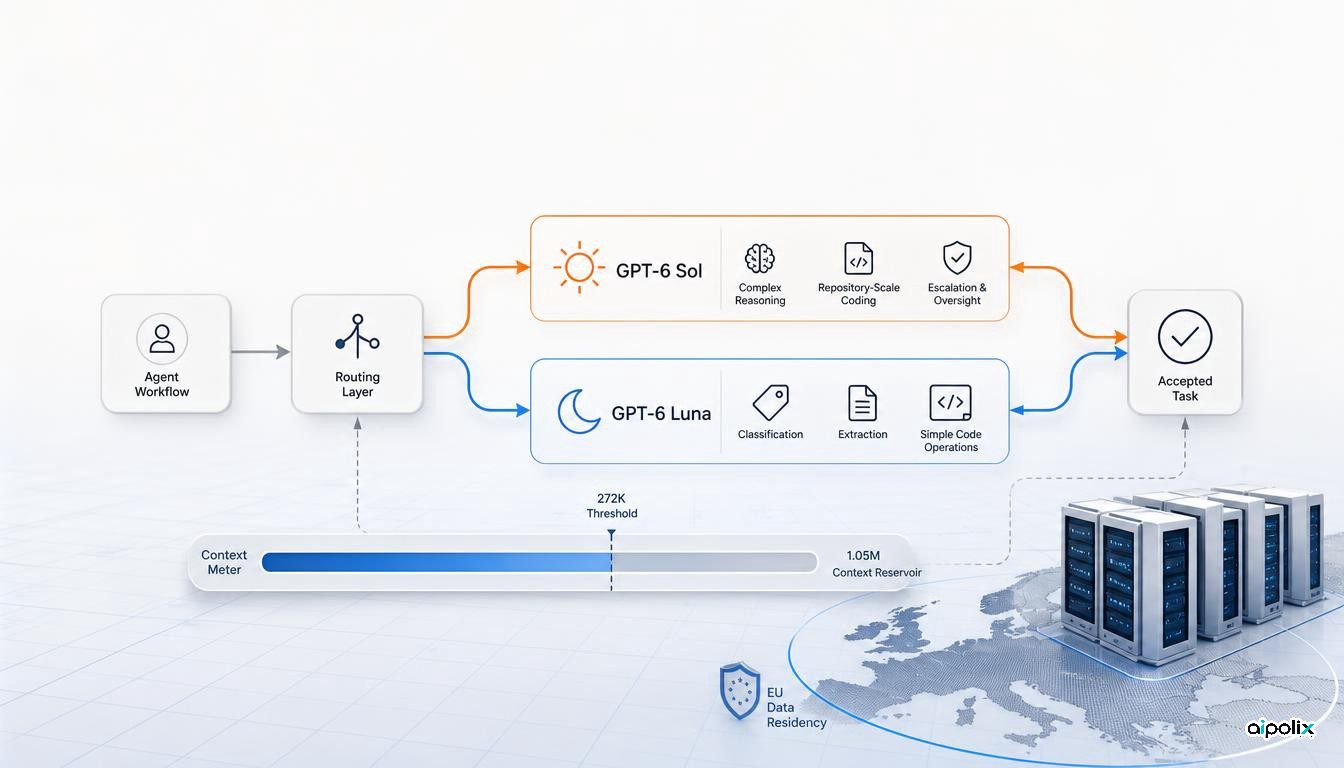
GPT-6 Sol e Luna criam uma diferença de preço de vinte vezes. Aipolix analisa encaminhamento, contexto longo e custo por tarefa.
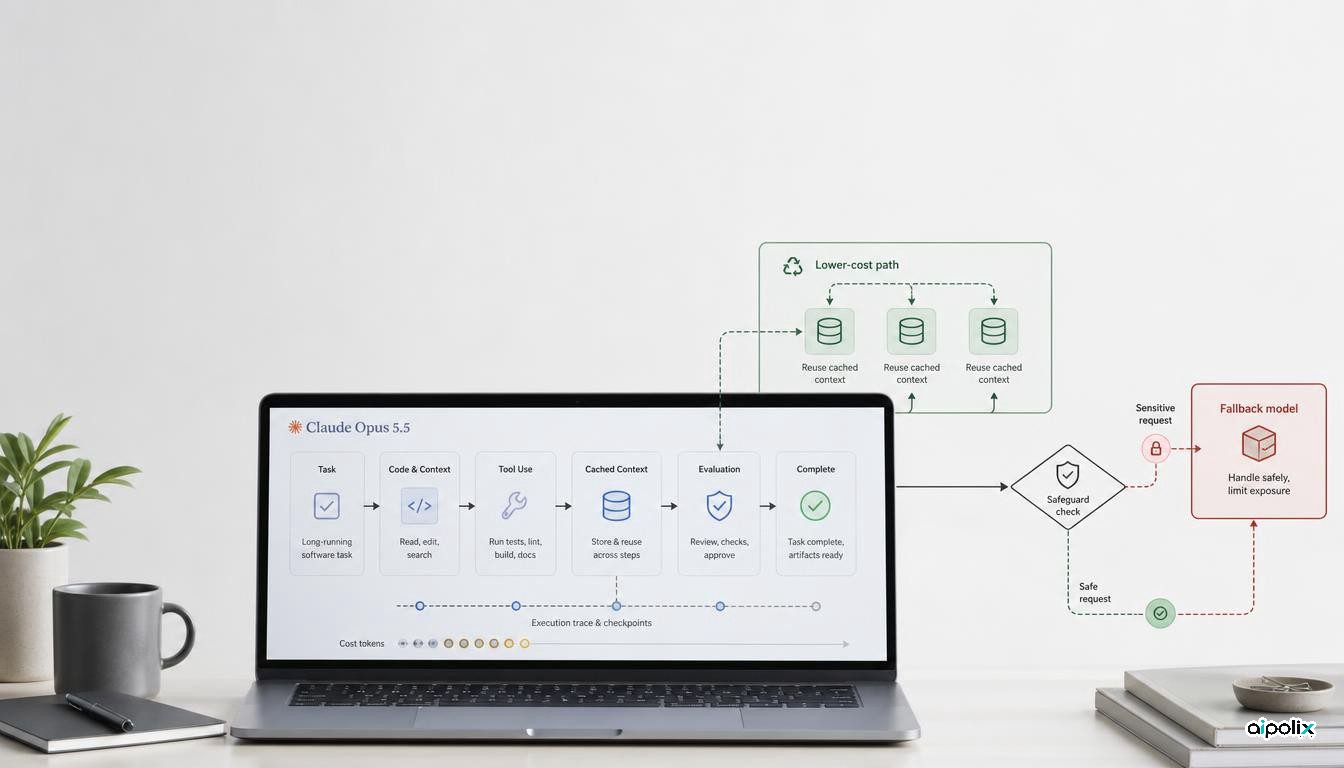
Opus 5.5 baixa preços e pode encaminhar pedidos sensíveis para modelos alternativos. Aipolix analisa o efeito na avaliação de agentes.
O Grok 4.7 mantém o preço base, mas pode consumir mais tokens e ter custos distintos para pedidos longos na xAI e no Cursor.