
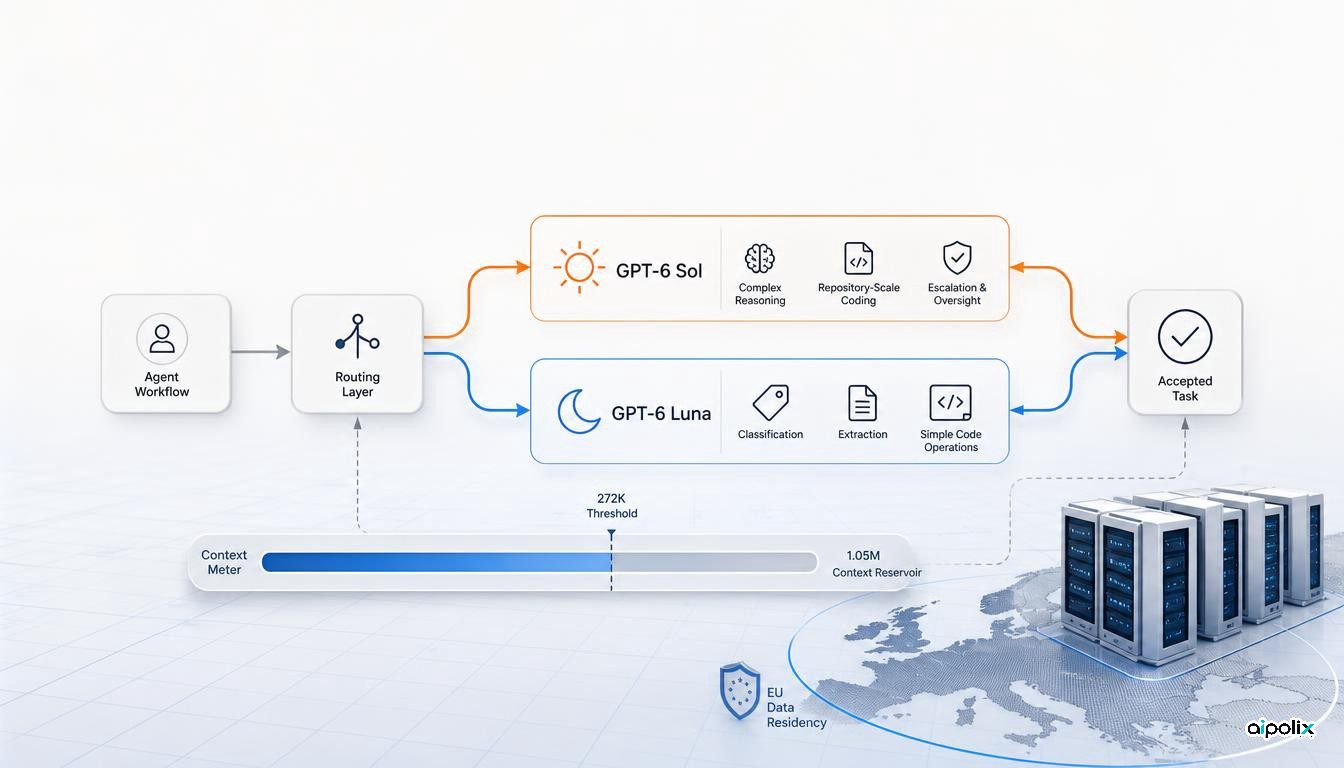
A OpenAI lançou o GPT-6 Sol e o GPT-6 Luna a 22 de setembro, dois modelos da família GPT-6 dirigidos a raciocínio, programação e sistemas com agentes. A diferença de preço entre ambos é suficientemente grande para transformar o encaminhamento entre modelos numa decisão de arquitetura, e não apenas numa pequena otimização.
Em processamento Standard e para pedidos até 272 mil tokens de entrada, o GPT-6 Sol custa 2 dólares por milhão de tokens de entrada, 0,20 dólares por milhão de tokens em cache e 10 dólares por milhão de tokens de saída. O GPT-6 Luna custa 0,10, 0,01 e 0,50 dólares, respetivamente. Ambos recebem texto e imagem e produzem texto através da Responses API e de Chat Completions.
Luna altera o custo das etapas rotineiras
Na tarifa Standard, entrada e saída do Luna custam vinte vezes menos do que no Sol. Para um agente que faz muitas classificações, extrações, passos de planeamento ou alterações simples de código, enviar tudo para o modelo mais forte deixa de ser uma escolha óbvia.
A análise da Aipolix é que o encaminhamento deve ser medido ao nível do workflow completo. Luna pode tratar etapas rotineiras e Sol os casos difíceis, mas apenas se o modelo mais barato não provocar repetições, decisões intermédias erradas ou mais revisão humana. A métrica útil é o custo por tarefa aceite.
Isto é particularmente importante em agentes, porque um único pedido pode desencadear dezenas de chamadas: planeamento, seleção de ferramentas, alterações, verificação e novas tentativas.
Sol mantém contexto muito grande para trabalho exigente
A documentação da OpenAI apresenta o GPT-6 Sol para programação complexa e workflows com agentes. O modelo tem uma janela de contexto de 1,05 milhões de tokens e permite até 128 mil tokens de saída. O esforço de raciocínio pode ser configurado entre none e max.
Um contexto tão grande pode reduzir a necessidade de cortar agressivamente um repositório, documentos extensos ou o histórico de uma sessão. Mas a utilização acima de 272 mil tokens tem outro preço. A OpenAI duplica as tarifas de entrada e cache e aumenta em 50% a saída para todo o pedido.
Assim, o limiar dos 272 mil tokens passa a ser também uma fronteira arquitetural. Convém medir se o contexto adicional reduz erros, repetições ou complexidade de recuperação em grau suficiente para justificar o custo.
As arquiteturas API atuais conseguem testar os dois modelos
Sol e Luna estão disponíveis na Responses API e em Chat Completions. A OpenAI recomenda Responses API para ferramentas integradas e chamadas de funções com Sol. A entrada de imagem também permite agentes que trabalham com capturas de ecrã e documentos visuais.
Uma equipa que já utiliza Responses API não precisa de adotar um novo protocolo. Pode introduzir Sol e Luna como destinos de uma política de encaminhamento e fazer comparações mantendo iguais ferramentas, permissões, instruções e critérios de aceitação.
A residência de dados introduz uma restrição europeia
A tabela atual da OpenAI indica que a residência de dados na União Europeia para Sol e Luna só está disponível com processamento Standard. O processamento regional tem uma sobretaxa de 10% quando aplicável.
Para organizações europeias, incluindo empresas portuguesas, o custo deve ser calculado com o modo de processamento realmente necessário em produção. O nível teoricamente mais barato pode não estar disponível quando existe uma exigência de residência de dados.
Chamadas mais baratas não substituem a engenharia do agente
Reduzir o preço de cada chamada facilita a experimentação, mas não resolve fiabilidade, permissões ou gestão de estado. Controlos de ferramentas, avaliações, pontos de recuperação e tratamento de falhas continuam essenciais.
A maior oportunidade do Luna é permitir muito mais inferência dentro do mesmo orçamento. O risco é assumir que isso reduz automaticamente o custo de uma tarefa completa. Uma decisão fraca no início pode gerar várias chamadas adicionais.
O que medir antes de alterar produção?
Uma avaliação prática deve comparar o modelo atual com duas configurações: Sol em todas as etapas e Luna com escalada para Sol. Ferramentas e políticas devem manter-se iguais. Registe tarefas aceites, escaladas, repetições, chamadas a ferramentas, utilização de contexto longo, latência e revisão humana.
O lançamento é relevante porque a OpenAI aumentou muito a diferença de preços dentro da mesma família de modelos de raciocínio. A arquitetura mais eficiente não será necessariamente a que usa o modelo mais potente em todo o lado, mas a que aplica essa capacidade onde ela muda o resultado final.