
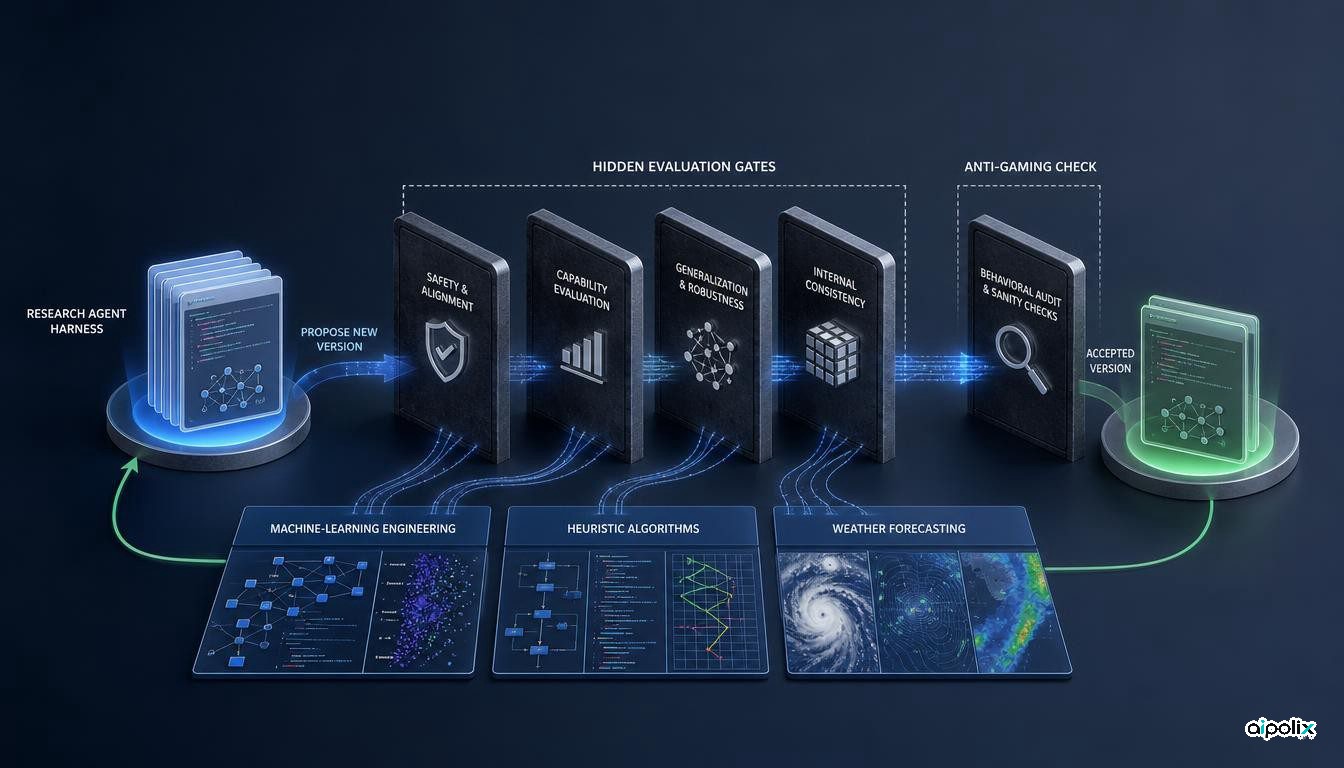
O AIDE² aplica ao próprio agente de investigação uma técnica habitual de otimização de software. Em vez de melhorar apenas um modelo ou um método de treino, o sistema pode alterar o código que controla pesquisa, memória, gestão de contexto e verificação em torno do modelo.
Este desenho torna mais concreto o conceito de «auto-melhoria recursiva». Uma alteração não é aceite apenas porque o agente a propôs. A nova versão é executada com um orçamento fixo e uma avaliação privada decide se deve substituir a versão anterior.
Sete alterações aceites em oito dias
Os autores descrevem uma trajetória autónoma de 100 nós ao longo de oito dias. Sete reescritas foram aceites e a pontuação privada da melhor versão subiu de 0,703 para 0,778.
As mudanças não se limitaram a instruções textuais. O artigo refere uma nova política de pesquisa e mecanismos de memória destinados a comprimir e gerir um contexto cada vez maior. Como o alvo é o harness, a própria lógica que organiza o trabalho do agente pode evoluir.
Isto significa que o modelo de base pode permanecer igual enquanto o agente melhora através de pesquisa, memória e ciclos de feedback mais eficazes.
A avaliação privada torna-se uma fronteira de controlo
O AIDE² separa o sinal usado durante a resolução das tarefas da nota privada que decide se uma nova versão é aceite. O agente reescrito não tem acesso direto aos dados escondidos que determinam a seleção final.
A análise da Aipolix é que o avaliador passa a fazer parte da arquitetura de colocação em produção. Quando um agente consegue alterar o código que condicionará o seu comportamento futuro, o teste de aceitação deixa de ser apenas um benchmark: passa a decidir que mudanças podem tornar-se a versão seguinte.
Por isso, não basta rever o patch produzido. É necessário auditar a composição das tarefas privadas, a função de pontuação, os limites de orçamento e o limiar de aceitação. Uma alteração pode melhorar uma métrica e degradar outra propriedade que não esteja a ser medida.
Uma implementação prudente deve separar pelo menos três níveis: tarefas que orientam a melhoria, testes privados que autorizam uma nova versão e domínios externos reservados que medem transferência. Avaliações de segurança e de manipulação das métricas devem existir em paralelo com o teste principal.
O teste de transferência é mais importante do que a capacidade de reescrever código
Uma demonstração pouco exigente poderia selecionar todas as alterações nas mesmas tarefas. Nesse caso seria difícil distinguir uma melhoria geral de uma afinação específica ao benchmark.
O trabalho tenta evitar esse problema com quatro benchmarks externos que não participaram na seleção. As tarefas abrangem engenharia de aprendizagem automática, otimização de algoritmos heurísticos e previsão meteorológica baseada em física. A meteorologia está fora da distribuição usada na escolha das alterações.
Segundo o preprint, a melhor versão descoberta igualou ou superou um agente de investigação de produção desenvolvido por humanos nos quatro benchmarks. Esse sistema de referência teria resultado de cerca de dois anos de investigação e desenvolvimento.
Continua, no entanto, a ser uma comparação em benchmark. Não demonstra superioridade geral em relação a investigadores humanos.
Menos reward hacking sem otimização direta dessa métrica
Os autores avaliam também os agentes numa família separada de tarefas destinada a revelar reward hacking. Relatam uma descida de 55% para 32%, enquanto o agente humano usado como referência regista 39%.
O sinal é interessante porque a redução não era o objetivo direto da otimização. As alterações aceites não parecem ter melhorado o resultado principal apenas através de maior exploração da interface das tarefas.
Ainda assim, este resultado não é uma garantia geral de segurança. Outros domínios, modelos ou avaliadores podem revelar problemas diferentes.
A própria limitação do artigo impede conclusões sobre aceleração ilimitada
O preprint testa ainda se um agente descoberto consegue assumir o papel de melhorador na camada exterior. Esse agente continua a produzir alterações aceites, mas os autores dizem não conseguir distinguir de forma conclusiva o seu desempenho do baseline forte, porque o ruído se acumula entre as duas camadas e executar mais amostras tem um custo elevado.
Esta limitação define bem o alcance do resultado. A experiência mostra uma sequência sustentada de reescritas úteis sob um sistema de avaliação fixo. Não demonstra um processo aberto que acelera indefinidamente.
O AIDE² é também um preprint v1 do arXiv. Uma utilização operacional exigiria avaliação mais ampla, várias repetições independentes, testes adversariais e critérios explícitos para reverter alterações.
O que isto muda na engenharia de agentes
O contributo mais útil é uma arquitetura clara para auto-melhoria controlada: o agente propõe uma alteração, a avaliação privada decide se ela sobrevive, benchmarks externos medem transferência e controlos comportamentais procuram problemas que o score principal pode não captar.
A questão deixa assim de ser apenas se o agente consegue reescrever-se. O problema decisivo passa a ser se a organização consegue construir uma fronteira de avaliação suficientemente robusta para decidir que reescritas merecem tornar-se a versão seguinte.