
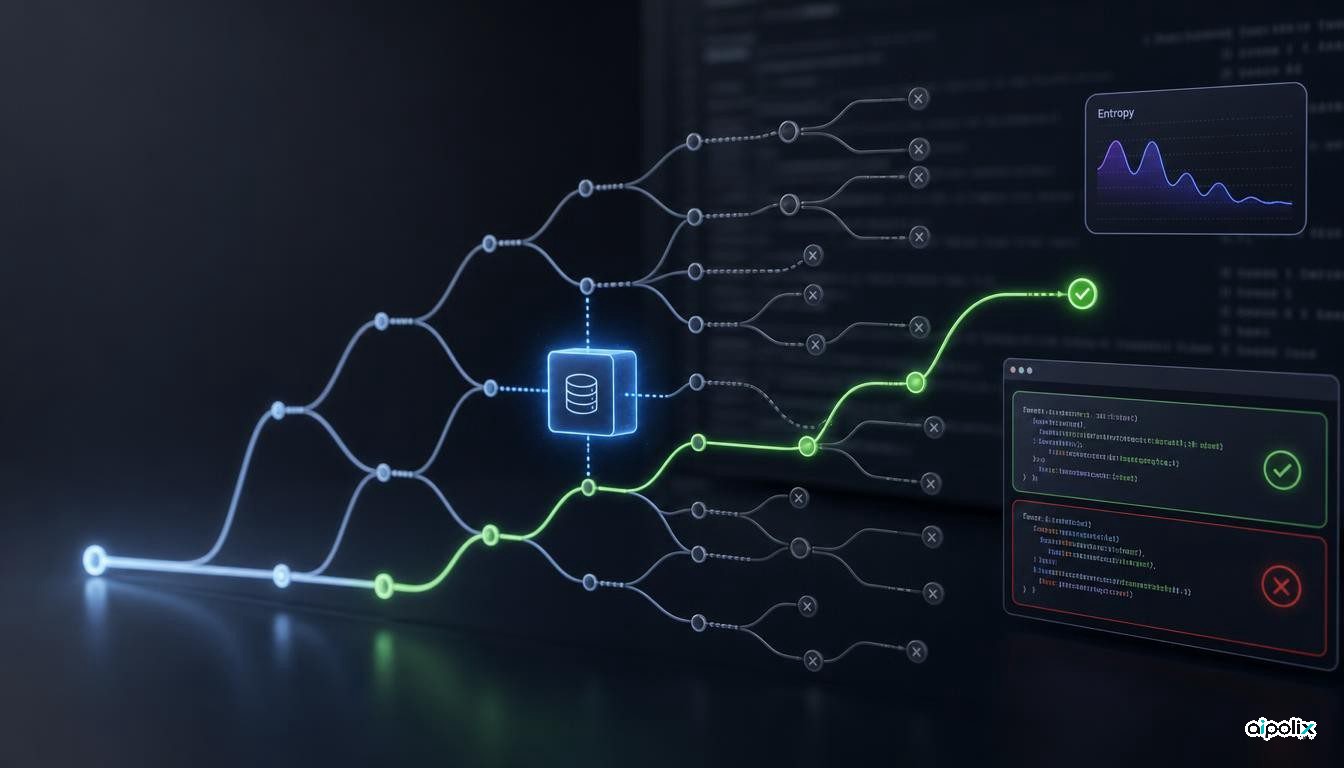
FLEET é um novo método de descodificação em tempo de inferência que tenta corrigir uma fraqueza simples, mas dispendiosa, da amostragem repetida em modelos de linguagem: cada nova resposta normalmente ignora o que as respostas anteriores já tentaram. Os autores argumentam que abordagens do tipo pass@k acabam por gastar parte do orçamento computacional em respostas semanticamente semelhantes ou em ramos que já falharam. A alternativa acrescenta memória ao processo de geração e transforma a amostragem repetida numa pesquisa estruturada nos pontos de decisão de maior incerteza.
No principal resultado do artigo, FLEET aumenta o Pass@32 no LiveCodeBench de 59,9% para 66,2% na configuração testada e, segundo os autores, atinge a precisão da baseline de amostragem repetida com cerca de um terço das amostras, resumindo o resultado como uma aceleração de 3×. O interesse está em melhorar a eficiência em inferência, em vez de depender de um modelo maior ou de mais treino.
O problema não é faltar diversidade em todos os tokens
O temperature sampling introduz aleatoriedade em todos os passos da geração. Isso pode ajudar o modelo a sair de um ramo errado mas muito provável, porém também acrescenta ruído às partes da solução onde o modelo já estava estável.
FLEET procura separar estes dois casos. O método observa a entropia e a varentropia dos estados internos do modelo para identificar pontos que parecem verdadeiras bifurcações. Uma estrutura VectorDSU agrupa estados ocultos semelhantes, permitindo registar quais as ações já exploradas e como foram avaliadas as respetivas trajetórias.
A informação de recompensa obtida no final das trajetórias alimenta depois um processo de pesquisa semelhante a pUCT. Em vez de aumentar a temperatura de forma indiscriminada, FLEET penaliza ações já exploradas que parecem menos úteis e direciona as gerações seguintes para alternativas. Na configuração avaliada, a geração continua greedy e determinística depois de aplicadas essas penalizações.
Isto muda o papel da inferência repetida: deixa de ser uma coleção de tentativas independentes extraídas da mesma distribuição e passa a utilizar evidência acumulada pelas tentativas anteriores.
O resultado em código é relevante, mas estreito
O artigo avalia FLEET em GSM8K e num conjunto filtrado de LiveCodeBench, usando Llama 3.2 3B e 32 trajetórias por problema. Com verificação por ground truth, o Pass@32 no benchmark de código passa de 59,9% para 66,2%, correspondendo a 147 problemas resolvidos em 222, contra 133 na baseline. Em GSM8K, a melhoria é pequena porque a baseline já está perto da saturação.
Os autores também testam um Outcome Reward Model como alternativa mais realista a uma verificação perfeita. Este ponto é importante para sistemas reais, onde raramente existe de imediato uma resposta objetiva sobre a correção de cada geração. Os resultados mostram que a qualidade da pesquisa e a seleção final passam então a depender, em parte, da qualidade do sinal de recompensa.
Esta é uma limitação central: um algoritmo pode explorar candidatos melhores e, ainda assim, escolher uma resposta final errada se o avaliador estiver mal calibrado.
A melhor aplicação é em inferência autoalojada
O repositório oficial disponibiliza o pacote fleet-search e exemplos para Transformers, nnsight e Ray. FLEET, contudo, não é um substituto transparente para uma API alojada convencional.
A implementação exige acesso white-box aos estados ocultos do modelo. Por isso, a aplicação imediata é mais plausível para equipas que servem modelos open-weight ou controlam a sua própria stack de inferência do que para quem recebe apenas texto através de uma API fechada.
Para agentes de programação, o cenário mais favorável é aquele em que já existe um verificador barato e determinístico: testes, compilação, análise estática ou outro critério objetivo. Nesse contexto, uma geração falhada deixa de ser apenas descartada; a sua trajetória pode orientar a tentativa seguinte para longe do mesmo ramo incorreto.
Isto sugere uma forma diferente de pensar o test-time scaling. O recurso relevante não é apenas o número de amostras, mas a capacidade das tentativas posteriores de aproveitar informação produzida pelo orçamento gasto nas tentativas anteriores.
O valor de 3× ainda não deve ser generalizado
FLEET é um preprint no arXiv, não um benchmark de produção revisto por pares. As experiências são limitadas: um único modelo 3B, duas famílias de benchmarks e um subconjunto de 222 tarefas relativamente fáceis do LiveCodeBench. O próprio repositório assinala ainda a necessidade de acesso aos estados ocultos.
Por isso, o valor de 3× deve ser interpretado como um resultado de eficiência de amostragem na configuração testada, e não como uma promessa geral de reduzir em três vezes a latência ou o custo de infraestrutura.
A evidência que mais reforçaria o trabalho seria a replicação em diferentes famílias e escalas de modelos, conjuntos de código mais exigentes, medições wall-clock em stacks reais de serving e testes com verificadores imperfeitos. Se o efeito se mantiver, FLEET poderá indicar uma mudança prática no test-time scaling: em vez de pagar por mais tentativas independentes, construir sistemas de inferência que se lembram dos ramos que já falharam.