
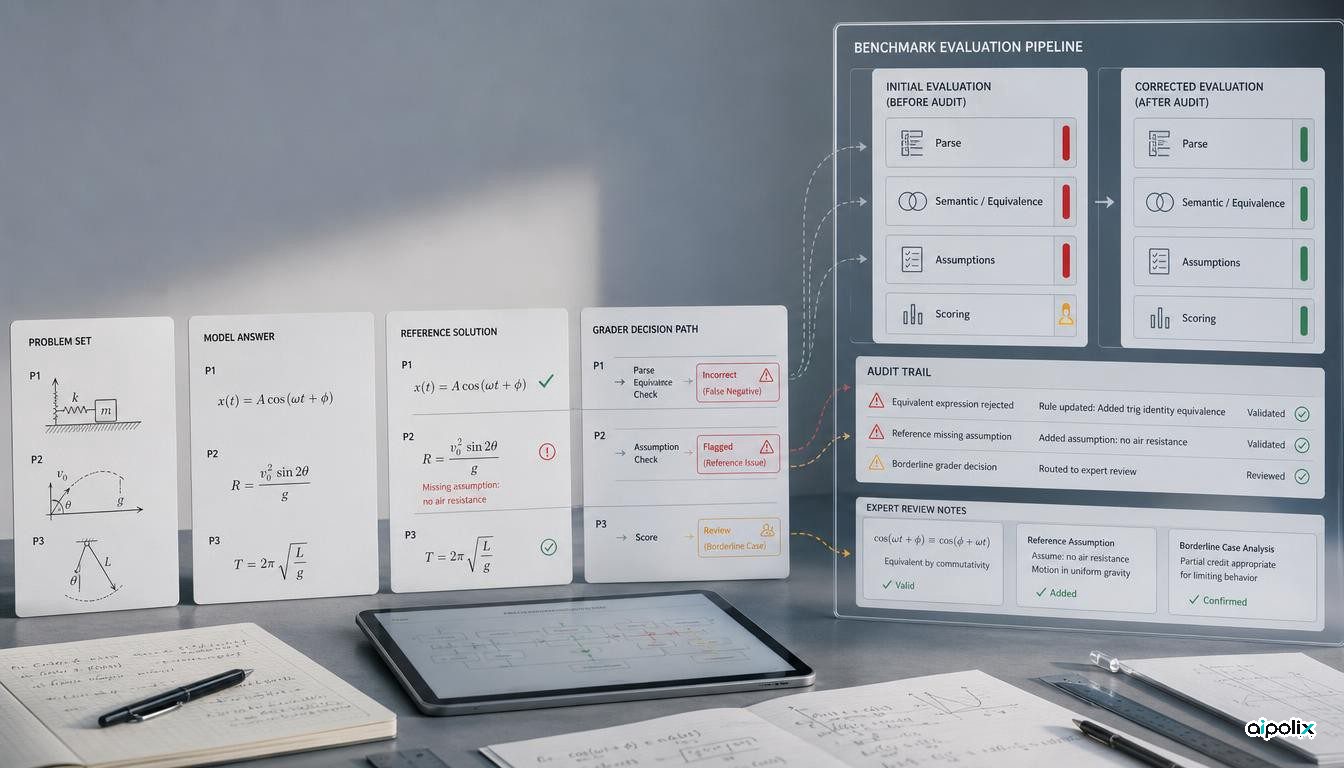
یک ممیزی تازه روی شش معیار ارزیابی فیزیک نشان میدهد بخشی قابل توجه از پاسخهایی که بهعنوان «خطای مدل» ثبت شدهاند، در واقع از خودِ آزمون یا شیوه نمرهدهی ناشی میشوند. پژوهشگران پس از بررسی سؤالها، پاسخهای مرجع و تصمیمهای ارزیاب، امتیاز چند مدل پیشرو را دوباره محاسبه کردند و در بعضی مجموعهها نتیجه بهطور چشمگیری تغییر کرد.
این یافته به معنای «حلشدن فیزیک» توسط مدلهای پیشرو نیست. مطالعه فقط مسئلههای متنی و بستهای را بررسی میکند که پاسخ نهایی قابل راستیآزمایی دارند؛ ضمن اینکه برخی امتیازهای اصلاحشده روی مجموعهای کوچکتر یا ترمیمشده محاسبه شدهاند. اهمیت عملی پژوهش در جای دیگری است: وقتی توان مدل به سقف کیفیت یک آزمون نزدیک میشود، نگهداری و ممیزی خودِ معیار ارزیابی هم بخشی از فرایند سنجش میشود.
ممیزی، تصویری کاملاً متفاوت از امتیازها ساخت
مقاله arXiv:2609.13009 سه مدل GPT-5.6-Sol، Claude Fable 5 و Gemini 3.1 Pro را روی شش مجموعه فیزیک بررسی میکند. گروهی از متخصصان فیزیک، عمدتاً از دانشگاه Yale، مواردی را که ابتدا شکست مدل تلقی شده بودند در سه دسته قرار دادند: خطای واقعی مدل، خطای سامانه نمرهدهی و ایراد در خودِ سؤال یا پاسخ مرجع.
تفاوتها کوچک نبودند. امتیاز mean@4 مدل GPT-5.6-Sol High در HLE-Physics پس از بازبینی از ۴۷٫۲۸٪ به ۷۸٫۶۶٪ رسید. در CMT-Benchmark همین عدد از ۶۱٫۰۰٪ به ۸۷٫۲۴٪ افزایش یافت. Artificial Analysis برای CritPt امتیاز ۳۲٫۳٪ را برای GPT-5.6 Sol Max گزارش میکند، اما مقاله پس از بازبینی تخصصی ۵۴ مسئله باقیمانده، mean@4 برابر ۸۷٫۵۰٪ و pass@4 برابر ۹۴٫۴۴٪ به دست میآورد.
در سه مجموعهای که سؤالهایشان از منابع عمومی فیزیک گرفته شده بود، نتیجه حتی صریحتر است: نویسندگان ۱۴۸ مورد از ۱۵۲ شکست بررسیشده، یعنی ۹۷٫۳۷٪، را به ایراد معیار یا ارزیاب نسبت میدهند، نه به مدل.
با این حال این اعداد را نباید مانند یک مقایسه ساده قبل و بعد خواند. مجموعه سؤالهای نسخه اصلاحشده همیشه دقیقاً با نسخه اولیه یکسان نیست و در CritPt نیز امتیاز اولیه mean@5 روی ۷۰ مسئله با mean@4 روی ۵۴ مسئله باقیمانده مقایسه میشود. بنابراین ارزش اصلی مقاله، ممیزی اعتبار ارزیابی است؛ نه ساختن یک جدول رتبهبندی تازه.
هرچه مدل بهتر میشود، ضعف ارزیاب آشکارتر میشود
پژوهش یک مشکل ساختاری را نشان میدهد. ارزیابهای قاعدهمحور ممکن است پاسخ درست را فقط به این دلیل رد کنند که شکل ریاضی آن با پاسخ مرجع متفاوت است یا از قراردادی معادل استفاده میکند. وقتی مدل ضعیف است، تعداد پاسخهای درست کم است و چنین خطاهایی کمتر دیده میشوند. اما با بالا رفتن توان مدل، سهم خطای ارزیاب در خطاهای باقیمانده بیشتر میشود.
مقاله نمونهای از PHYBench ارائه میکند که در آن یک پاسخ از نظر ریاضی با مرجع معادل است، اما معیار مبتنی بر فاصله ویرایشی به آن نمره صفر میدهد. در موارد دیگر، پاسخ مرجع اشتباه بوده یا صورت سؤال فرضی ضروری را ذکر نکرده است.
Artificial Analysis نیز CritPt و Humanity's Last Exam را در شاخص کلی Intelligence Index خود به کار میبرد و روش نمرهدهی این آزمونها را مستند کرده است. در نتیجه مسئله فقط به پژوهش دانشگاهی محدود نمیشود؛ یک امتیاز ترکیبی میتواند خطاهای اجزای خود را به تصمیم نهایی منتقل کند.
بدهی ارزیابی میتواند تصمیم انتخاب مدل را منحرف کند
نتیجه عملی این پژوهش کنار گذاشتن معیارهای ارزیابی نیست. مسئله این است که شکستهای مهم باید مسیر بررسی دوباره داشته باشند.
اگر یک سازمان بر اساس benchmark درباره خرید مدل، مسیریابی درخواستها، اجازه انتشار یا محدودیت دسترسی تصمیم میگیرد، چند درصد آخر امتیاز دیگر نباید بدون بررسی پذیرفته شود. پاسخنامه ثابت و نمرهدهی خودکار ارزان و تکرارپذیر است، اما نزدیک سقف توان آزمون ممکن است به همان اندازه که مدل را میسنجد، کیفیت ارزیاب را هم اندازهگیری کند.
یک فرایند مطمئنتر دستکم سه پرسش را جدا میکند: آیا سؤال دقیق و بیابهام بود؟ آیا پاسخ مرجع درست بود؟ آیا ارزیاب یک پاسخ معادل و معتبر را تشخیص داد؟ در حوزههای تخصصی میتوان نمونهای از موارد شکست را به کارشناس داد تا سهم هر نوع خطا مشخص شود.
از نگاه حکمرانی، این نکته مهم است. وقتی تصمیم مسیریابی، بودجه یا دسترسی به یک امتیاز ترکیبی وابسته باشد، خطای پنهان ارزیاب عملاً به یکی از ورودیهای سامانه کنترل تبدیل میشود. بهتر است کیفیت هر benchmark نیز سابقه نسخه، عدمقطعیت و گزارش خطا داشته باشد، نه اینکه پاسخ مرجع حقیقتی ثابت و بیخطا فرض شود.
این مطالعه خودمختاری پژوهشی را ثابت نمیکند
دامنه مقاله محدود است. مسئلهها بستهاند و پاسخ نهایی مشخص دارند. پژوهش نشان نمیدهد مدل میتواند پرسش علمی تازهای طرح کند، آزمایش مناسبی انتخاب کند، یک تحقیق باز و طولانی را مدیریت کند یا متوجه شود که چارچوب اولیه مسئله اشتباه بوده است.
روش ممیزی نیز باید با دقت تفسیر شود. در چند مجموعه، متخصصان روی مواردی تمرکز کردهاند که همه تلاشهای GPT-5.6-Sol در ارزیابی اولیه غلط تشخیص داده شده بودند. سپس سؤالهای معیوب حذف یا اصلاح شدهاند. این روش برای پیدا کردن ایراد benchmark مناسب است، اما امتیازهای اصلاحشده را نمیتوان بدون توضیح جایگزین همه نتایج قبلی کرد.
این کار فعلاً یک پیشچاپ arXiv است و وضعیت داوری رسمی آن بهطور مستقل تأیید نشده است. در این اجرای رادار نیز Aipolix به انتشار رسمی جداگانهای برای کد یا دادههای ممیزی نرسید؛ بنابراین امکان بازتولید کامل، علاوه بر توضیحات مفصل مقاله، هنوز محدود است.
حالا خودِ benchmark هم به ممیزی نیاز دارد
پیام اصلی روششناختی است: ارزیابی مدلهای پیشرو وارد مرحلهای شده که زیرساخت آزمون باید بهطور پیوسته کنترل شود.
برای تیمهایی که ارزیابی داخلی دارند، راه عملی این است که اختلافهای نمرهدهی را ثبت کنند، خروجی خام مدل را نگه دارند، بخشی از شکستها را به بازبینی تخصصی بسپارند و پاسخهای مرجع را مانند نرمافزار نسخهبندی کنند. وقتی آزمون به اشباع نزدیک میشود، افزودن سؤالهای دشوارتر و دقیقتر معمولاً ارزش بیشتری از دنبالکردن چند دهم درصد روی یک معیار پرخطا دارد.
در این نگاه، «امتیاز benchmark» فقط ویژگی یک مدل نیست. این عدد خروجی یک سامانه کامل است: سؤال، پاسخ مرجع، تنظیمات نمونهگیری، ابزارهای در دسترس و روش نمرهدهی. این پژوهش نشان میدهد نقص هر کدام از این اجزا میتواند آنقدر بزرگ باشد که برداشت ما از توان واقعی مدل را عوض کند.