
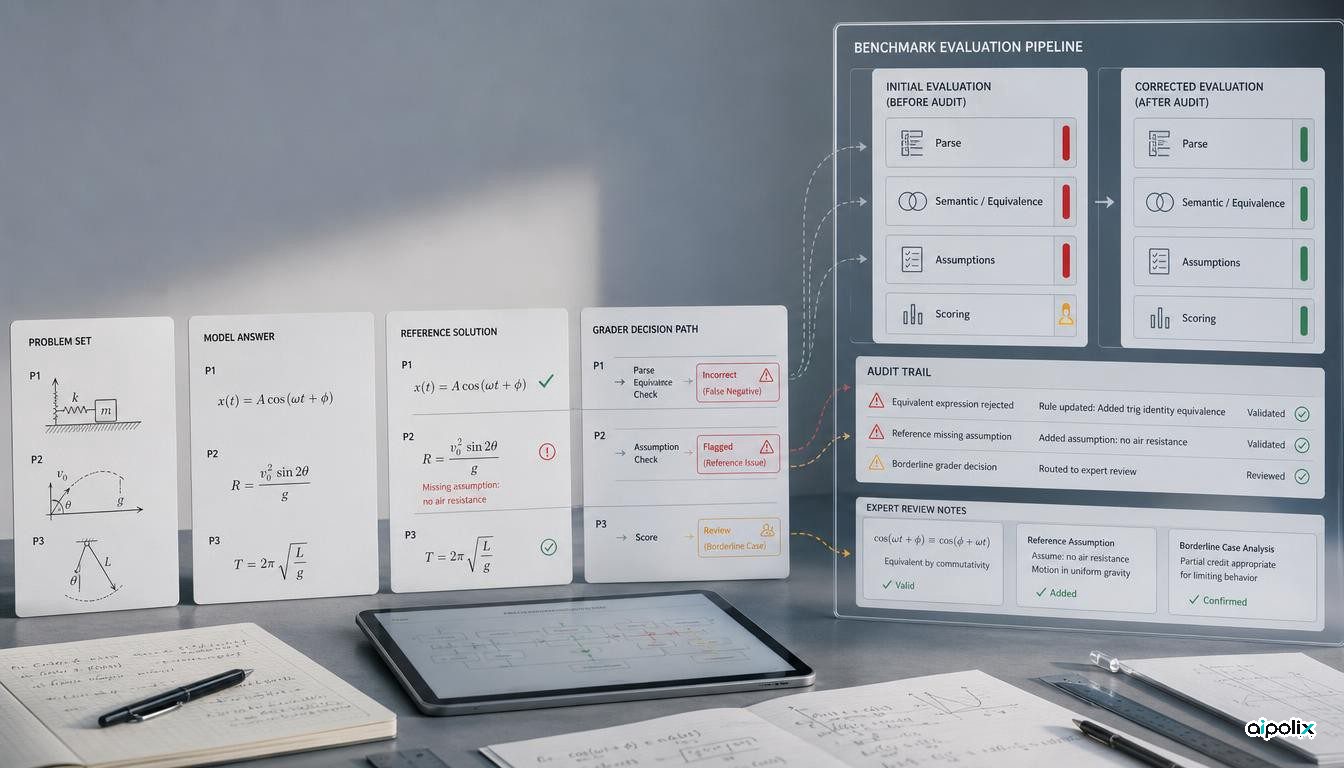
Uma auditoria realizada por especialistas a seis benchmarks de física conclui que uma parte relevante das respostas registadas como «erros do modelo» resulta, afinal, de problemas nas perguntas, nas soluções de referência ou no próprio sistema de avaliação. Depois de físicos reverem esses elementos, os resultados medidos de vários modelos de topo aumentaram substancialmente.
Isto não significa que os modelos de fronteira tenham «resolvido a física». O estudo limita-se a problemas textuais fechados, com uma resposta final verificável, e vários resultados corrigidos são calculados sobre subconjuntos reparados ou reduzidos. A conclusão útil para quem usa benchmarks na seleção e governação de modelos é outra: quando a capacidade do modelo se aproxima do limite de qualidade do teste, manter e auditar o benchmark passa a fazer parte da própria avaliação.
A revisão dos especialistas alterou os resultados
O artigo arXiv:2609.13009 avalia GPT-5.6-Sol, Claude Fable 5 e Gemini 3.1 Pro em seis benchmarks de física. Especialistas, sobretudo ligados à Universidade de Yale, analisaram perguntas, respostas de referência e decisões de avaliação para distinguir três situações: erro genuíno do modelo, erro do avaliador ou defeito do benchmark, como uma solução de referência incorreta, uma hipótese em falta ou uma pergunta ambígua.
As diferenças são grandes. No HLE-Physics, o mean@4 do GPT-5.6-Sol High sobe de 47,28% para 78,66% depois da validação e reparação. No CMT-Benchmark, passa de 61,00% para 87,24%. No CritPt, a Artificial Analysis apresenta 32,3% para o GPT-5.6 Sol Max na avaliação original; o artigo obtém depois 87,50% em mean@4 e 94,44% em pass@4 nos 54 desafios mantidos após revisão.
Nos três conjuntos baseados em problemas provenientes de fontes públicas, o resultado é ainda mais expressivo. Os autores atribuem 148 de 152 falhas aparentes analisadas, ou 97,37%, a problemas do benchmark ou da avaliação, e não ao modelo.
Estes números exigem contexto. Os resultados corrigidos nem sempre usam exatamente as mesmas perguntas. No CritPt, por exemplo, o valor inicial é mean@5 em 70 desafios, enquanto o resultado corrigido é mean@4 nos 54 que foram mantidos. Por isso, o contributo mais sólido do trabalho é a auditoria da fiabilidade do processo de avaliação, e não uma nova tabela classificativa diretamente comparável com a anterior.
Modelos melhores tornam mais visíveis os defeitos da avaliação
O estudo identifica um problema estrutural. Um avaliador baseado em regras pode rejeitar uma resposta correta apenas porque esta usa uma forma matemática equivalente, uma convenção diferente ou uma representação que a regra não reconhece. Quando o modelo acerta pouco, esses falsos negativos são relativamente raros. À medida que os acertos aumentam, os defeitos da avaliação passam a representar uma fração maior do erro que ainda é medido.
O artigo mostra um caso no PHYBench em que uma resposta matematicamente equivalente à referência recebe zero porque uma regra baseada na distância entre expressões não reconhece a equivalência. Noutros casos, os especialistas encontraram soluções de referência erradas ou perguntas sem pressupostos necessários para obter uma resposta única.
A Artificial Analysis inclui atualmente CritPt e Humanity's Last Exam no seu Intelligence Index e documenta como executa essas avaliações. A questão, portanto, não é apenas académica. Um índice composto pode herdar as falhas dos testes que o constituem, mesmo quando a forma de agregação é transparente.
A dívida de avaliação pode afetar decisões sobre modelos
A consequência prática não é abandonar benchmarks. É criar uma via de revisão para falhas que influenciam decisões importantes.
Se uma avaliação serve para escolher fornecedores, encaminhar pedidos entre modelos, bloquear uma versão ou definir níveis de acesso, os últimos pontos percentuais merecem análise forense. Uma chave de respostas fixa e um avaliador automático são económicos e reproduzíveis; perto do limite do teste, podem medir tanto a qualidade do avaliador como a capacidade do modelo.
Um processo mais robusto deve separar pelo menos três perguntas: o problema está bem definido? A resposta de referência está correta? O avaliador reconhece uma resposta válida apresentada de forma equivalente? Em domínios especializados, uma amostra das falhas pode depois ser revista por especialistas para estimar quanto do erro pertence a cada camada.
Há aqui também uma questão de governação. Quando uma organização altera encaminhamento, acesso ou orçamento com base num índice composto, um erro de avaliação não medido torna-se uma entrada escondida no sistema de controlo. A qualidade do benchmark deveria, por isso, ter histórico de versões, correções e incerteza próprios, em vez de a resposta de referência ser tratada como verdade imutável.
O estudo não demonstra autonomia na investigação científica
Os autores restringem a conclusão a problemas fechados de física com respostas finais verificáveis. O estudo não testa se um modelo consegue formular uma questão científica nova, escolher experiências úteis, conduzir uma investigação aberta durante muito tempo ou perceber que o enquadramento inicial está errado.
Existe também um efeito de seleção. Em vários benchmarks, os especialistas concentram-se nos casos em que todas as tentativas do GPT-5.6-Sol tinham sido inicialmente classificadas como incorretas. As avaliações corrigidas removem ou reparam perguntas defeituosas. Isso é adequado para diagnosticar o benchmark, mas significa que os novos números não devem substituir silenciosamente todos os resultados anteriores.
O trabalho é, nesta fase, um preprint no arXiv; a Aipolix não confirmou revisão por pares independente. Nesta execução também não foi identificado um lançamento oficial separado de código ou dados da auditoria, o que limita a reprodução integral para além da metodologia e dos exemplos detalhados no artigo.
O benchmark também precisa de ser avaliado
A conclusão mais importante é metodológica. A avaliação de modelos de fronteira está a entrar numa fase em que a própria infraestrutura de teste precisa de validação contínua.
Para equipas com avaliações internas, isso significa guardar as respostas originais dos modelos, registar divergências de classificação, submeter uma amostra das falhas a revisão especializada e versionar respostas de referência como se versiona software. Quando um teste se aproxima da saturação, acrescentar tarefas mais difíceis e melhor validadas pode ser mais útil do que procurar décimas adicionais num instrumento ruidoso.
Um «resultado de benchmark» não é apenas uma propriedade do modelo. É a saída de um sistema formado por tarefas, referências, parâmetros de amostragem, ferramentas e mecanismo de avaliação. Este estudo mostra que falhas nesses componentes podem ser suficientemente grandes para alterar a conclusão que o número parece sustentar.