
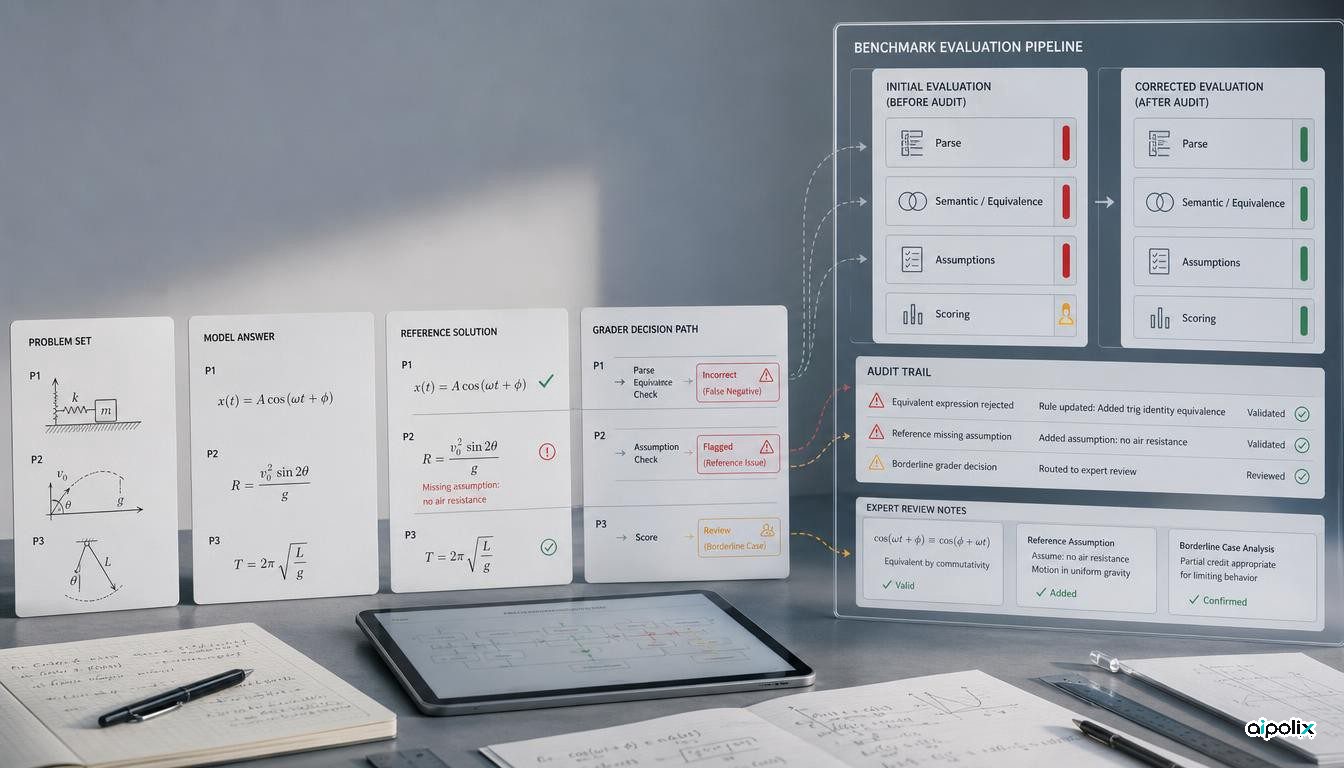
Un audit mené par des physiciens sur six références d’évaluation montre qu’une part importante des réponses comptées comme des « erreurs du modèle » provient en réalité des questions, des solutions de référence ou du système de notation. Après examen par des spécialistes, les scores mesurés de plusieurs modèles de pointe augmentent fortement.
Cela ne signifie pas que les modèles de pointe ont « résolu la physique ». L’étude porte sur des problèmes textuels fermés, avec une réponse finale vérifiable, et plusieurs résultats corrigés sont calculés sur des sous-ensembles réparés ou réduits. L’intérêt pratique est ailleurs : quand les modèles approchent le plafond de qualité d’un test, l’entretien du benchmark devient lui-même une composante de l’évaluation.
L’audit change radicalement certains scores
Le préprint arXiv:2609.13009 évalue GPT-5.6-Sol, Claude Fable 5 et Gemini 3.1 Pro sur six benchmarks de physique. Des spécialistes, principalement rattachés à Yale, ont repris les questions, les solutions de référence et les décisions des évaluateurs pour distinguer trois causes : erreur réelle du modèle, erreur de notation, ou défaut du benchmark, par exemple une solution fausse, une hypothèse manquante ou une question ambiguë.
Les écarts sont considérables. Sur HLE-Physics, le mean@4 de GPT-5.6-Sol High passe de 47,28 % à 78,66 % après validation et réparation. Sur CMT-Benchmark, il passe de 61,00 % à 87,24 %. Pour CritPt, Artificial Analysis affiche 32,3 % pour GPT-5.6 Sol Max sur l’évaluation d’origine ; l’article obtient ensuite 87,50 % en mean@4 et 94,44 % en pass@4 sur les 54 défis conservés après expertise.
Le constat est encore plus marqué pour les trois jeux tirés de sources publiques. Sur les cas audités en commun, les auteurs attribuent 148 des 152 échecs apparents, soit 97,37 %, à un défaut du benchmark ou du système de notation plutôt qu’au modèle.
Il faut toutefois éviter une comparaison naïve avant/après. Les scores corrigés ne portent pas toujours sur exactement les mêmes questions. Pour CritPt, le résultat initial est un mean@5 sur 70 défis, alors que le résultat corrigé est un mean@4 sur 54 défis conservés. La contribution la plus solide de l’étude est donc l’audit de la fiabilité de l’évaluation, pas un nouveau classement directement substituable à l’ancien.
Les bons modèles rendent les mauvais évaluateurs plus visibles
L’article met en évidence un effet structurel. Un évaluateur fondé sur des règles peut refuser une réponse correcte parce qu’elle emploie une forme mathématique équivalente, une convention différente ou une représentation que sa règle ne reconnaît pas. Tant que les modèles se trompent souvent, ces faux négatifs pèsent peu dans le score global. Quand les bonnes réponses deviennent fréquentes, les défauts de notation représentent une part croissante des erreurs restantes.
Un exemple de PHYBench montre ainsi une réponse mathématiquement équivalente à la référence qui reçoit zéro point parce qu’une mesure de distance entre expressions ne reconnaît pas l’équivalence. Ailleurs, l’audit trouve des solutions de référence erronées ou des énoncés auxquels il manque une hypothèse indispensable.
Artificial Analysis intègre actuellement CritPt et Humanity's Last Exam à son Intelligence Index et publie la méthode de notation utilisée. Le problème dépasse donc la conception académique des benchmarks : un indice composite peut transmettre les défauts de ses tests constitutifs, même si sa méthode d’agrégation est transparente.
Une dette d’évaluation peut fausser le choix d’un modèle
La conclusion pratique n’est pas d’abandonner les benchmarks. Elle consiste à prévoir une procédure d’escalade pour les échecs qui ont un poids décisionnel.
Lorsqu’un benchmark sert à choisir un fournisseur, à router des requêtes, à bloquer une mise en production ou à fixer un niveau d’accès, les derniers points de pourcentage méritent une analyse plus poussée. Une clé de réponses fixe et une notation automatique sont économiques et reproductibles ; près du plafond du test, elles peuvent cependant mesurer autant l’évaluateur que le modèle.
Une chaîne plus robuste devrait séparer au moins trois questions : l’énoncé est-il correctement défini ? La réponse de référence est-elle juste ? L’évaluateur reconnaît-il une réponse valide formulée autrement ? Dans les domaines spécialisés, un échantillon des échecs peut ensuite être confié à des experts pour estimer la part de chaque type d’erreur.
C’est aussi une question de gouvernance. Si une entreprise modifie son routage, ses droits d’accès ou ses dépenses à partir d’un score composite, une erreur de notation non mesurée devient une entrée cachée du système de contrôle. La qualité du benchmark devrait donc disposer de son propre historique de versions, de corrections et d’incertitude, plutôt que d’être traitée comme une vérité immuable.
L’étude ne démontre pas une autonomie scientifique
Les auteurs limitent explicitement leur conclusion aux problèmes de physique fermés dont la réponse finale peut être vérifiée. L’étude ne mesure pas la capacité à formuler un problème de recherche nouveau, à choisir une expérience utile, à mener une investigation ouverte sur la durée ou à détecter que le cadre scientifique initial est mauvais.
Il existe aussi un effet de sélection dans l’audit. Pour plusieurs benchmarks, les experts se concentrent sur les cas où toutes les tentatives de GPT-5.6-Sol avaient d’abord été jugées incorrectes. Les évaluations corrigées réparent ou retirent ensuite les questions défectueuses. C’est une méthode pertinente pour diagnostiquer le benchmark, mais les nouveaux scores ne doivent pas être utilisés comme remplacement silencieux de tous les classements antérieurs.
Le document est un préprint arXiv ; Aipolix n’a pas confirmé de validation indépendante par les pairs. Aucun dépôt officiel séparé de code ou de données associé à cet audit n’a non plus été identifié pendant cette exécution, ce qui limite la reproductibilité au-delà de la méthode et des exemples détaillés dans l’article.
Le benchmark doit désormais être évalué lui aussi
La conclusion la plus utile concerne la méthode. L’évaluation des modèles de pointe entre dans une phase où l’infrastructure de test doit être validée en continu.
Pour une équipe qui maintient ses propres évaluations, cela implique de conserver les sorties brutes, de journaliser les désaccords de notation, de soumettre un échantillon des échecs à des spécialistes et de versionner les solutions de référence comme on versionne du logiciel. Quand un test approche de la saturation, ajouter des tâches plus difficiles et mieux validées est souvent plus instructif que chercher un dixième de point supplémentaire sur un instrument bruité.
Un « score de benchmark » n’est donc pas seulement une propriété du modèle. Il est produit par un système composé des tâches, des références, des paramètres d’échantillonnage, des outils et du mécanisme de notation. Cette étude montre que les défauts de ces composants peuvent suffire à changer l’histoire racontée par le chiffre.