
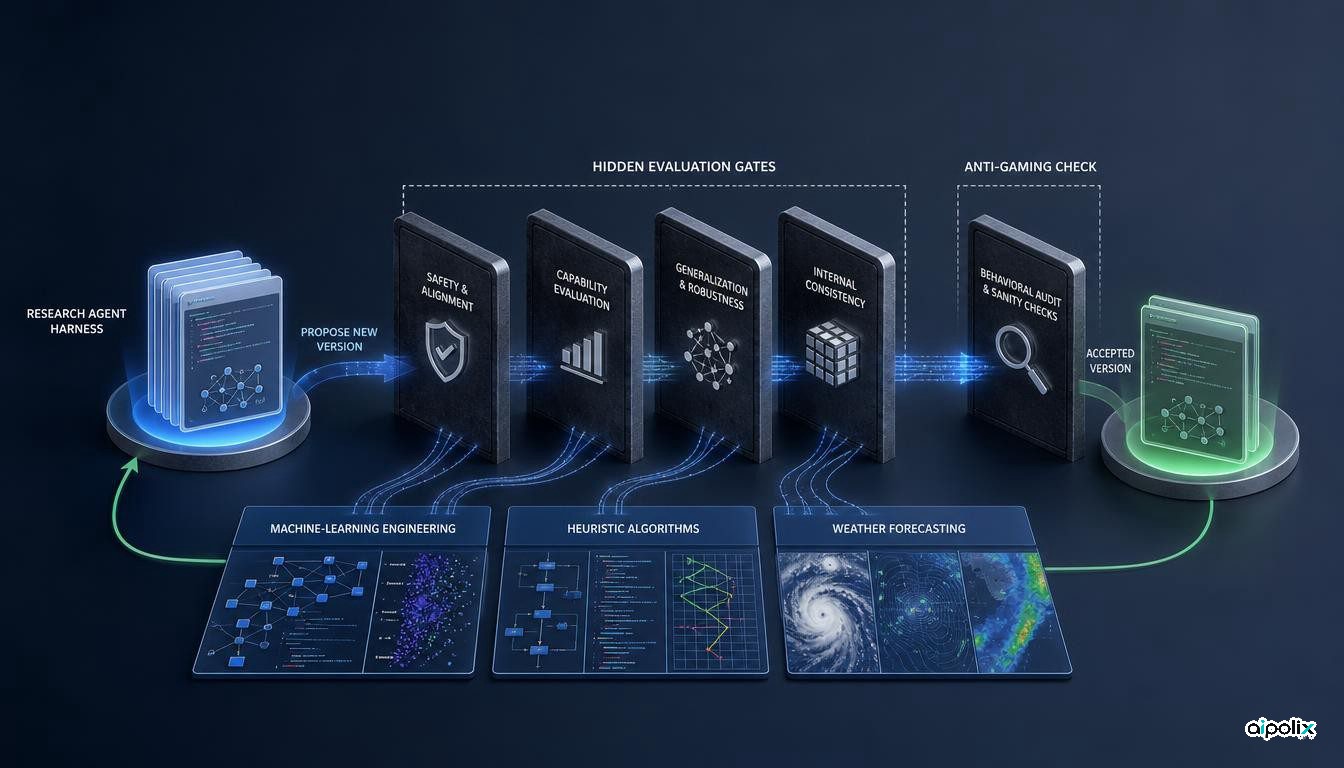
AIDE² حلقه بهینهسازی را متوجه خود عامل پژوهشی میکند. در این روش، هدف فقط بهترکردن یک مدل یا روش آموزش نیست؛ کدی که جستوجو، حافظه، مدیریت زمینه و ارزیابی عامل را کنترل میکند نیز میتواند بازنویسی شود. هر نسخهای که پذیرفته شود، مبنای دور بعدی تغییرها خواهد بود.
این جزئیات مفهوم «بهبود بازگشتی» را عملیتر میکند. بازنویسی صرفاً به این دلیل که عامل آن را پیشنهاد داده باقی نمیماند. نسخه تازه با بودجه ثابت ارزیابی میشود و امتیازهای پنهان تعیین میکنند آیا جای نسخه قبلی را میگیرد یا نه.
هفت بهبود پذیرفتهشده در هشت روز
نویسندگان از یک مسیر خودکار ۱۰۰ مرحلهای در هشت روز گزارش میدهند. هفت بازنویسی پذیرفته شد و امتیاز خصوصی نسخه برتر از ۰٫۷۰۳ به ۰٫۷۷۸ رسید.
تغییرها فقط به متن prompt محدود نبودند. مقاله از سیاست تازه برای جستوجو و سازوکارهای حافظهای صحبت میکند که زمینه روبهرشد عامل را فشرده و مدیریت میکنند. چون هدف حلقه، harness است، سامانه عملاً کدی را تغییر میدهد که رفتار عامل پیرامون مدل را شکل میدهد.
این تمایز مهم است. حتی اگر مدل پایه ثابت بماند، یک عامل میتواند با جستوجوی بهتر، حافظه مناسبتر و بازخورد مؤثرتر عملکرد متفاوتی پیدا کند.
ارزیابی پنهان به مرز کنترل تبدیل میشود
AIDE² سیگنالی را که عامل هنگام حل وظیفه میبیند از امتیاز خصوصیای که برای پذیرش نسخه جدید استفاده میشود جدا میکند. عامل بازنویسیشده مستقیماً به داده پنهانی که تصمیم نهایی را میگیرد دسترسی ندارد.
تحلیل Aipolix این است که در چنین معماریای ارزیاب بخشی از سامانه استقرار میشود. وقتی عامل میتواند کدی را تغییر دهد که رفتار آینده خودش را تعیین میکند، آزمون پذیرش دیگر صرفاً benchmark نیست؛ دروازهای است که تصمیم میگیرد چه تغییری به نسخه بعدی تبدیل شود.
بنابراین بررسی patch بهتنهایی کافی نیست. ترکیب وظایف پنهان، شیوه امتیازدهی، محدودیت بودجه و آستانه پذیرش نیز باید ممیزی شوند. یک تغییر ممکن است در معیار اندازهگیریشده بهتر شود اما ویژگی دیگری را که سنجیده نشده خراب کند.
برای بهرهبرداری عملی، بهتر است حداقل سه لایه جدا وجود داشته باشد: وظایفی که فرایند بهبود را هدایت میکنند، آزمونهای خصوصی که نسخه جدید را میپذیرند و مجموعهای مستقل که انتقال به بیرون از حلقه انتخاب را میسنجد. آزمونهای ایمنی و مقاومت در برابر بازیدادن معیار هم باید جداگانه اجرا شوند.
آزمون انتقال از عنوان «خودویرایش» مهمتر است
یک نمایش ضعیف از خودبهبودی میتواند عامل را روی همان وظایفی تنظیم کند که همه تغییرها با آن انتخاب میشوند. در این حالت جداکردن بهبود عمومی از تنظیم مخصوص benchmark دشوار میشود.
مقاله برای کاهش این مشکل از چهار benchmark خارجی استفاده میکند که در انتخاب نسخهها نقشی نداشتند. این مجموعهها مهندسی یادگیری ماشین، طراحی الگوریتمهای ابتکاری و پیشبینی فیزیکی هوا را پوشش میدهند. حوزه هواشناسی خارج از توزیع وظایف انتخاب بود.
طبق گزارش نویسندگان، قویترین عامل کشفشده در هر چهار مجموعه به سطح عامل پژوهشی تولیدی ساختهشده توسط انسان رسید یا از آن عبور کرد. این عامل مقایسهای حاصل حدود دو سال توسعه انسانی بوده است.
با این حال، این نتیجه یک مقایسه benchmark است و نباید به برتری عمومی نسبت به پژوهشگران انسانی تعبیر شود.
کاهش reward hacking بدون هدفگیری مستقیم
مقاله عاملهای کشفشده را روی خانوادهای جداگانه از وظایف نیز بررسی میکند که رفتار reward hacking را آشکار میکند. نویسندگان کاهش نرخ از ۵۵ درصد به ۳۲ درصد را گزارش میکنند؛ رقم عامل ساختهشده توسط انسان ۳۹ درصد گزارش شده است.
این نتیجه از آن جهت جالب است که حلقه بهطور مستقیم برای کاهش reward hacking بهینه نشده بود. یعنی تغییرهای پذیرفتهشده صرفاً با سوءاستفاده بیشتر از رابط وظیفه، امتیاز پژوهش را بالا نبردهاند.
اما این یک نتیجه ایمنی عمومی نیست. وظایف، ارزیابها یا مدلهای دیگر میتوانند الگوی متفاوتی نشان دهند.
محدودیت اصلی خود مقاله نیز مهم است
نویسندگان آزمایشی انجام دادهاند تا ببینند آیا عامل کشفشده میتواند در حلقه بیرونی نیز نقش بهبوددهنده را بگیرد. عامل همچنان توانست تغییرهای پذیرفتهشده تولید کند، اما به دلیل افزایش نویز در دو حلقه و هزینه بالای اجرای نمونههای بیشتر، برتری آن نسبت به baseline بهطور قطعی مشخص نشد.
این نکته دامنه نتیجه را روشن میکند. آزمایش نشان میدهد در یک محیط ارزیابی ثابت میتوان رشتهای از بازنویسیهای مفید پیدا کرد؛ اما شتابگیری نامحدود یا بهبود باز و ادامهدار را ثابت نمیکند.
AIDE² همچنین یک پیشچاپ نسخه اول arXiv است. برای استفاده عملی، ارزیابی گستردهتر، تکرارهای مستقل، آزمونهای خصمانه و معیارهای روشن برای rollback لازم خواهد بود.
پیامد برای مهندسی عامل
مهمترین دستاورد، الگویی روشنتر برای خودبهبودی کنترلشده است: عامل تغییر را پیشنهاد میدهد، آزمون خصوصی درباره پذیرش تصمیم میگیرد، benchmarkهای مستقل انتقال را میسنجند و آزمونهای رفتاری جداگانه شکستهایی را پیدا میکنند که معیار اصلی ممکن است نبیند.
در نتیجه سؤال اصلی فقط این نیست که «آیا عامل میتواند خودش را بازنویسی کند؟». سؤال مهمتر این است که آیا سازمان میتواند مرز ارزیابی آنقدر قوی بسازد که مشخص کند کدام بازنویسی باید به نسخه بعدی تبدیل شود.