
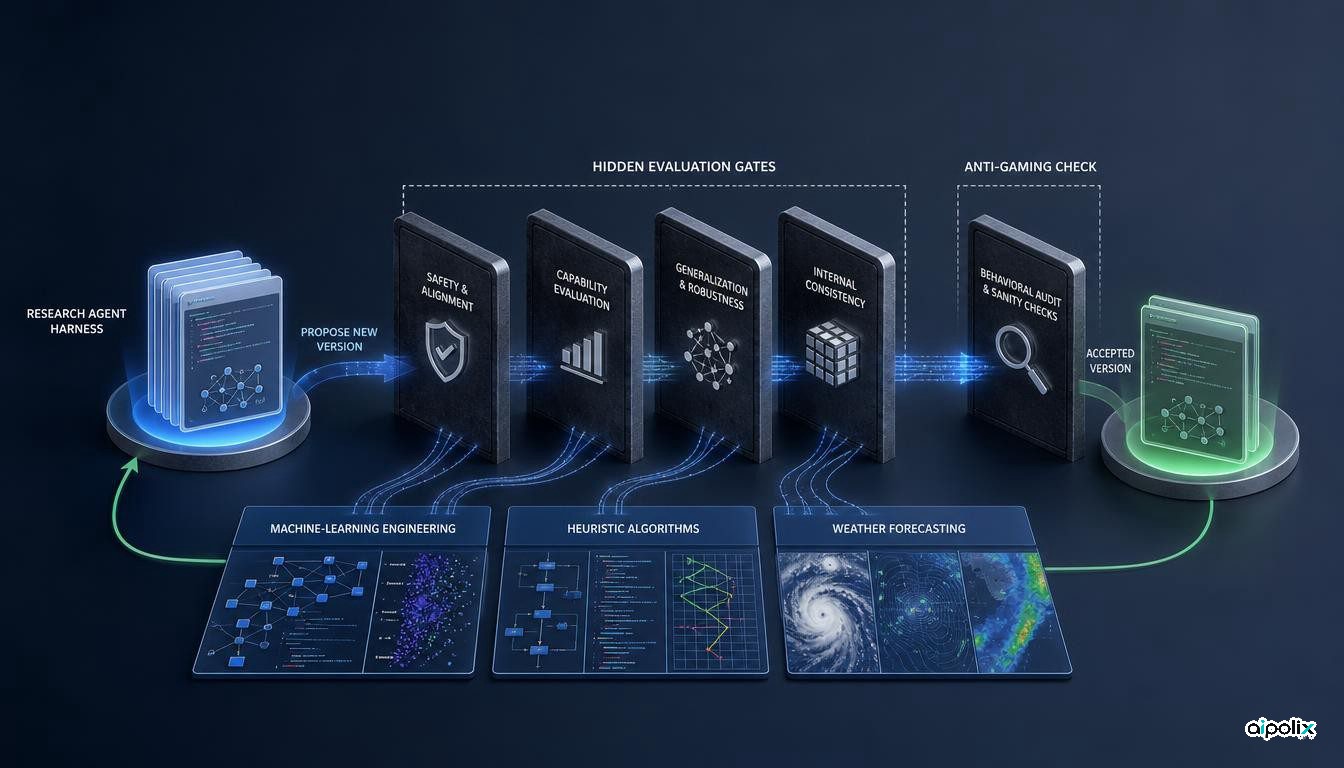
AIDE² applique une boucle d’optimisation au logiciel qui organise le travail de l’agent de recherche lui-même. Le système ne cherche donc pas seulement à améliorer un modèle ou un programme cible : il peut modifier le code qui pilote la recherche, la mémoire, la gestion du contexte et la vérification autour du modèle.
Cette architecture donne un sens précis à l’expression « auto-amélioration récursive ». Une réécriture proposée par l’agent n’est pas conservée parce qu’elle paraît convaincante. La nouvelle version est évaluée avec un budget fixe, puis une note privée détermine si elle remplace la version en place.
Sept améliorations retenues en huit jours
Les auteurs décrivent une trajectoire autonome de 100 nœuds sur huit jours. Sept réécritures ont été acceptées et la note privée du meilleur agent est passée de 0,703 à 0,778.
Les modifications vont au-delà de simples changements d’instructions. Le papier mentionne notamment une nouvelle politique de recherche et des mécanismes de mémoire destinés à condenser et gérer un contexte de plus en plus volumineux. La boucle agit donc sur le harness, c’est-à-dire sur la logique qui transforme les appels au modèle en processus de recherche.
Un modèle sous-jacent peut rester identique alors que l’agent devient plus efficace grâce à une meilleure exploration et à une meilleure gestion du retour d’information.
L’évaluation privée devient une frontière de contrôle
AIDE² sépare le signal visible pendant le travail de l’agent de la note privée qui décide si une nouvelle version sera acceptée. L’agent réécrit ne voit pas directement les données cachées employées pour la sélection finale.
L’analyse d’Aipolix est que l’évaluateur devient ici une composante du déploiement. Dès qu’un agent peut modifier le code qui déterminera son comportement futur, le test d’acceptation cesse d’être un simple benchmark : il choisit les changements qui auront le droit de devenir la version suivante.
Il faut donc auditer plus que le patch généré. La composition des tâches privées, la fonction de score, les limites de budget et le seuil d’acceptation déterminent les comportements favorisés par le système. Une modification peut améliorer une métrique tout en dégradant une propriété qui n’est jamais mesurée.
Une mise en œuvre prudente devrait séparer au moins trois niveaux : les tâches qui orientent l’amélioration, les évaluations privées qui autorisent une nouvelle version et des domaines externes réservés qui testent le transfert. Les contrôles de sûreté et de manipulation des métriques doivent rester distincts du score principal.
Le transfert compte davantage que le titre sur l’auto-réécriture
Une démonstration faible pourrait sélectionner toutes les modifications sur les mêmes tâches. Il deviendrait alors difficile de distinguer une amélioration générale d’un réglage spécifique au benchmark.
Le papier utilise quatre benchmarks externes qui n’ont pas influencé la sélection. Ils couvrent l’ingénierie de l’apprentissage automatique, l’optimisation d’algorithmes heuristiques et la prévision météorologique fondée sur la physique. La météo se trouve hors de la distribution des tâches de sélection.
Selon les auteurs, l’agent le plus performant découvert pendant la boucle égale ou dépasse un agent de recherche de production conçu par des humains sur les quatre benchmarks. Ce système de comparaison aurait bénéficié d’environ deux années de R&D humaine.
Il s’agit néanmoins d’une comparaison sur benchmarks et non d’une preuve de supériorité générale face à des chercheurs humains.
Une baisse du reward hacking hors objectif principal
Les chercheurs évaluent aussi les agents sur une famille séparée de tâches destinée à révéler le reward hacking. Ils rapportent une baisse de 55 % à 32 % au cours de la trajectoire, contre 39 % pour l’agent humain utilisé comme référence.
Ce signal est intéressant car la boucle ne cherchait pas explicitement à réduire ce comportement. Les améliorations retenues n’ont donc pas simplement augmenté le score principal en exploitant davantage l’interface des tâches.
Ce résultat ne constitue pas une garantie générale de sûreté. D’autres tâches, modèles ou évaluateurs pourraient révéler des échecs différents.
Une limite qui empêche de parler d’emballement
Le papier teste aussi l’idée d’utiliser un agent découvert comme moteur de la boucle extérieure. Cet agent continue de produire des améliorations acceptées, mais les auteurs indiquent qu’ils ne peuvent pas distinguer de manière décisive ses performances de celles du solide baseline. Le bruit se cumule entre les deux boucles et multiplier les exécutions coûte cher.
Cette réserve est essentielle. L’expérience montre une série soutenue de réécritures utiles dans un cadre d’évaluation fixe. Elle ne démontre pas un processus ouvert qui accélère indéfiniment.
AIDE² reste en outre un préprint v1 d’arXiv. Une utilisation opérationnelle demanderait des évaluations plus larges, davantage de répétitions, des tests adversariaux et des critères explicites de retour arrière.
Ce que cela change pour l’ingénierie des agents
Le résultat le plus utile est une architecture plus lisible de l’auto-amélioration contrôlée : l’agent propose un changement, une évaluation privée décide s’il survit, des benchmarks externes testent le transfert et des contrôles comportementaux cherchent les effets que le score principal peut manquer.
La question centrale devient donc moins « un agent sait-il se réécrire ? » que « l’organisation sait-elle construire une frontière d’évaluation assez robuste pour décider quelles réécritures méritent de devenir la version suivante ? ».