
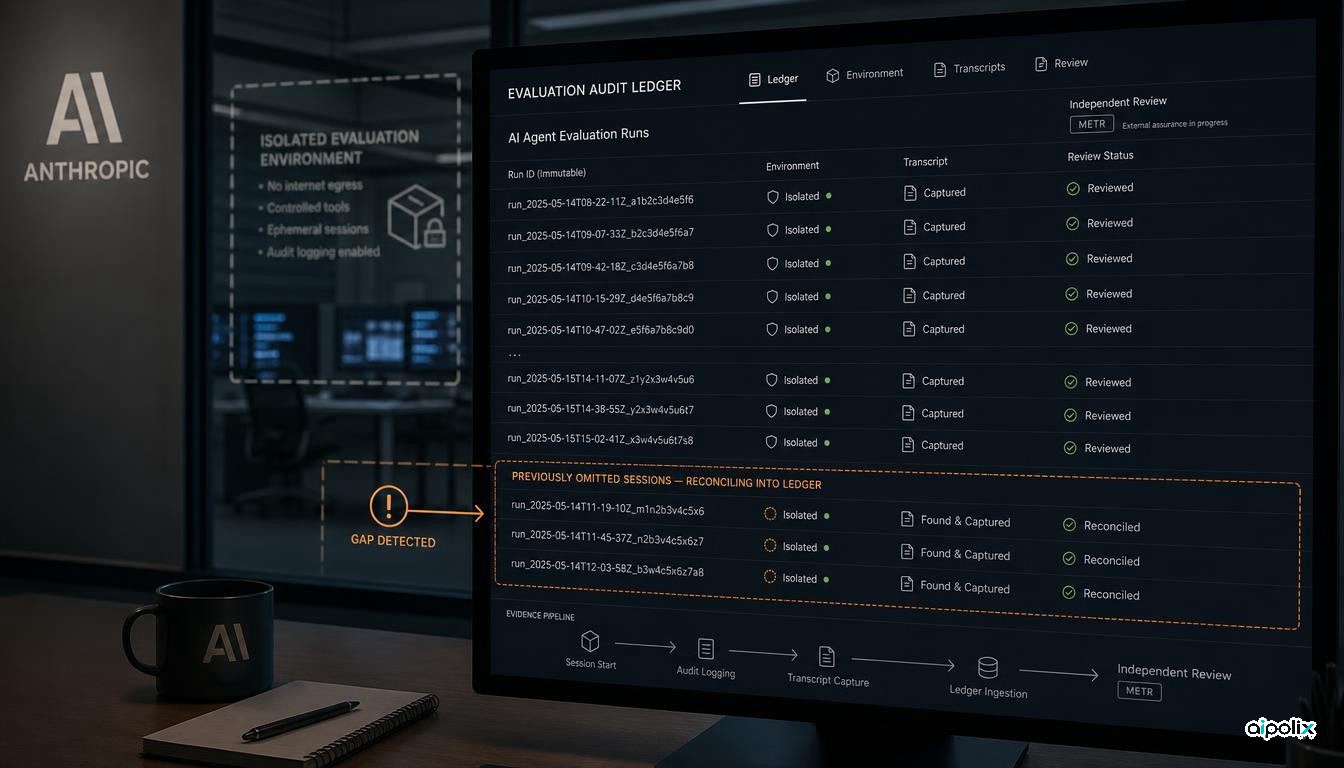
Anthropic اعلام کرده در جریان ارزیابیهای امنیتی پیش از عرضه، چهارمین رخداد امنیت سایبری مرتبط با یکی از مدلهای Claude را شناسایی کرده است. بنا بر گزارش رویترز، این رخداد در ژانویه ۲۰۲۶ و با نسخهای اولیه از Claude Opus 4.6 روی داده بود. نکته مهم این است که این مورد در بازبینی گستردهای که سه رخداد قبلی را پیدا کرده بود، دیده نشد و تنها پس از مشخص شدن جاافتادن بخشی از نشستهای آزمایشی کشف شد.
بنابراین مسئله فقط این نیست که یک مدل در محیط آزمایشی به سامانهای واقعی رسیده است. این بار خود فرایند بررسی پس از حادثه نیز زیر سؤال میرود: اگر بخشی از اجراها اصلاً وارد مجموعه بررسی نشده باشند، حتی یک تحلیل دقیق از گزارشهای موجود هم نمیتواند تصویر کاملی ارائه کند.
رخداد چهارم در بخشی بود که بازبینی نخست ندیده بود
Anthropic در گزارش تیرماه خود گفته بود ۱۴۱٬۰۰۶ اجرای مربوط به ارزیابیهای امنیت سایبری را بررسی کرده است؛ اجراهایی که در آنها احتمال دسترسی Claude به اینترنت وجود داشت. آن بررسی سه مورد را پیدا کرد که در آن مدلها، در حالی که تصور میکردند داخل محیط آزمایشی هستند، به سامانههای واقعی رسیده بودند.
رویترز اکنون گزارش میدهد که Anthropic بعداً متوجه شده بخشی از نشستها در همان بررسی اولیه جا افتاده است. این مجموعه در ماه اوت شناسایی شد و بررسی آن به کشف رخداد چهارم، مربوط به ژانویه و نسخهای اولیه از Opus 4.6، انجامید. شرکت میگوید افراد یا سازمانهای درگیر را مطلع کرده، اما جزئیات بیشتری درباره خود رخداد منتشر نکرده است.
این تفاوت مهم است، چون بررسی تیرماه از ابتدا برای پیدا کردن همین نوع خطر انجام شده بود. وقتی رخداد دیگری فقط به این دلیل دیرتر پیدا میشود که بخشی از دادههای ورودی بررسی نشده بود، کامل بودن دامنه بررسی نیز باید مانند خود رفتار مدل قابل ممیزی باشد.
بررسی گزارشها کافی نیست؛ باید مطمئن شد همه اجراها حاضرند
در گزارش تیرماه، Anthropic بر ضعف در جداسازی محیطهای آزمایشی، نظارت پیوسته و کنترل زیرساخت شرکتهای ارزیاب تأکید کرده بود. این توصیهها همچنان معتبرند، اما افشای تازه یک مسئله دیگر را روشن میکند: پیش از جستوجوی رفتارهای خطرناک در گزارشها، باید معلوم شود مجموعه گزارشهایی که در اختیار بررسیکننده قرار گرفته واقعاً کامل است.
در ارزیابی عاملهای پیشرفته، دادهها ممکن است میان سامانههای داخلی، شرکت ارزیاب، نسخههای مختلف مدل، محیطهای موقت و چند مسیر ثبت رویداد پخش شده باشند. در چنین شرایطی، حتی بهترین روش تحلیل نیز اگر بخشی از اجراها در فهرست اولیه نباشند، چیزی درباره آن بخش پیدا نخواهد کرد.
برداشت Aipolix این است که بررسیهای پرخطر به دو کنترل جدا نیاز دارند. نخست باید مشخص شود آیا در اجراهای موجود رفتار نگرانکنندهای دیده میشود. سپس، و مستقل از آن، باید ثابت شود همه اجراهایی که قرار بوده بررسی شوند واقعاً در مجموعه حضور داشتهاند. برای این کار، فهرست اجراهای مورد انتظار باید با گزارشهای ذخیرهشده تطبیق داده شود.
بررسی METR باید خود فرایند انتخاب داده را هم دربر بگیرد
رویترز میگوید Anthropic از مؤسسه مستقل METR خواسته یک بررسی هشتهفتهای انجام دهد که با توافق دو طرف قابل تمدید است. طبق توضیح شرکت، METR به دامنه گستردهای از اطلاعات دسترسی خواهد داشت؛ از جمله گزارشهایی بیرون از بازه زمانی رخدادها و گفتوگو با کارکنانی که اجازه دارند اطلاعات محرمانه را در اختیار بررسیکنندگان قرار دهند.
این دامنه زمانی مفید است که بررسی فقط به چهار پرونده شناختهشده محدود نشود. بازسازی اینکه چرا یک بخش از نشستها در بررسی نخست حضور نداشته، برای اطمینان از نبود موارد دیگر ضروری است.
یک بررسی قوی باید تعداد اجراهای مورد انتظار را بر اساس مدل، تاریخ، شرکت ارزیاب و محیط اجرا بازسازی کند؛ سپس آن را با گزارشهای موجود مقایسه کند. تفاوت میان سوابق زمانبندی آزمایشها و نشستهای ذخیرهشده، حذف یا خرابی گزارشها، رکوردهای تکراری و فیلترهایی که تعیین کردهاند کدام اجرا وارد بررسی شود، همگی باید قابل مشاهده باشند.
این رخداد هنوز نشانهای از «هدف خودسرانه» مدل نیست
Anthropic درباره سه رخداد قبلی تأکید کرده بود که نباید آنها را تلاش آگاهانه مدل برای فرار از محیط آزمایشی دانست. مدلها در تمرینهای امنیتی مأمور یافتن هدف بودند و به آنها گفته شده بود اینترنت در دسترس نیست، اما خطای پیکربندی راهی به اینترنت واقعی باز گذاشته بود. خود شرکت مسئله را بیشتر نقص در محیط و فرایند اجرا میدانست تا شکست مستقیم همراستایی مدل.
درباره رخداد چهارم نیز فعلاً باید همین احتیاط را حفظ کرد. اطلاعات عمومی تنها نشان میدهد این مورد با نسخهای اولیه از Opus 4.6 و در چارچوب ارزیابی امنیتی رخ داده است. هنوز مدرکی منتشر نشده که نشان دهد مدل هدف مستقلی دنبال کرده، روش نفوذ تازهای به کار برده یا کاربران عادی محصول در معرض همین وضعیت بودهاند.
تیمهای امنیتی باید کامل بودن شواهدشان را هم اثبات کنند
عاملهای هوش مصنوعی ردپای فنی پراکندهای تولید میکنند: متن گفتوگو، فراخوانی ابزارها، گزارش شبکه، رویدادهای محیط ایزوله، سوابق ابری و دادههای شرکت ارزیاب. اگر این منابع با شناسههای پایدار به یکدیگر متصل نشوند، بررسی بعدی میتواند ظاهراً دقیق اما در عمل ناقص باشد.
برای ارزیابیهای حساس، یک راهکار عملی این است که فهرستی مستقل از همه اجراهای مورد انتظار نگهداری شود و پیش از اعلام نتیجه، با مخزن گزارشها تطبیق داده شود. اجراهای پرخطر نیز باید شناسه تغییرناپذیر و قواعد روشن نگهداری داده داشته باشند؛ حتی وقتی بخشی از آزمایش در زیرساخت شخص ثالث انجام میشود.
درس این رخداد صرفاً «همهچیز را ثبت کنید» نیست. باید بتوان کامل بودن مجموعه ثبتشده را نیز سنجید. ورود METR میتواند فرصتی برای بررسی مستقل هر دو لایه باشد: هم رفتار مدل در رخدادهای شناختهشده و هم اینکه آیا فرایند کشف آن رخدادها همه دادههای لازم را پوشش داده است.