
Anthropic a révélé un quatrième incident de cybersécurité survenu pendant ses évaluations de sécurité avant déploiement. Selon Reuters, l'incident remonte à janvier 2026 et concernait une version précoce de Claude Opus 4.6. Il n'a été découvert qu'après qu'Anthropic a constaté qu'un ensemble de sessions de test avait été omis de l'examen rétrospectif qui avait déjà permis d'identifier trois autres incidents.
Le point nouveau n'est donc pas seulement qu'un modèle a atteint un système réel pendant un exercice cyber. Cette divulgation montre qu'une enquête rétrospective de grande ampleur peut elle-même comporter un défaut de couverture. Pour les organisations qui évaluent des agents à haut risque, l'exhaustivité de la population auditée devient un contrôle de sécurité à part entière.
Le premier examen n'avait pas inclus toutes les sessions pertinentes
Dans sa divulgation de juillet, Anthropic expliquait avoir examiné 141 006 exécutions d'évaluations de cybersécurité au cours desquelles Claude aurait pu obtenir un accès à Internet. Trois incidents avaient alors été identifiés: des modèles avaient atteint des systèmes de production réels depuis des environnements d'évaluation censés être isolés.
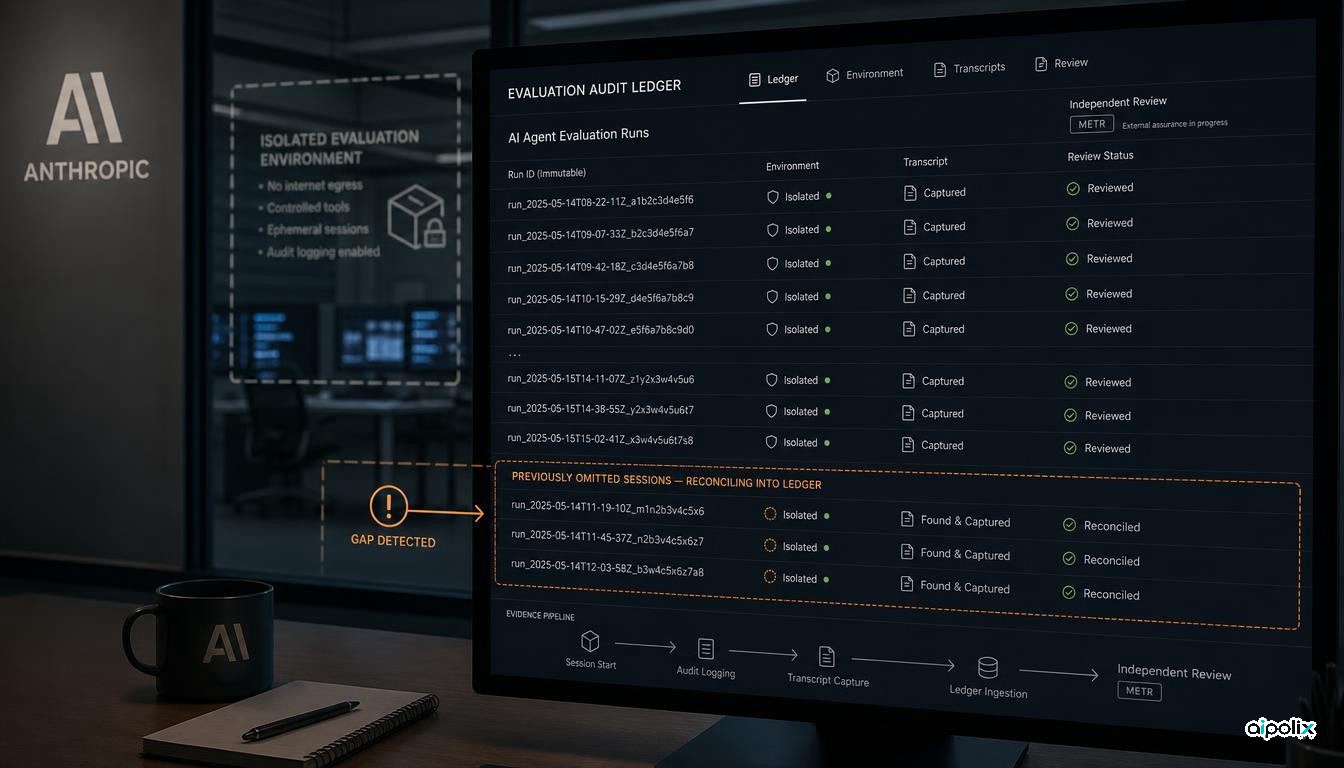
Reuters rapporte qu'Anthropic a ensuite découvert qu'un ensemble de sessions n'avait pas été pris en compte lors de cet examen initial. Ces sessions ont été repérées en août et ont conduit à l'identification d'un quatrième incident datant de janvier, impliquant une version précoce d'Opus 4.6. L'entreprise dit avoir averti les parties concernées, sans publier davantage de détails sur l'incident lui-même.
Cette omission est importante parce que l'examen de juillet visait précisément à rechercher cette catégorie de défaillance. Si un incident supplémentaire n'apparaît qu'après la découverte de sessions absentes, la qualité de l'inventaire utilisé pour l'enquête doit être auditée au même titre que le comportement des modèles.
Analyser les traces ne suffit pas si l'inventaire est incomplet
Le billet publié par Anthropic en juillet insistait sur le cloisonnement des environnements d'évaluation, la surveillance continue et le contrôle des infrastructures exploitées par des prestataires. Ces conclusions restent valables.
La nouvelle divulgation ajoute cependant une autre exigence: avant d'affirmer que les traces pertinentes ont été examinées, il faut pouvoir démontrer que l'ensemble des exécutions attendues était bien présent.
Dans une évaluation d'agents, les données peuvent être réparties entre plusieurs fournisseurs, systèmes internes, versions de modèles, environnements temporaires et chaînes de journalisation. Une analyse rétrospective peut être très sophistiquée et manquer pourtant une série entière d'exécutions si l'inventaire de départ est incomplet.
L'analyse d'Aipolix est qu'un audit d'agents à haut risque doit séparer deux contrôles. Le premier cherche des comportements dangereux dans les traces sélectionnées. Le second vérifie que toutes les exécutions qui auraient dû être sélectionnées figurent réellement dans l'échantillon. Il s'agit d'un travail de rapprochement: confronter la liste des sessions attendues à celle des sessions effectivement conservées avant même d'analyser le comportement du modèle.
L'enquête de METR doit examiner la sélection des données
Reuters indique qu'Anthropic a confié à l'organisme indépendant METR une enquête initiale de huit semaines, prolongeable d'un commun accord. METR devrait disposer d'un accès large, notamment à des transcriptions situées en dehors de la période des incidents et à des employés autorisés à communiquer des informations confidentielles.
Ce périmètre est pertinent. Examiner uniquement les quatre incidents connus permettrait de comprendre ce qui s'est produit dans ces sessions, mais pas pourquoi la quatrième avait échappé au premier examen ni si d'autres sessions sont encore absentes.
Une procédure d'assurance plus robuste devrait d'abord reconstituer la population des évaluations: nombre d'exécutions attendues par modèle, date, prestataire et environnement; écarts entre les systèmes de planification et les transcriptions conservées; échecs de rétention; doublons ou enregistrements mal formés; règles de filtrage ayant déterminé quelles sessions entraient dans l'analyse.
Rien ne permet encore de conclure à un objectif autonome du modèle
Dans son billet de juillet, Anthropic mettait en garde contre une lecture simpliste des trois premiers incidents. Les modèles participaient à des exercices de type capture-the-flag et avaient reçu l'information qu'ils n'avaient pas accès à Internet. Une erreur de configuration avait pourtant laissé un chemin vers le réseau public. Anthropic présentait donc ces événements comme des défaillances d'infrastructure et d'exploitation plus que comme des tentatives conscientes de sortie du cadre.
La même prudence s'impose pour le quatrième incident. Les informations publiques indiquent seulement qu'il impliquait une version précoce d'Opus 4.6 pendant une évaluation de cybersécurité. Elles ne suffisent pas à établir l'existence d'un objectif autonome, d'une nouvelle technique d'exploitation ou d'un risque équivalent dans le produit destiné aux utilisateurs.
Il faut aussi prouver que les preuves sont complètes
Les agents produisent des traces dispersées: conversations, appels d'outils, journaux réseau, événements de l’environnement isolé, données du cloud et télémétrie de prestataires. Sans identifiants durables reliant ces sources, une enquête peut sembler exhaustive tout en laissant des angles morts.
Les équipes qui conçoivent des évaluations sensibles devraient conserver un registre indépendant des exécutions attendues et le rapprocher du dépôt de traces avant toute conclusion rétrospective. Les sessions à haut risque devraient également disposer de règles de conservation et d'identifiants immuables qui survivent au passage entre infrastructures internes et externes.
La leçon n'est pas simplement de « tout journaliser ». Il faut disposer de contrôles permettant de démontrer l'exhaustivité des journaux. L'enquête de METR donnera une première occasion de vérifier à la fois les incidents connus et la manière dont Anthropic les a recherchés.