
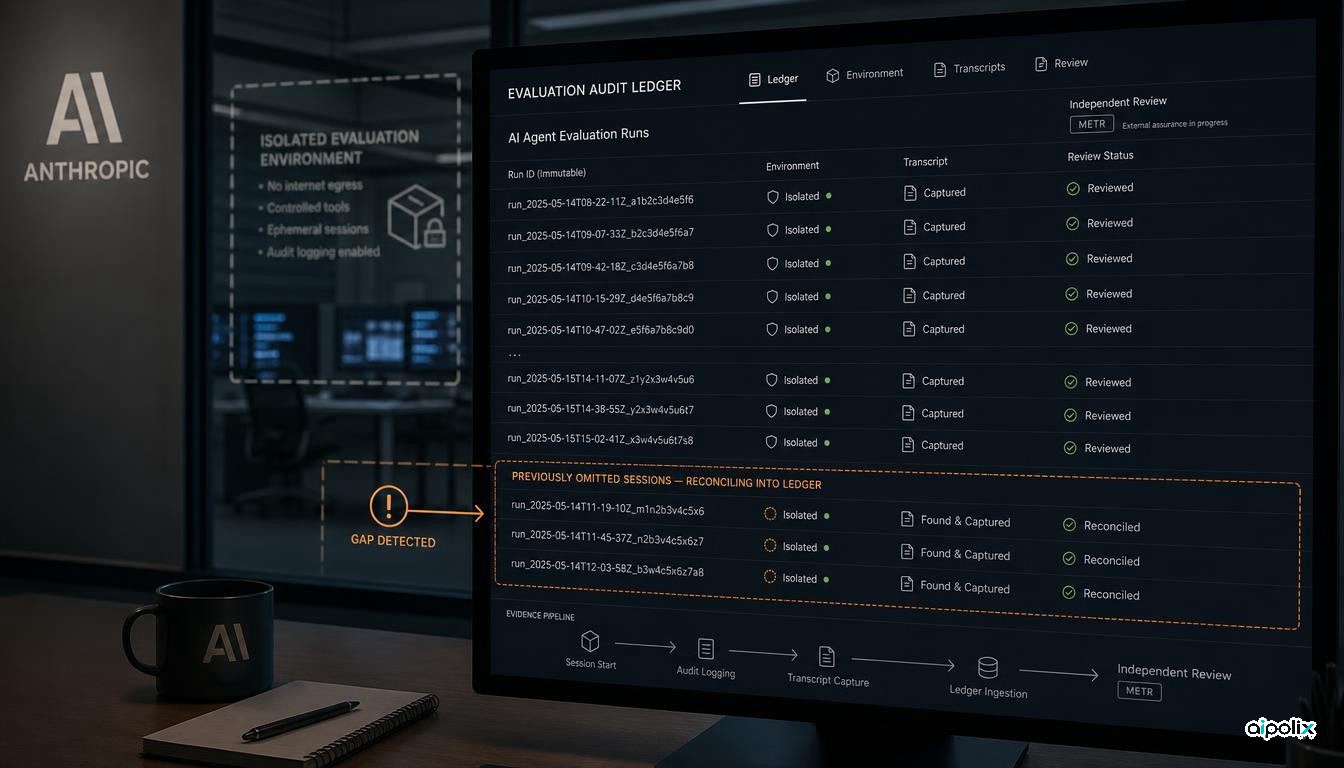
A Anthropic revelou um quarto incidente de cibersegurança ocorrido durante avaliações de segurança anteriores à disponibilização de um modelo. Segundo a Reuters, o caso remonta a janeiro de 2026 e envolveu uma versão inicial do Claude Opus 4.6. O incidente só foi identificado depois de a empresa perceber que um conjunto de sessões de teste tinha ficado de fora da revisão retrospetiva que já encontrara três outros casos.
A novidade operacional está precisamente aí. Não se trata apenas de mais um episódio em que um modelo chegou a um sistema real durante um exercício de cibersegurança. A nova revelação mostra que uma revisão de grande escala pode ter, ela própria, falhas de cobertura. Para quem testa agentes com capacidades sensíveis, provar que o universo auditado está completo passa a ser parte do controlo de segurança.
A primeira revisão não incluiu todas as sessões relevantes
Na divulgação de julho, a Anthropic afirmou ter revisto 141 006 execuções de avaliações de cibersegurança nas quais Claude poderia ter obtido acesso à Internet. Essa análise encontrou três incidentes em que modelos chegaram a sistemas de produção reais a partir de ambientes de teste que deveriam estar isolados.
A Reuters noticia agora que a Anthropic descobriu posteriormente que um conjunto de sessões não tinha sido incluído nessa revisão. As sessões foram identificadas em agosto e conduziram à descoberta de um quarto incidente, ocorrido em janeiro com uma versão inicial do Opus 4.6. A empresa diz ter notificado as partes afetadas, mas não divulgou mais pormenores sobre este caso específico.
A omissão é relevante porque a revisão de julho já tinha sido concebida para procurar precisamente esta categoria de falha. Se um incidente adicional só aparece quando se descobre que havia sessões ausentes, a qualidade do inventário que alimenta a investigação também precisa de ser auditada.
Analisar registos não basta quando o inventário pode estar incompleto
A publicação da Anthropic em julho destacou a necessidade de melhorar o isolamento dos ambientes de avaliação, a monitorização contínua e o controlo das infraestruturas operadas por terceiros. Essas conclusões continuam válidas.
A revelação atual acrescenta outra exigência: antes de afirmar que todos os registos relevantes foram analisados, uma organização precisa de demonstrar que todas as execuções esperadas estavam efetivamente presentes.
Nos testes de agentes, os dados podem ficar distribuídos por fornecedores, sistemas internos, versões de modelos, ambientes temporários e várias cadeias de registo. Uma pesquisa retrospetiva pode ser tecnicamente rigorosa e, ainda assim, não encontrar um conjunto inteiro de sessões se esse conjunto nunca tiver entrado no universo analisado.
A análise da Aipolix é que avaliações de alto risco precisam de dois controlos distintos. Um procura comportamento perigoso nas sessões selecionadas. O outro verifica se todas as sessões que deveriam ter sido selecionadas estavam realmente disponíveis. Antes de analisar o comportamento do modelo, a lista de execuções esperadas deve ser reconciliada com os registos efetivamente conservados.
A revisão da METR deve abranger a forma como os dados foram selecionados
Segundo a Reuters, a Anthropic contratou a organização independente METR para uma investigação inicial de oito semanas, que poderá ser prolongada por acordo entre as partes. A empresa afirma que a METR terá acesso amplo, incluindo transcrições fora do período dos incidentes e contacto com colaboradores autorizados a partilhar informação confidencial.
Esse âmbito é importante. Uma revisão limitada aos quatro casos conhecidos pode explicar o que aconteceu nessas sessões, mas não responde a uma questão central: porque ficou o quarto caso fora da primeira análise e existe a possibilidade de outras sessões continuarem ausentes?
Uma avaliação mais robusta deve primeiro reconstruir o universo dos testes. Isso inclui comparar o número esperado de execuções por modelo, data, parceiro e ambiente com as transcrições disponíveis; procurar diferenças entre sistemas de agendamento e armazenamento; identificar falhas de retenção, duplicados ou registos inválidos; e rever os filtros usados para decidir que sessões entravam na análise.
Não há ainda base para falar num objetivo autónomo do modelo
Na divulgação de julho, a Anthropic pediu cautela na interpretação dos três incidentes anteriores. Os modelos estavam a executar exercícios de captura de objetivos e tinham sido informados de que não dispunham de acesso à Internet, mas uma configuração incorreta deixara um caminho aberto para a rede pública. A empresa descreveu o problema como mais próximo de uma falha do ambiente de avaliação e da operação do que de uma falha direta de alinhamento.
A mesma prudência é necessária agora. A informação pública diz apenas que o quarto incidente envolveu uma versão inicial do Opus 4.6 durante uma avaliação de cibersegurança. Não existem elementos suficientes para concluir que o modelo adotou um objetivo próprio, utilizou uma nova técnica de exploração ou que o mesmo risco existe no produto disponibilizado aos utilizadores.
As equipas de segurança têm de provar que as próprias provas estão completas
Os agentes geram rastos técnicos dispersos: conversas, chamadas a ferramentas, registos de rede, eventos do ambiente isolado, dados da infraestrutura na nuvem e telemetria de fornecedores. Sem identificadores duradouros que liguem essas fontes, uma investigação pode parecer completa e continuar a ter zonas cegas.
Em avaliações sensíveis, uma medida concreta é manter um registo independente de todas as execuções esperadas e reconciliá-lo com o arquivo de transcrições antes de apresentar conclusões. As sessões de maior risco também devem ter regras claras de retenção e identificadores imutáveis que sobrevivam à passagem entre sistemas internos e infraestruturas de terceiros.
A lição não é apenas «guardar todos os registos». É necessário conseguir demonstrar que o conjunto guardado está completo. A entrada da METR cria uma oportunidade para verificar os dois níveis: o que aconteceu nos incidentes conhecidos e se o processo usado para os encontrar cobriu todo o universo relevante.