
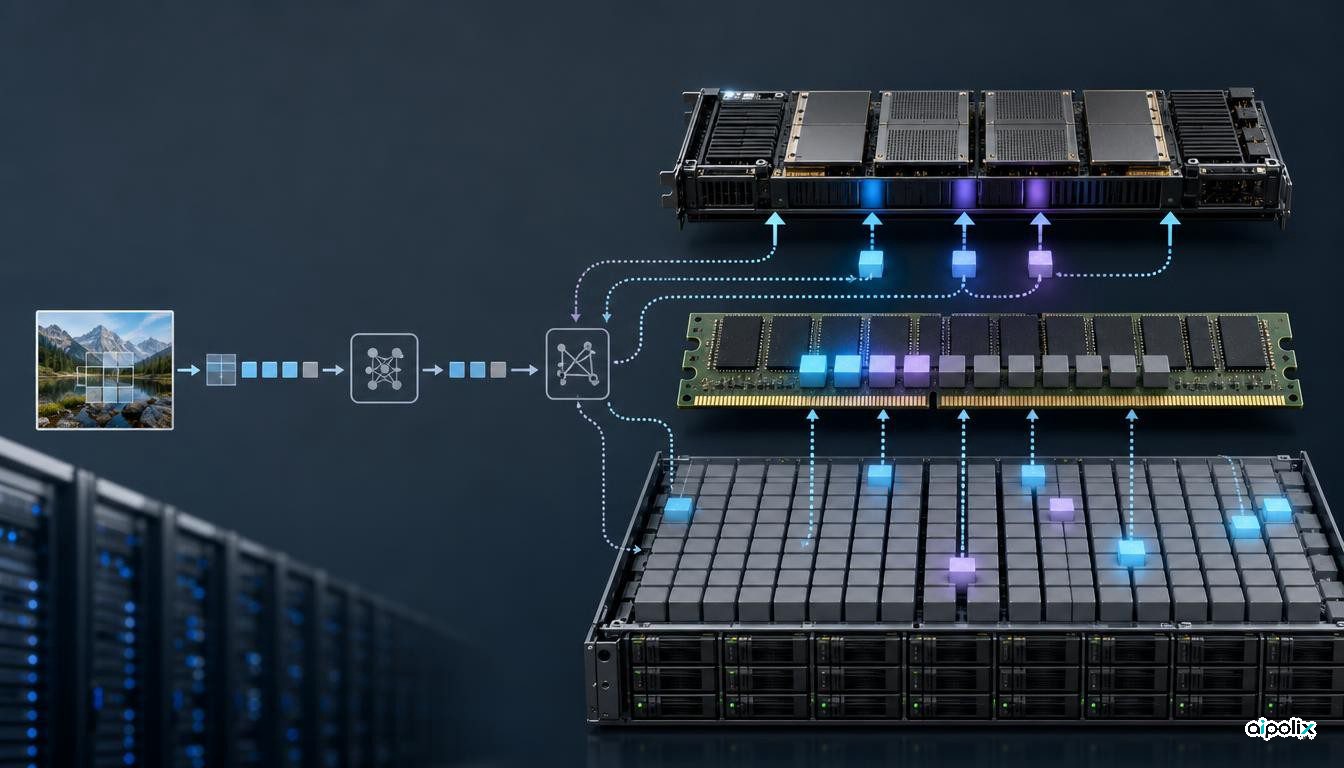
O Colibrì 1.11.0 acrescenta suporte nativo para o DeepSeek V4.1 Flash e permite executar o conjunto de pesos de 510 GB numa máquina assente em CPU e SSD, sem converter primeiro a totalidade dos pesos publicados. O motor de código aberto lê diretamente os pesos densos em fp8 e os especialistas encaminhados em fp4, mantém a maior parte do modelo de 552 mil milhões de parâmetros no armazenamento e carrega apenas os dados necessários a cada token.
O interesse desta versão não está em sugerir que um modelo de 510 GB passou subitamente a caber em memória convencional. A abordagem do Colibrì é outra: armazenamento, RAM e memória de aceleradores formam uma hierarquia, e a estrutura esparsa do modelo permite ir buscar apenas as partes ativas quando são necessárias.
Isto torna o modelo executável em hardware que não conseguiria guardar o conjunto completo de pesos em VRAM. As medições publicadas pelo próprio projeto, porém, mostram claramente a contrapartida: conseguir executar um modelo não é o mesmo que conseguir fazê-lo depressa.
Ler os pesos originais evita uma conversão de centenas de gigabytes
O DeepSeek V4.1 Flash é um modelo Mixture-of-Experts com 552 mil milhões de parâmetros. A nota técnica do Colibrì divide o conjunto de pesos em cerca de 203 GB de tabelas Engram, 289 GB de especialistas encaminhados e aproximadamente 18 GB de pesos densos, representações vetoriais e componentes de visão.
Na versão 1.11.0, os formatos fp8 e fp4 disponibilizados pelo projeto DeepSeek são lidos diretamente. Segundo o Colibrì, a disposição binária dos especialistas é compatível com o caminho mxfp4 já utilizado para o Kimi K3. Isto evita reescrever centenas de gigabytes para um formato específico antes de começar a inferência.
Continua a existir uma pequena etapa de preparação para gerar algumas tabelas que não é eficiente reconstruir no arranque, incluindo mapas de tokens e parâmetros das funções de dispersão usados pelas tabelas Engram. A documentação explica por que razão alguns multiplicadores são guardados como cadeias decimais: arredondá-los num formato de vírgula flutuante poderia encaminhar silenciosamente um n-grama para outra linha válida.
Este pormenor mostra que o problema não é apenas de capacidade. Quando o estado do modelo é lido a partir do disco, a disposição dos ficheiros, as funções de dispersão, a gestão da cache e a reposição do estado também passam a fazer parte da fronteira de correção.
A validação procura preservar o cálculo do modelo
O registo de alterações indica que o motor para DeepSeek V4.1 Flash é comparado token a token com uma implementação de referência separada, feita em PyTorch e executada em CPU, usando várias capacidades de cache e vários modos de descodificação especulativa. O caminho de visão também é sujeito a comparação numérica.
Isto vale mais do que uma demonstração em que o modelo simplesmente produz texto. O Colibrì muda onde os dados residem e quando são lidos; um erro na seleção de especialistas, na propriedade de um índice ou na reposição de estado após rejeitar uma previsão pode continuar a produzir texto plausível e, ainda assim, alterar o resultado do cálculo sequencial.
No mecanismo DSpark são propostos vários tokens, que voltam a passar pelo modelo principal para validação. Quando uma proposta é rejeitada, o estado associado às posições afetadas é restaurado. O projeto também documenta experiências que foram removidas por serem mais lentas, em vez de mostrar apenas as otimizações que tiveram bons resultados.
Estes testes não são uma validação independente da qualidade do DeepSeek nem demonstram que o Colibrì está pronto para qualquer ambiente de produção. Sustentam uma afirmação mais delimitada: a alteração do esquema de memória e das leituras pretende preservar a semântica da descodificação.
Depois da capacidade, o limite passa para as entradas e saídas
O Colibrì estima que cada token do DeepSeek V4.1 Flash possa exigir cerca de 4,5 GB de dados dos especialistas encaminhados. Já as tabelas Engram, apesar de ocuparem 203 GB, são consultadas através de pequenas leituras aleatórias. Esta assimetria ajuda a perceber por que é possível manter a maior parte do conjunto de pesos no disco e, ao mesmo tempo, por que o armazenamento continua a condicionar tanto o desempenho.
No registo de alterações, o projeto relata que uma execução a frio sobre o conjunto de pesos publicado passou, durante o trabalho de otimização, de 78,7 para 25,1 segundos num turno medido, aumentando de 0,305 para 0,957 token por segundo. Uma conversa de cinco turnos é reportada entre 1,14 e 1,58 token por segundo. São medições do próprio projeto, não resultados independentes, e não devem ser extrapoladas para hardware diferente.
Uma experiência separada na nota técnica avalia a descodificação especulativa num servidor CPU com 16 threads que mantinha 68% dos especialistas num nível mais rápido. Numa carga a frio de 24 tokens, o débito aumentou de 0,206 para 0,242 token por segundo. Os autores sublinham ainda que uma cache de páginas do sistema operativo já aquecida pode ter um efeito superior ao da própria otimização.
A conclusão útil não é que a inferência local tenha atingido latências comparáveis às de serviços na nuvem. Depois de contornar o problema de capacidade através de leitura progressiva a partir do armazenamento, o orçamento crítico passa a ser o de I/O: largura de banda do SSD, latência das leituras aleatórias, estado da cache e percentagem de especialistas que pode permanecer em memória mais rápida.
“Inferência local” deixa de ser apenas uma questão de VRAM
A discussão sobre inferência local costuma começar por saber se o modelo cabe na memória da GPU. Para modelos esparsos de grande dimensão, a arquitetura do Colibrì mostra que essa definição é demasiado estreita.
Os componentes densos podem ficar residentes, os especialistas mais usados podem ser mantidos em cache e o SSD pode funcionar como camada fria. Para experiências, processamento offline ou situações em que o controlo local pesa mais do que uma resposta imediata, isto alarga de forma realista o conjunto de hardware utilizável.
Em contrapartida, muda o perfil operacional. O desempenho depende da distribuição dos especialistas solicitados e do estado da cache. A integridade dos dados no armazenamento precisa de ser verificada. Comparações reprodutíveis exigem que o estado da cache seja controlado. E uma configuração que consegue servir o modelo pode continuar a ser lenta demais para um agente interativo.
A análise da Aipolix é que o Colibrì 1.11.0 desloca a fronteira de «os pesos cabem?» para «a hierarquia de memória consegue alimentar os pesos ativos com rapidez suficiente?». Para grandes modelos MoE, esta é uma pergunta de engenharia mais útil.
O que os programadores devem medir
Esta versão é relevante como trabalho de engenharia de inferência, não como uma segunda notícia sobre o lançamento do DeepSeek V4.1 Flash. A Aipolix já cobriu o modelo; o acontecimento novo é a existência de um caminho de execução aberto para o conjunto de pesos publicado.
Ao avaliar um motor deste tipo, o número de estrelas no GitHub e o simples facto de o modelo arrancar são indicadores fracos. Interessa verificar a equivalência token a token com uma referência, o débito a frio e a quente, a largura de banda do armazenamento, o comportamento da cache, a distribuição entre RAM e VRAM e a latência efetiva para a carga de trabalho em causa.
O Colibrì publica detalhe suficiente para que muitas destas perguntas possam ser testadas e não esconde as limitações. Alguns caminhos de comando ainda não estão ligados para esta família, as métricas por turno são opcionais e os números de desempenho dependem fortemente do hardware e do estado da cache.
Essa transparência é a principal razão para prestar atenção à versão. O Colibrì não elimina o custo de um modelo de 510 GB; transforma-o num problema explícito de armazenamento, memória e escalonamento que pode ser medido e afinado.