
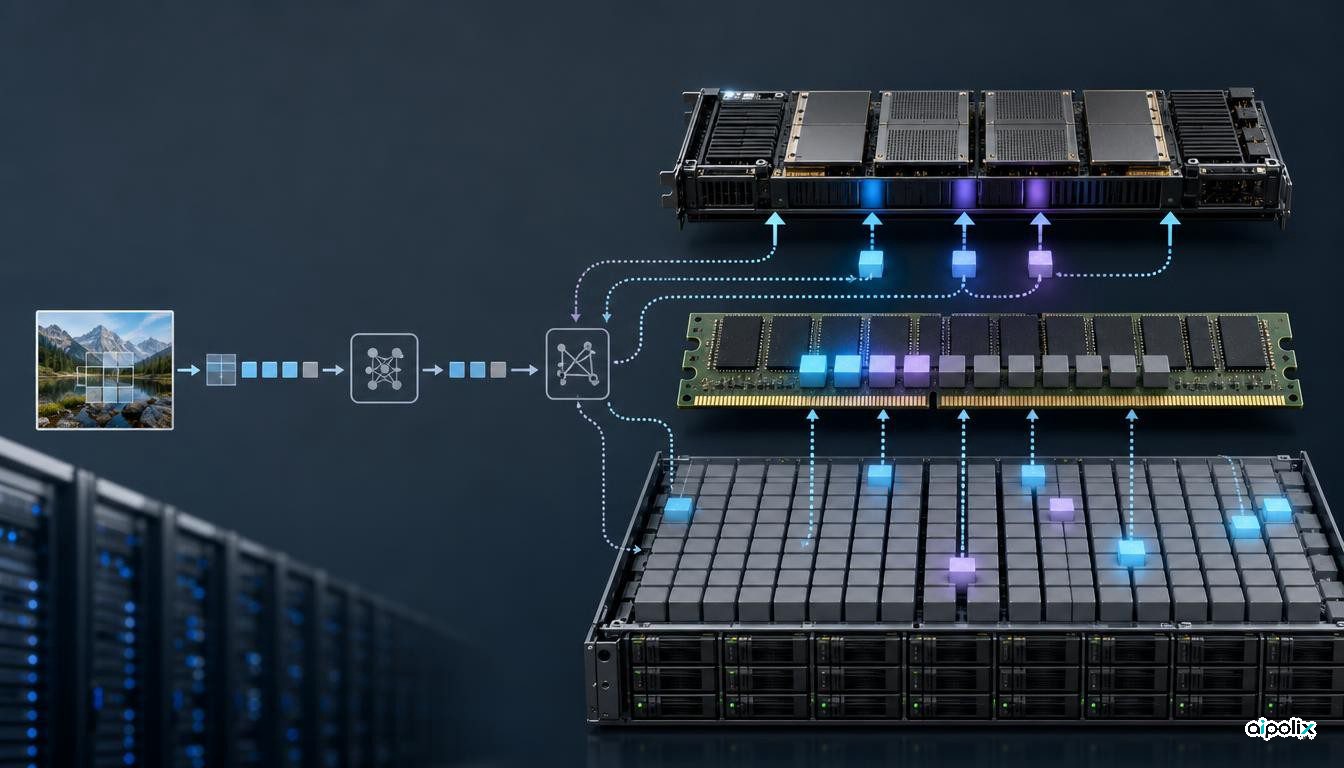
Colibrì 1.11.0 ajoute la prise en charge native de DeepSeek V4.1 Flash et permet d'exécuter son jeu de poids de 510 Go sur une machine reposant sur un CPU et un SSD, sans convertir au préalable l'ensemble des poids publiés. Le moteur libre lit directement les poids denses en fp8 et les experts routés en fp4, conserve l'essentiel du modèle de 552 milliards de paramètres sur le stockage et ne fait remonter que les données nécessaires à chaque jeton.
L'intérêt de cette version n'est donc pas de prétendre qu'un modèle de 510 Go tient soudainement dans une mémoire ordinaire. Colibrì traite le stockage, la RAM et la mémoire des accélérateurs comme les étages d'une même hiérarchie, puis exploite la parcimonie du modèle pour charger à la demande les parties actives.
Cette approche rend le modèle exécutable sur une machine incapable de contenir le jeu de poids complet en VRAM. Les propres mesures du projet montrent toutefois la contrepartie : rendre un modèle exécutable ne signifie pas le rendre rapide.
Lire les poids d'origine évite une conversion massive
DeepSeek V4.1 Flash est un modèle Mixture-of-Experts de 552 milliards de paramètres. La note technique de Colibrì répartit le jeu de poids publié entre environ 203 Go de tables Engram, 289 Go d'experts routés et près de 18 Go de poids denses, de représentations vectorielles et de vision.
La version 1.11.0 lit directement les formats fp8 et fp4 fournis par DeepSeek. Le projet indique que l'organisation binaire des experts est compatible avec le chemin mxfp4 déjà utilisé pour Kimi K3. Il n'est donc pas nécessaire de réécrire plusieurs centaines de gigaoctets dans un format propre à Colibrì avant de lancer l'inférence.
Une petite étape de préparation reste nécessaire pour produire quelques tables que le moteur ne peut pas reconstruire efficacement au chargement, notamment des correspondances de jetons et des paramètres de hachage pour Engram. La documentation explique même pourquoi certains multiplicateurs sont enregistrés sous forme de chaînes décimales : un arrondi en virgule flottante pourrait envoyer silencieusement un n-gramme vers une autre ligne parfaitement valide.
Ce niveau de détail montre que le sujet dépasse la simple capacité mémoire. Dès que l'état du modèle est lu depuis le disque, l'organisation des fichiers, les fonctions de hachage, la propriété du cache et la restauration de l'état font partie des conditions de correction.
La version vérifie la sémantique, pas seulement le démarrage
Le journal des modifications indique que le moteur DeepSeek V4.1 Flash est comparé jeton par jeton à une implémentation de référence séparée, en PyTorch sur CPU, avec plusieurs tailles de cache et plusieurs modes de décodage spéculatif. La partie vision fait également l'objet d'une comparaison numérique.
C'est un signal plus solide qu'une simple démonstration où le modèle produit du texte. Colibrì modifie l'endroit où résident les données et le moment où elles sont lues. Une erreur de routage, de gestion d'indice ou de restauration après un brouillon rejeté pourrait donc produire une réponse plausible tout en s'écartant du calcul séquentiel attendu.
Le mécanisme DSpark propose plusieurs jetons, les repasse dans le modèle principal pour validation puis restaure l'état associé aux positions rejetées. Le projet documente aussi des optimisations testées puis supprimées parce qu'elles étaient plus lentes, ce qui permet de comprendre les échecs de mesure au lieu de ne montrer que les gains.
Ces tests ne constituent pas une validation indépendante de la qualité de DeepSeek ni une certification de production pour Colibrì. Ils étayent une affirmation plus précise : le changement d'organisation mémoire et d'ordonnancement des lectures doit préserver le comportement de décodage du modèle.
Après la capacité, le budget devient celui des entrées-sorties
Colibrì estime qu'un jeton de DeepSeek V4.1 Flash peut nécessiter environ 4,5 Go de données provenant des experts routés. À l'inverse, les tables Engram, bien qu'elles représentent 203 Go du jeu de poids, sont consultées par de petites lectures aléatoires. Cette différence explique à la fois pourquoi le modèle peut rester majoritairement sur disque et pourquoi le chemin de stockage reste déterminant pour les performances.
Le journal des modifications rapporte qu'au cours du développement, sur le jeu de poids publié avec caches vidés, un tour mesuré est passé de 78,7 à 25,1 secondes, soit de 0,305 à 0,957 jeton par seconde. Une conversation de cinq tours est annoncée entre 1,14 et 1,58 jeton par seconde. Il s'agit de mesures du projet et non d'une évaluation comparative indépendante ; elles ne doivent pas être extrapolées à un matériel non spécifié.
Une expérience distincte, décrite dans la note technique, mesure le décodage spéculatif sur un serveur CPU à 16 threads conservant 68 % des experts dans un niveau plus rapide. Sur une charge froide de 24 jetons, le débit passe de 0,206 à 0,242 jeton par seconde. Les auteurs soulignent surtout qu'un cache de pages déjà chaud peut avoir davantage d'effet que l'optimisation logicielle elle-même.
La conclusion utile n'est donc pas que l'inférence locale atteint la latence du cloud. Une fois le problème de capacité contourné par le chargement à la demande, la contrainte se déplace vers les entrées-sorties : bande passante du SSD, latence des petites lectures, état du cache et proportion d'experts maintenus dans une mémoire plus rapide.
L'inférence locale ne se résume plus à la VRAM
On réduit souvent l'inférence locale à une question : le modèle tient-il dans la mémoire du GPU ? Pour les grands modèles clairsemés, l'approche de Colibrì rend cette définition trop étroite.
Les composants denses peuvent rester en mémoire, les experts les plus sollicités peuvent être mis en cache et le SSD peut jouer le rôle d'étage froid. Pour l'expérimentation, les traitements hors ligne ou les usages où le contrôle local compte davantage que la réponse instantanée, cela élargit réellement le choix de matériel.
En contrepartie, le profil d'exploitation change. Les performances dépendent de la distribution des experts sollicités et de l'état du cache. L'intégrité des données stockées doit être vérifiée. Une évaluation reproductible doit contrôler les caches. Et un système capable de servir le modèle peut rester trop lent pour un agent interactif.
L'analyse d'Aipolix est que Colibrì 1.11.0 déplace la vraie frontière de « les poids peuvent-ils tenir ? » vers « la hiérarchie mémoire peut-elle alimenter assez vite les poids actifs ? ». Pour les modèles MoE de très grande taille, c'est une question d'architecture plus pertinente.
Ce que les développeurs devraient mesurer
Cette version est intéressante comme résultat d'ingénierie d'inférence, pas comme une nouvelle annonce de DeepSeek V4.1 Flash. Aipolix a déjà couvert le modèle lui-même ; l'événement nouveau est l'arrivée d'un chemin d'exécution libre pour le jeu de poids publié.
Pour évaluer ce type de moteur, le nombre d'étoiles GitHub ou le simple fait que le modèle démarre ne suffisent pas. Il faut examiner la conformité jeton par jeton avec une référence, les débits à froid et à chaud, la bande passante du stockage, le comportement du cache, la répartition entre RAM et VRAM et la latence obtenue pour la charge réelle.
Colibrì publie assez de détails pour rendre ces questions vérifiables et expose également ses limites. Certains chemins de commande ne sont pas encore câblés pour cette famille, les statistiques par tour sont optionnelles et les performances varient fortement avec le matériel et l'état du cache.
C'est précisément cette transparence qui donne de l'intérêt à la version. Colibrì ne supprime pas le coût d'un modèle de 510 Go ; il transforme ce coût en un problème explicite de stockage, de mémoire et d'ordonnancement que les ingénieurs peuvent mesurer.