
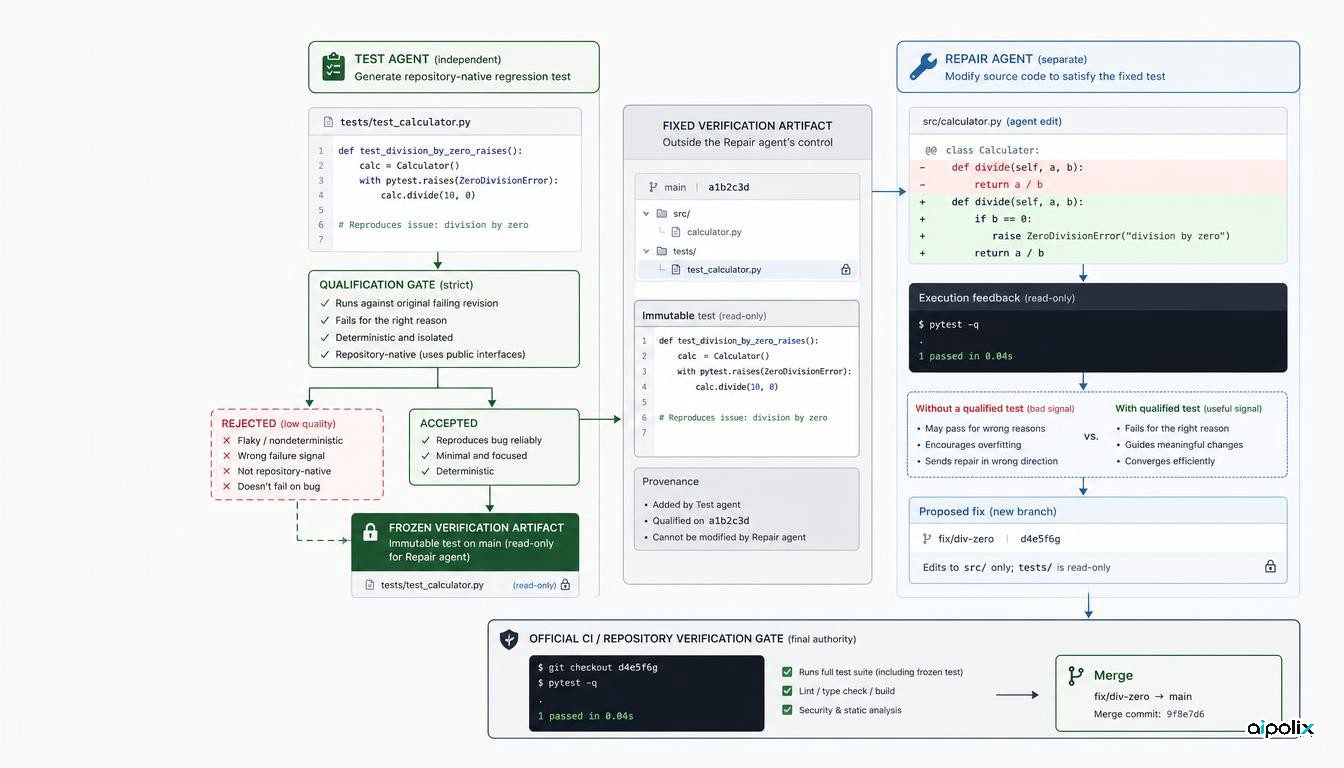
پژوهش ExecCritic یک نتیجه مهم برای عاملهای برنامهنویسی دارد: اضافه کردن آزمون خودکار همیشه کیفیت اصلاح کد را بهتر نمیکند. نویسندگان روی SWE-bench Verified گزارش میکنند که وقتی عامل Repair ثابت نگه داشته میشود، بدون آزمون تولیدشده ۶۱٫۲ درصد از مسئلهها حل میشوند؛ اما آزمونهای عامل Test پایه این عدد را به ۵۷٫۳ درصد کاهش میدهند. در مقابل، آزمونهای تولیدشده با GPT-5.6 Sol نتیجه را به ۶۵٫۳ درصد میرسانند.
این تفاوت نشان میدهد اجرای آزمون بهخودیخود منبع قابل اعتمادی برای بازخورد نیست. اگر آزمون برداشت اشتباهی از خواسته مسئله داشته باشد، عامل میتواند کد را طوری تغییر دهد که همان آزمون غلط سبز شود و در عین حال از رفتار واقعی مورد انتظار دورتر شود.
عامل آزمون و عامل اصلاح از هم جدا شدهاند
ExecCritic دو نقش مستقل تعریف میکند. عامل Test آزمونهایی متناسب با ساختار مخزن میسازد تا رفتار مورد انتظار از مسئله را بررسی کند. سپس یک سازوکار سختگیرانه آزمون را ارزیابی میکند و در صورت پذیرش، آن را ثابت نگه میدارد. عامل جداگانه Repair فقط اجازه دارد کد منبع را تغییر دهد و نمیتواند آزمون پذیرفتهشده را دستکاری کند.
در پژوهش، هر دو نقش بر پایه Qwen-3.5-35B-A3B ساخته شدهاند و جداگانه آموزش میبینند. نویسندگان دو مرحله آموزشی را Learn to Test و Test to Improve نامیدهاند. مخزن عمومی پروژه نیز مسیر ساخت آزمون، چرخه اصلاح و ابزار بررسی رسمی SWE-bench را در دسترس قرار داده است.
این جداسازی یک راه ساده برای خودتأییدی را میبندد. عامل نمیتواند بعد از شکست یک اصلاح، آزمون را نرمتر کند تا نتیجه ظاهراً درست شود.
آزمون بد میتواند از نبود آزمون بدتر باشد
مهمترین بخش نتایج، مقایسهای است که نشان میدهد بازخورد اجرایی حتی میتواند ارزش منفی داشته باشد.
با ثابت ماندن عامل Repair پایه، نویسندگان نرخ حل ۶۱٫۲ درصد را بدون آزمون تولیدشده گزارش میکنند. آزمونهای عامل Test پایه این نرخ را به ۵۷٫۳ درصد میرسانند، در حالی که آزمونهای GPT-5.6 Sol آن را به ۶۵٫۳ درصد افزایش میدهند. بنابراین صرف وجود یک آزمون قابل اجرا، به معنی معتبر بودن سیگنال نیست.
برای سامانههای برنامهنویسی عاملمحور، این نکته مهم است. یک آزمون سبز ممکن است گمراهکننده باشد اگر خود آزمون مسئله را ناقص فهمیده باشد، فقط یک نشانه فرعی را بررسی کند یا همان فرض اشتباه عامل اصلاحکننده را تکرار کند.
آموزش جداگانه کیفیت حلقه را تغییر میدهد
مقاله گزارش میکند که آموزش اختصاصی عامل Test، موفقیت معیار Base-to-Gold را از ۲۲٫۲ درصد به ۶۲٫۲ درصد میرساند. ترکیب عاملهای آموزشدیده Test و Repair نیز طبق گزارش نویسندگان به ۷۲٫۶ درصد روی SWE-bench Verified میرسد؛ ۱۱٫۴ واحد درصد بالاتر از خط پایه اولیه بدون آزمون.
این اعداد نتایج یک پیشچاپ تازهاند و هنوز نباید بهعنوان عملکرد تثبیتشده در محیط تولید تلقی شوند. سامانه ترکیبی همچنین مرحله ساخت آزمون و بازنگری بیشتری دارد، بنابراین مقایسه نهایی از نظر هزینه محاسباتی کاملاً همتراز نیست.
با این حال، آزمایش یک متغیر مهم را روشن میکند: کیفیت مدرکی که برای سنجش اصلاح استفاده میشود تعیین میکند آیا بازخورد به عامل کمک خواهد کرد یا نه.
سازنده تغییر نباید مالک بیقیدوشرط معیار پذیرش باشد
تحلیل Aipolix این است که ExecCritic از یک اصل عمومیتر پشتیبانی میکند: بخشی که تغییر را میسازد نباید کنترل کامل همان مدرکی را داشته باشد که برای پذیرش تغییر استفاده میشود.
در توسعه نرمافزار، آزمونهای تولیدشده نیز به مسیر اعتبارسنجی مستقل نیاز دارند. عامل میتواند کد پیشنهاد کند، اما آزمونی که قرار است به اصلاح جهت بدهد باید پیش از ورود به حلقه بررسی و سپس ثابت شود.
این همان منطقی است که در فرایند انتشار نرمافزار، دروازه پذیرش را بیرون از فرایند تولید نگه میدارد. اگر تولیدکننده بتواند هر بار که شکست خورد معیار را تغییر دهد، آن معیار دیگر کنترل واقعی نیست.
سختگیری پیش از پذیرش، ایده قابل انتقالتری است
سازوکار fail-closed در ExecCritic از خود روش آموزش هم کاربردیتر است. آزمون ابتدا باید نشان دهد شایسته تبدیل شدن به بازخورد است و تنها بعد از آن در حلقه اصلاح استفاده میشود.
در یک تیم واقعی، کنترل مشابه میتواند بررسی کند که آزمون روی نسخه معیوب شکست میخورد، در صورت وجود روی نسخه درست عبور میکند، واقعاً رفتار ذکرشده در مسئله را میسنجد و صرفاً جزئیات پیادهسازی تازه عامل را تثبیت نمیکند.
البته بیشتر مخزنهای واقعی نسخه طلایی یا پاسخ رسمی SWE-bench ندارند. در این حالت، بازبینی انسانی، آزمونهای رگرسیون موجود، بررسی مشخصات یا عامل مستقل میتواند بخشی از فرایند تعیین اعتبار آزمون باشد.
امتیاز نهایی نباید هزینه حلقه اضافه را پنهان کند
عدد ۷۲٫۶ درصد قابل توجه است، اما معماری سامانه اهمیت بیشتری دارد. ExecCritic مرحله تولید آزمون، پذیرش آزمون، بازنگری کد و ارزیابی رسمی را به چرخه اضافه میکند. این مراحل زمان اجرا و مصرف مدل را افزایش میدهند.
تیمی که الگوی مشابهی را آزمایش میکند بهتر است تعداد اصلاحات پذیرفتهشده به ازای هزینه و زمان را بسنجد، نه فقط نرخ حل را. همچنین باید مشخص باشد چند آزمون تولیدشده رد میشوند، چند مورد با آزمونهای موجود تعارض دارند و چند شکست واقعاً اشکال رفتاری را آشکار میکند.
نتیجه عملی برای تیمهای سازنده عامل برنامهنویسی
پیام پژوهش این نیست که «آزمون بیشتری اجرا کنید». پرسش اصلی این است که کدام آزمون اجازه دارد مسیر اصلاح را هدایت کند.
الگوی مناسب میتواند عامل ساخت آزمون را از عامل تعمیر جدا کند، آزمون را پیش از استفاده اعتبارسنجی کند، آزمون پذیرفتهشده را در طول اصلاح ثابت نگه دارد و تصمیم نهایی را به CI و بازبینی معمول مخزن بسپارد.
ExecCritic هنوز پژوهشی مقدماتی است و نتایج آن به بازتولید گستردهتر نیاز دارد. اما نتیجه منفی آن همین حالا ارزش عملی دارد: وقتی سنجشگر اشتباه باشد، بازخورد اجرایی بیشتر میتواند عامل را بدتر کند.