
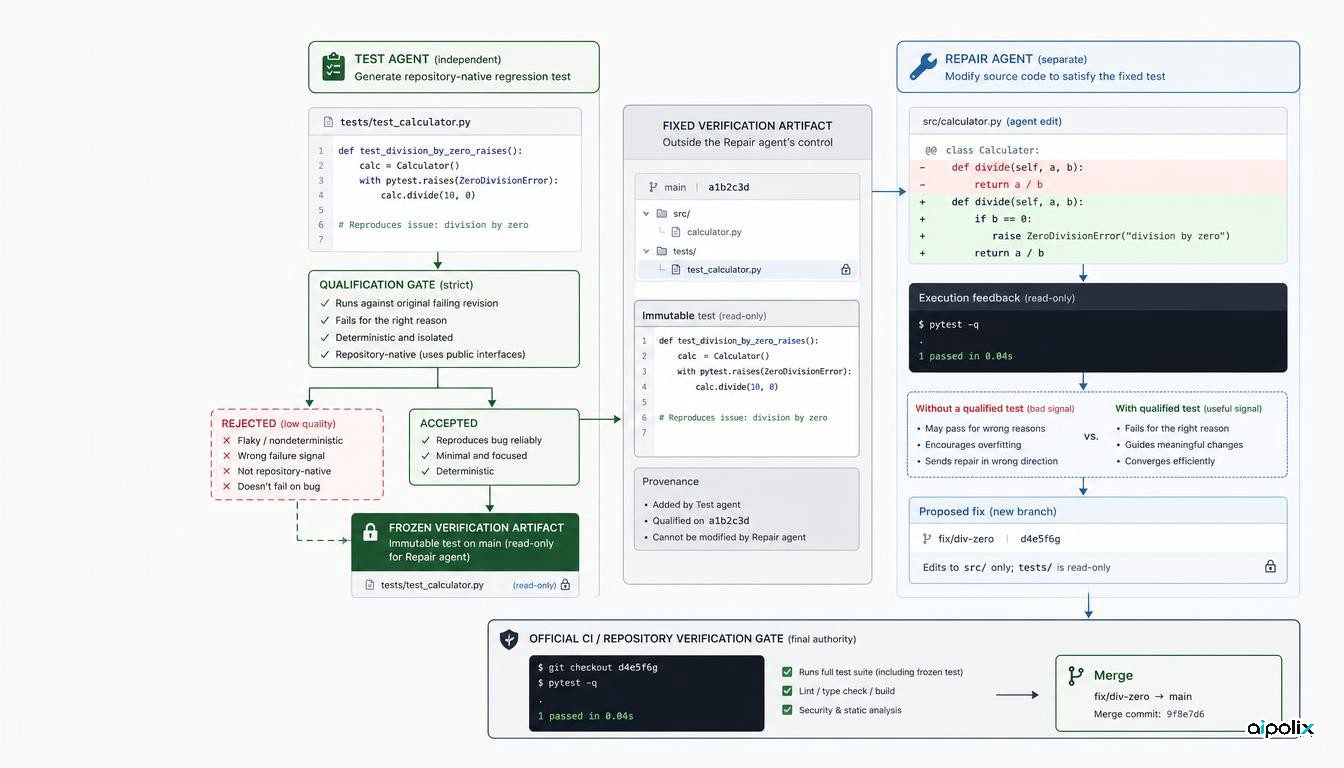
O estudo ExecCritic apresenta um resultado pouco intuitivo para agentes de programação: adicionar testes gerados pode piorar a reparação quando esses testes descrevem mal o comportamento esperado. No SWE-bench Verified, os autores mantêm o mesmo agente Repair e reportam 61,2% de resolução sem testes gerados. Com os testes do agente Test de base, o resultado desce para 57,3%. Com testes produzidos pelo GPT-5.6 Sol, sobe para 65,3%.
Isto mostra que um resultado de execução não se torna fiável apenas por vir de um teste. Se o teste traduz incorretamente o que o problema exige, o agente pode alterar o código até satisfazer um critério errado e ganhar confiança numa solução que se afastou do comportamento pretendido.
Testar e reparar passam a ser responsabilidades separadas
O ExecCritic divide o trabalho em dois papéis. Um agente Test cria testes adaptados ao repositório para representar o comportamento pedido no problema. Um mecanismo conservador avalia esses testes antes de lhes dar autoridade e, depois de aceites, mantém-nos inalterados. Um agente Repair separado modifica então o código com base nos resultados de execução, sem poder reescrever os testes aceites.
Os dois papéis usam Qwen-3.5-35B-A3B e são treinados separadamente. Os autores chamam às duas fases Learn to Test e Test to Improve. O repositório público inclui o percurso de geração dos testes, a orquestração da reparação e a verificação oficial do SWE-bench.
Esta separação elimina uma forma simples de auto-confirmação: depois de uma correção falhar, o agente que o produz não pode tornar o teste menos exigente para fazer a solução parecer correta.
Um teste errado pode ser pior do que nenhum teste
A comparação mais útil não é o melhor número final, mas a demonstração de que o sinal de verificação pode ter valor negativo.
Com o agente Repair de base inalterado, os autores reportam 61,2% sem testes gerados. Os testes do agente Test de base fazem o valor cair para 57,3%, enquanto os testes do GPT-5.6 Sol o elevam para 65,3%. Portanto, a existência de um teste executável não garante que o feedback seja útil.
Num sistema de desenvolvimento com agentes, um teste verde pode ser enganador se verificar apenas um indicador fácil, interpretar mal o pedido ou reproduzir a mesma suposição errada que levou à correção.
Treinar separadamente quem verifica altera o resultado
O artigo afirma que o treino específico do agente Test aumenta o sucesso Base-to-Gold de 22,2% para 62,2%. Quando os agentes Test e Repair treinados são combinados, os autores reportam 72,6% no SWE-bench Verified, mais 11,4 pontos percentuais do que a referência inicial sem testes gerados.
Estes valores pertencem a uma pré-publicação recente e ainda não devem ser tratados como desempenho independente comprovado em produção. A configuração combinada também executa trabalho adicional de criação de testes e revisão, pelo que o ganho não representa uma comparação com custo computacional equivalente.
Ainda assim, a experiência isola uma variável importante: a qualidade da evidência de verificação determina se o ciclo de reparação beneficia ou não do feedback.
Quem produz a alteração não deve controlar sozinho a prova de aceitação
A análise da Aipolix é que o ExecCritic reforça um princípio mais amplo: o componente que cria uma alteração não deve ter controlo irrestrito sobre a evidência usada para aceitar essa alteração.
Em engenharia de software, isto significa que os testes gerados também precisam de uma etapa própria de qualificação. O agente pode propor código, mas a evidência que orienta ou aceita a reparação deve ser fixada, validada externamente ou produzida por um papel independente antes de o ciclo otimizar contra ela.
É o mesmo motivo pelo qual as regras de integração e entrega ficam fora do processo que produz o artefacto. Se o produtor puder mudar o critério sempre que falha, esse critério deixa de funcionar como controlo.
A qualificação conservadora é a ideia mais reutilizável
O mecanismo do ExecCritic é relevante para além da receita de treino. O teste tem de demonstrar que merece tornar-se feedback; só depois é congelado e usado no ciclo de reparação.
Num repositório real, um controlo semelhante pode verificar se o teste falha no estado defeituoso, se passa numa referência correta quando existe, se mede realmente o comportamento descrito e se não cristaliza apenas detalhes de implementação introduzidos pelo agente.
A maioria das equipas não dispõe de uma correção de referência como num benchmark. Nesse caso, a decisão pode combinar testes de regressão existentes, revisão humana, especificações e um agente independente.
O melhor resultado não deve esconder o custo do ciclo extra
Os 72,6% reportados são relevantes, mas a arquitetura acrescenta geração de testes, qualificação, revisão da correção e verificação oficial. Tudo isto aumenta inferências, execuções e latência relativamente a uma reparação de uma só passagem.
Uma equipa que experimente esta abordagem deve medir correções aceites por unidade de custo e tempo, quantos testes gerados são rejeitados, quantos entram em conflito com a suite existente e quanto trabalho humano continua a ser necessário.
O que as equipas devem retirar do estudo
A conclusão não é simplesmente «executar mais testes». A questão central é decidir que testes têm autoridade para orientar a reparação.
Um desenho de produção pode separar a criação de testes da alteração do código, qualificar os testes antes de os usar, manter inalterada a evidência aceite durante a reparação e deixar a decisão final na CI e na revisão normal do repositório.
O ExecCritic continua a ser investigação preliminar e os resultados precisam de reprodução mais ampla. Mas o resultado negativo já tem valor prático: quando o verificador está errado, mais feedback de execução pode tornar o agente pior.