
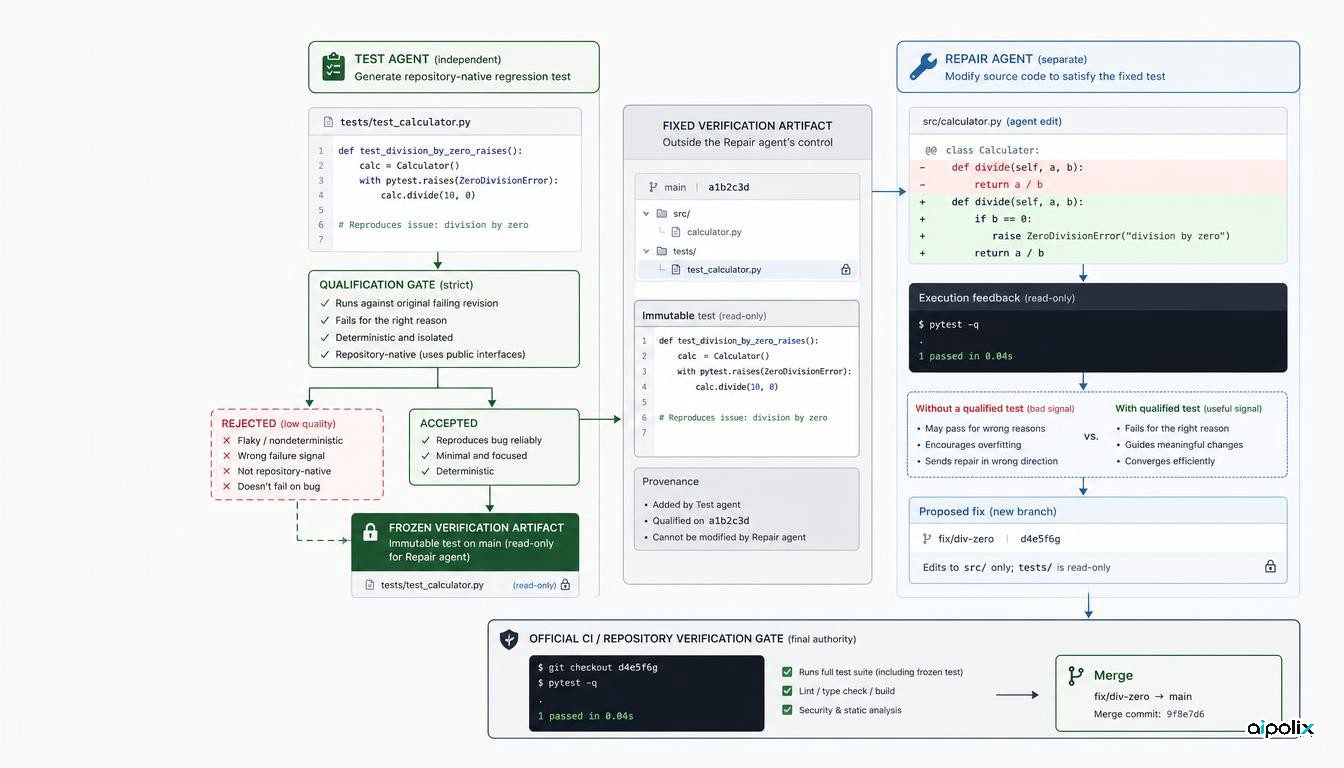
L’étude ExecCritic met en évidence un risque peu intuitif pour les agents de programmation : ajouter des tests générés peut dégrader les réparations lorsque ces tests décrivent mal le comportement attendu. Sur SWE-bench Verified, les auteurs gardent le même agent Repair et indiquent un taux de résolution de 61,2 % sans test généré. Avec les tests de leur agent Test de base, ce taux tombe à 57,3 %. Avec des tests produits par GPT-5.6 Sol, il monte à 65,3 %.
Le résultat remet en cause une hypothèse fréquente dans les boucles de correction automatique : un retour d’exécution n’est pas fiable simplement parce qu’il provient d’un test exécutable. Si le test formalise une mauvaise interprétation du ticket, l’agent peut optimiser le code pour satisfaire un critère erroné.
Tester et réparer deviennent deux responsabilités distinctes
ExecCritic sépare explicitement les rôles. Un agent Test construit des tests adaptés au dépôt afin de traduire le comportement demandé dans le ticket. Un mécanisme de validation fonctionne en mode fermé par défaut : le test doit être qualifié avant de pouvoir guider la réparation, puis il est figé. Un agent Repair distinct modifie ensuite le code source à partir des résultats d’exécution sans pouvoir réécrire les tests acceptés.
Les deux rôles utilisent Qwen-3.5-35B-A3B et font l’objet d’un entraînement séparé. Les auteurs appellent ces étapes Learn to Test et Test to Improve. Le dépôt public contient le chemin de génération des tests, l’orchestration de la réparation et les outils de vérification officielle SWE-bench.
Cette séparation retire au producteur du correctif une possibilité simple d’auto-validation : il ne peut pas assouplir le test après avoir constaté que son correctif échoue.
Un mauvais test peut être pire que l’absence de test
La comparaison la plus instructive ne porte pas sur le meilleur score final, mais sur la valeur du signal de vérification.
À agent Repair identique, les auteurs rapportent 61,2 % de résolution sans tests générés. Les tests du Test agent de base font baisser le résultat à 57,3 %, alors que ceux de GPT-5.6 Sol le portent à 65,3 %. L’existence d’un test ne suffit donc pas à rendre le retour utile.
Dans un système de développement agentique, un test vert peut donner une fausse assurance s’il ne couvre qu’un substitut facile à satisfaire, s’il interprète mal le problème ou s’il reproduit la même hypothèse erronée que le correctif.
Entraîner séparément le vérificateur change la boucle
Les auteurs indiquent que l’entraînement spécialisé de l’agent Test fait passer son taux Base-to-Gold de 22,2 % à 62,2 %. La composition des agents Test et Repair entraînés atteint, selon l’article, 72,6 % sur SWE-bench Verified, soit 11,4 points de plus que la référence initiale sans tests générés.
Ces chiffres proviennent d’une prépublication récente et ne constituent pas encore des mesures reproduites indépendamment en production. La configuration composée exécute aussi davantage d’étapes de génération de tests et de révision ; le gain ne doit donc pas être interprété comme une comparaison à coût de calcul identique.
L’expérience isole néanmoins un facteur d’architecture important : la qualité de l’artefact de vérification détermine si la boucle de correction profite réellement du retour d’exécution.
Le producteur ne doit pas définir seul sa preuve d’acceptation
L’analyse d’Aipolix est que le résultat soutient un principe plus général : le composant qui produit une modification ne devrait pas disposer d’un contrôle sans limite sur les preuves qui servent à l’accepter.
Dans une chaîne de développement, les tests générés doivent donc eux-mêmes franchir une étape de qualification. L’agent peut proposer un correctif, mais la preuve utilisée pour guider ou accepter ce correctif devrait être figée, contrôlée séparément ou produite par un rôle indépendant.
C’est le même raisonnement qui justifie de placer les contrôles de mise en production hors du processus qui fabrique l’artefact. Si le producteur peut redéfinir le critère chaque fois qu’il échoue, le contrôle perd sa fonction.
La qualification fermée par défaut est l’idée la plus transférable
Le mécanisme d’ExecCritic est intéressant au-delà de sa recette d’entraînement. Avant qu’un test puisse influencer la réparation, le système cherche à déterminer s’il constitue un signal valable ; une fois accepté, il reste immuable pendant la boucle.
Dans un dépôt réel, un dispositif analogue peut vérifier qu’un test échoue bien sur l’état défectueux, qu’il passe sur une référence correcte lorsqu’elle existe, qu’il correspond au comportement décrit et qu’il n’entérine pas simplement un détail introduit par l’agent.
Les équipes ne disposent généralement pas d’un correctif de référence comme dans un benchmark. Elles peuvent alors combiner tests de régression existants, revue humaine, spécifications et évaluateur indépendant pour décider si un nouveau test mérite de devenir une contrainte.
Le score final ne doit pas masquer le coût supplémentaire
Le résultat de 72,6 % est notable, mais ExecCritic ajoute une génération de tests, une qualification, une révision et une vérification officielle. Ces étapes augmentent le nombre d’inférences et d’exécutions par rapport à une réparation en un seul passage.
Pour une adoption réelle, il faut mesurer les correctifs acceptés par unité de coût et de latence, le taux de rejet des tests générés, leurs contradictions avec les suites existantes et la quantité de reprise humaine nécessaire.
Ce que les équipes peuvent retenir
La leçon n’est pas simplement « exécuter davantage de tests ». Elle consiste à décider quels tests ont le droit de guider l’agent.
Un schéma de production raisonnable sépare la génération des tests de la réparation, qualifie les tests avant de leur donner autorité, fige les éléments de vérification acceptés pendant la correction et conserve la décision finale dans la CI et la revue du dépôt.
ExecCritic reste un travail préliminaire qui devra être reproduit plus largement. Son résultat négatif est toutefois déjà utile : lorsque le vérificateur se trompe, davantage de retour d’exécution peut rendre l’agent moins performant.