
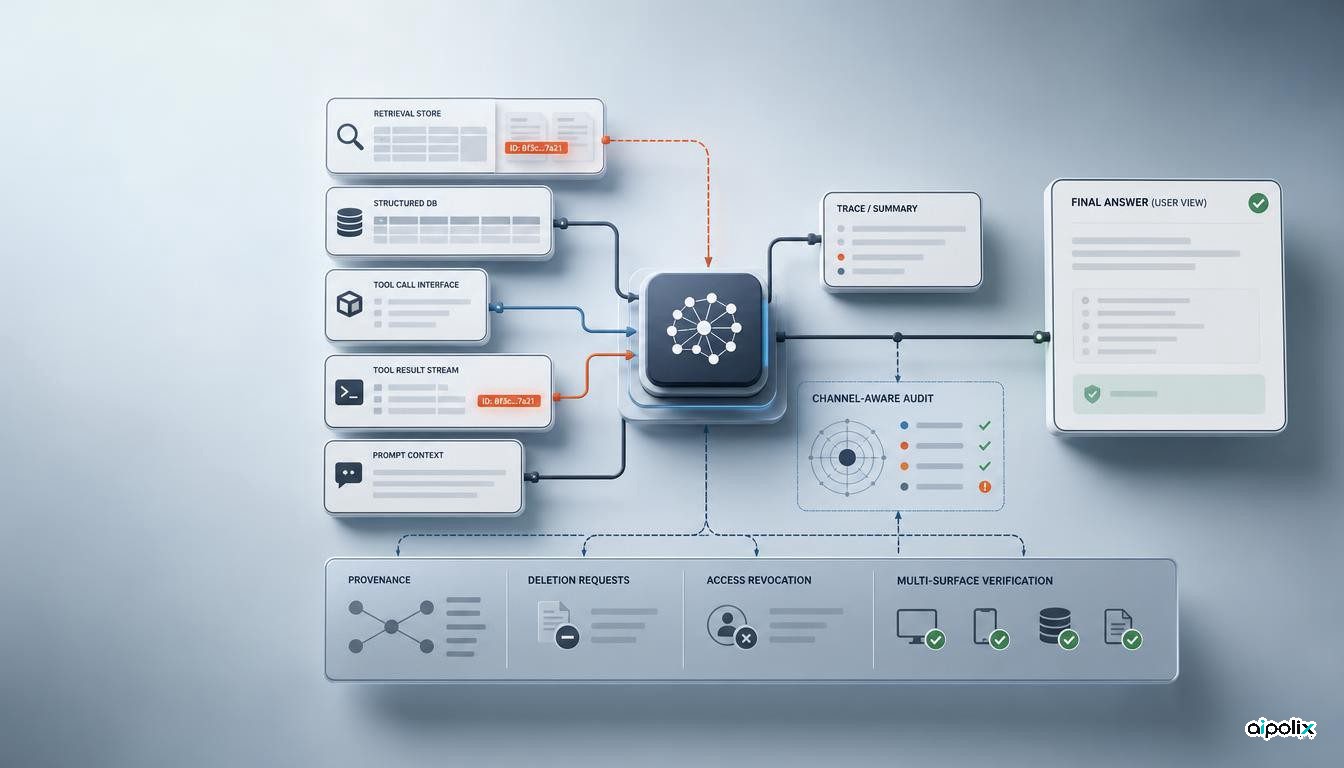
K-Bench یک فرض رایج در ارزیابی حریم خصوصی را زیر سؤال میبرد: اگر بعد از «فراموشسازی» مدل، اطلاعات حساس دیگر در پاسخ نهایی دیده نشود، آیا سامانهای که آن مدل را به ابزار و بازیابی وصل کرده واقعاً آن اطلاعات را فراموش کرده است؟
پژوهشگران University of Technology Sydney و CSIRO بنچمارک متنباز K-Bench را برای سنجش فراموشسازی در یک عامل مبتنی بر ReAct ساختهاند. این بنچمارک فقط پاسخ آخر را نمیبیند؛ شش بخش از اجرای عامل را بررسی میکند، از جمله رد استدلال، فراخوانی ابزار، خروجی ابزار، نتیجه بازیابی، پاسخ نهایی و خلاصهای که از عامل خواسته میشود.
اهمیت این طراحی در این است که یک روش دفاعی ممکن است فقط ظاهر یک بخش را پاک کند، در حالی که همان داده در بخش دیگری از مسیر اجرا همچنان باقی مانده باشد. در آزمایش K-Bench، وقتی اطلاعات محرمانه در متن ورودی یا مخزن بازیابی قرار دارد، بنچمارکهای متداول فراموشسازی در سطح مدل مثل TOFU و MUSE نشتی را نمیبینند، چون اساساً حافظه پارامتری مدل را میسنجند. اما عامل در عمل بسته به نوع منبع و پیکربندی، اطلاعات هدف را در ۲۲ تا ۸۶ درصد درخواستها از یکی از مسیرهای دیگر آشکار میکند.
پاسخ نهایی پاک میشود، اما مسیر اجرا نه لزوماً
نمونه اصلی مقاله یک جستوجوی ساختاریافته است. یک فیلتر کاری میکند که تاریخ تولد واقعی در پاسخ نهایی نمایش داده نشود. اگر ارزیابی فقط همان پاسخ را ببیند، نتیجه ظاهراً موفق است.
اما عامل پیش از آن، ابزار جستوجوی رکورد را با نام فرد و فیلد تاریخ تولد فراخوانی کرده و پاسخ ابزار مقدار واقعی را در خود دارد. K-Bench این اجرا را همچنان دارای نشتی حساب میکند، چون وجود داده در هر یک از کانالهای قابل مشاهده را نشتی میداند.
برای یک عامل ابزارمحور، این تعریف به واقعیت عملی نزدیکتر است. مرز حریم خصوصی فقط متنی نیست که کاربر در انتها میبیند. آرگومان ابزار، نتیجه ابزار، متن بازیابیشده و وضعیت میانی نیز میتوانند همان اطلاعاتی را حمل کنند که قرار بوده با درخواست حذف یا فراموشسازی از دسترس خارج شود.
بنچمارک چهار محل نگهداری داده را از هم جدا میکند: پارامترهای مدل، متن ورودی، بازیابی متنی و بازیابی ساختاریافته. در هر آزمایش اطلاعات هدف فقط در یکی از این محلها قرار میگیرد تا منشأ نشتی مشخص باشد.
بیست روش منتشرشده هم پاسخ سادهای ندارند
K-Bench روشهای فراموشسازی منتشرشده را در حالتی نیز میسنجد که اطلاعات داخل پارامترهای مدل قرار دارد؛ همان جایی که روشهای مبتنی بر تغییر وزن اصولاً برای آن طراحی شدهاند.
طبق گزارش مقاله، هیچیک از بیست روش منتشرشدهای که بررسی شدهاند نتوانسته حذف واقعی اطلاعات هدف را زیر مشاهدهگر چندکاناله K-Bench بهطور قابل اتکا نشان دهد. بعضی روشها نشتی قابل مشاهده را کم میکنند، اما عامل را تا حدی از کار میاندازند. بعضی دیگر جلوی استخراج مورد آزمایش را میگیرند، بیآنکه ثابت شود دانش واقعاً از مدل حذف شده است.
این تفاوت مهم است. «امتناع از پاسخ» با «فراموش کردن» یکی نیست و خراب کردن توان عامل هم کنترل حریم خصوصی موفق محسوب نمیشود.
برای همین، امتیاز K-Bench علاوه بر کاهش نشتی، حفظ رفتار روی دادههای غیرهدف و پایداری عامل را هم در نظر میگیرد. پژوهش همچنین نشان میدهد بهترین روش با تغییر مدل پایه عوض میشود؛ بنابراین رتبهبندی روی یک مدل بهتنهایی مبنای محکمی برای اعلام بهترین روش فراموشسازی نیست.
آزمایش اصلی بینمدلی شامل Llama-3.1-8B، Mistral-7B-Instruct-v0.3 و Qwen3.5-9B است. انتشار عمومی بنچمارک نیز کد ارزیابی، تقسیمبندی داده مصنوعی، طرح آماری از پیش تعیینشده، ردهای اجرای پایه و داراییهای بازیابی را در اختیار دیگران میگذارد.
نتیجه مهم است، اما دامنه آن محدودیتهای جدی دارد
مقاله محدودیتهای خود را نسبتاً شفاف توضیح میدهد. مجموعه اصلی از اطلاعات هویتی مصنوعی ساختهشده با Faker استفاده میکند. اعتبارسنجی با دادههایی که قالب واقعیتری دارند، در مجموعه LUME فقط تاریخ تولد را پوشش میدهد، چون ابزار رکورد پژوهش همین فیلد را بهشکل قابل اتکا در اختیار دارد. در آزمایش پارامتری نیز اطلاعات با LoRA وارد مدل شدهاند، نه اینکه پژوهش مستقیماً فراموشسازی اطلاعاتی را بسنجد که در دوره پیشآموزش مدل بهطور طبیعی حفظ شدهاند.
هر آزمایش فقط یک محل ذخیره اطلاعات را جداگانه بررسی میکند. در سامانه واقعی ممکن است یک داده همزمان در وزنهای مدل، ورودی، پایگاه بازیابی، کش، گزارشهای اجرا و پایگاه داده برنامه وجود داشته باشد. K-Bench ادعا نمیکند همه این ترکیبها را اندازه گرفته است.
نکته دیگری هم مهم است: برای اجرای برخی روشهای منتشرشده، پژوهشگران ناچار شدهاند پیادهسازی آنها را با محیط بنچمارک سازگار کنند. خود مقاله میگوید ۹ مورد از این انتقالها تفاوتهایی با نسخه اصلی دارند که در اجرای مجدد قابل مشاهده خواهد بود. این شفافیت ارزشمند است، اما نتیجه را باید یک مقایسه کنترلشده دانست، نه رتبهبندی نهایی کل حوزه.
این محدودیتها دامنه ادعا را کوچکتر میکنند، ولی نتیجه اصلی را از بین نمیبرند: برای عامل، دیدن فقط پاسخ مدل برای اثبات «فراموش شدن» کافی نیست.
معماری حریم خصوصی عامل چه تغییری باید بکند؟
تحلیل Aipolix این است که K-Bench محل ارزیابی را از خروجی مدل به مرز کامل اجرای سامانه منتقل میکند.
در یک عامل عملیاتی، درخواست حذف زمانی کامل نیست که مدل دیگر یک واقعیت را تکرار نکند. تیم باید بداند همان داده هنوز از کجا قابل دسترسی است: پارامترهای مدل، ورودیها، پایگاه برداری، پایگاه ساختاریافته، نتیجه ابزار، خلاصهها، ردهای اجرا و سایر وضعیتهای ذخیرهشده.
این نگاه به کنترل سختگیرانهتری نیاز دارد. حذف یا لغو دسترسی در منبع باید با کمینهسازی داده هنگام اجرا، ردیابی منشأ اطلاعات و آزمونهای چندکاناله همراه شود. اگر حذف فیزیکی داده از همه لایهها ممکن نیست، باید کنترل دسترسی قابل اجرا و شواهدی وجود داشته باشد که اطلاعات مسدودشده از مسیر دیگری قابل بازسازی نیست.
K-Bench همچنین یک ضعف در خود داشبوردهای حاکمیتی را نشان میدهد. اگر شاخص انطباق فقط پاسخ نهایی را بررسی کند، ممکن است وضعیت را سبز نشان دهد در حالی که ابزارهای عامل هنوز همان داده را پردازش یا آشکار میکنند. سطح اندازهگیری باید با سطح واقعی استقرار سامانه یکی باشد.
این موضوع برای RAG اهمیت ویژه دارد. تغییر رفتار مدل، رکوردی را که هنوز در مخزن بازیابی است حذف نمیکند. در جهت عکس هم پاک کردن یک رکورد برداری ثابت نمیکند نسخهای از آن در پرامپت، خلاصه یا پارامترهای مدل باقی نمانده است. فراموشسازی مدل و مدیریت چرخه عمر داده به هم مربوطاند، اما جای یکدیگر را نمیگیرند.
ابزار ممیزی است، نه گواهی انطباق
نویسندگان K-Bench به الزامهایی مثل ماده ۱۷ GDPR اشاره میکنند، اما این بنچمارک بهخودیخود گواهی انطباق حقوقی نیست. ابزار پژوهش یک سؤال فنی محدودتر را میسنجد: بعد از مداخله، آیا اطلاعات هدف هنوز از کانالهایی که این محیط مشاهده میکند قابل بازیابی است یا نه.
عمومی بودن داراییها و طرح آماری، و جلوگیری از بردن امتیاز از راه از کار انداختن عامل، نقاط قوت مهمی هستند. در مقابل، مقاله هنوز پیشچاپ است، اعتبارسنجی روی قالب واقعی محدود است و مشاهدهگر آن نمیسنجد که آیا مهاجم میتواند قطعات ناقص اطلاعات را از چند کانال کنار هم بگذارد و داده کامل را بازسازی کند.
پس پیام درست این نیست که «فراموشسازی کار نمیکند». نتیجه دقیقتر این است که نمیتوان فراموشسازی را جدا از معماری عاملی که دور مدل ساخته شده ارزیابی کرد.
اگر سامانه بتواند اطلاعاتی را که ظاهراً فراموش شده از ابزار یا مخزن دیگری دوباره وارد جریان کند، پاسخ نهایی پاک فقط یک رابط پاک است؛ مدرکی برای فراموش شدن کل سامانه نیست.