
O K-Bench põe em causa uma suposição comum nas avaliações de privacidade: se uma técnica de desaprendizagem faz desaparecer uma informação sensível da resposta final, será que o agente em produção a esqueceu realmente?
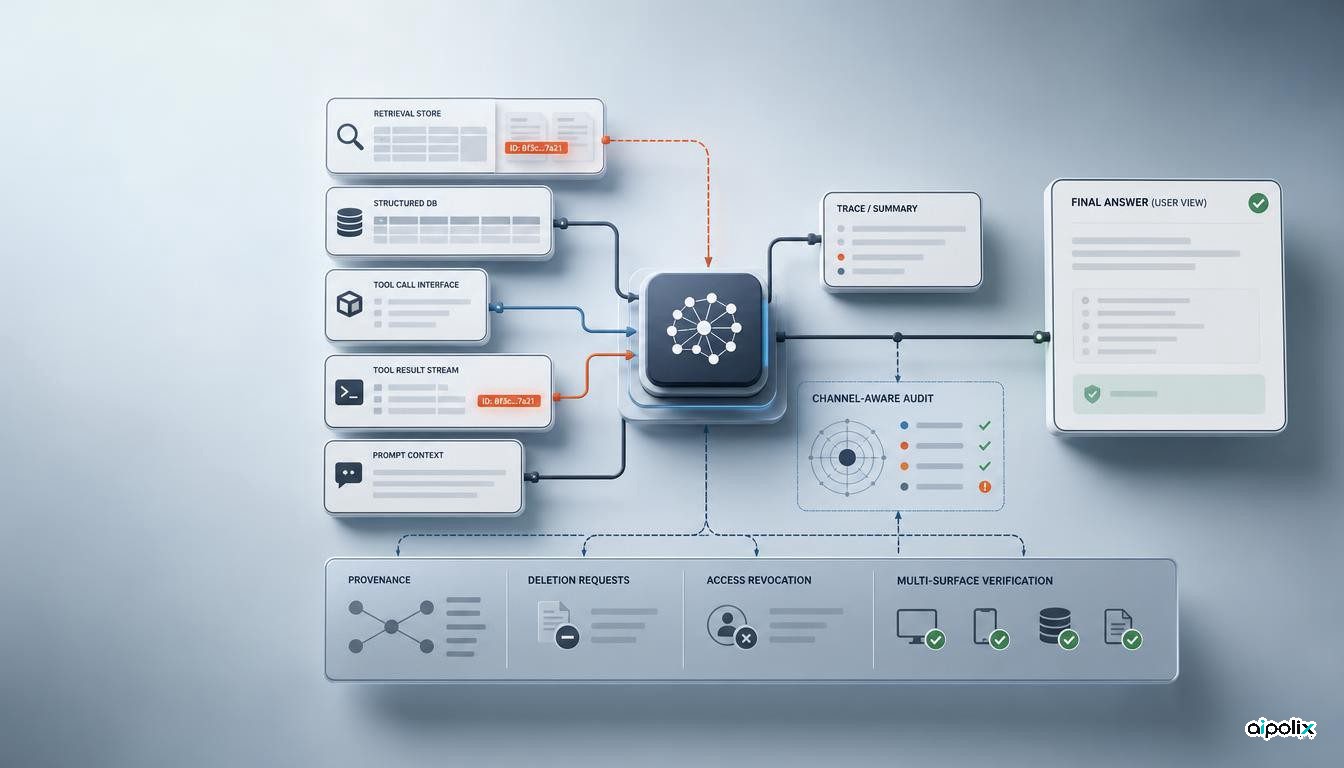
Investigadores da University of Technology Sydney e da CSIRO criaram o K-Bench, um benchmark aberto para avaliar desaprendizagem num agente do tipo ReAct. Em vez de observar apenas a resposta final, o sistema analisa seis superfícies da execução, incluindo o raciocínio intermédio, chamadas a ferramentas, resultados dessas ferramentas, conteúdo recuperado, resposta e resumo solicitado ao agente.
A diferença é importante porque uma defesa pode limpar uma saída e deixar a mesma informação disponível noutro ponto do percurso. No K-Bench, quando o segredo está no contexto ou na camada de recuperação, benchmarks tradicionais como TOFU e MUSE não registam fuga porque se concentram na memória paramétrica do modelo. O agente, no entanto, continua a expor a informação alvo em 22% a 86% das consultas, consoante o suporte e a configuração.
Uma resposta limpa pode esconder uma execução com fuga
O exemplo principal do artigo usa recuperação estruturada. Um filtro altera a resposta final para que a verdadeira data de nascimento já não apareça. Um teste que só olha para essa saída considera, por isso, que a informação foi suprimida.
Mas o agente já chamou uma ferramenta de consulta de registos para obter a data de nascimento da pessoa, e o resultado da ferramenta contém o valor correto. O K-Bench continua a marcar a execução como fuga, porque considera exposição a presença do segredo em qualquer canal observado.
Para agentes que usam ferramentas, esta definição aproxima-se mais da realidade operacional. A fronteira de privacidade não é apenas o texto mostrado ao utilizador. Argumentos enviados às ferramentas, respostas dessas ferramentas, passagens recuperadas e estado intermédio também podem transportar os dados que um pedido de apagamento pretendia tornar inacessíveis.
O benchmark separa quatro suportes de memória: parâmetros do modelo, contexto de entrada, recuperação em texto livre e recuperação estruturada. Cada experiência coloca o segredo apenas num deles, permitindo identificar a origem da fuga.
Vinte métodos publicados não resolvem o problema
O K-Bench também testa métodos de desaprendizagem quando a informação está nos parâmetros, precisamente o cenário em que as técnicas de alteração de pesos são desenhadas para atuar.
O artigo conclui que nenhum dos vinte métodos publicados avaliados demonstra remover o segredo sob o observador multicanal do K-Bench. Alguns reduzem a fuga visível à custa de degradar o agente. Outros resistem à extração testada sem permitir concluir que o conhecimento subjacente foi efetivamente eliminado.
Recusar responder não é o mesmo que esquecer, e inutilizar o agente não é uma boa solução de privacidade.
Por isso, a pontuação combina supressão do alvo, preservação do comportamento em dados que devem ser mantidos e estabilidade do agente. O estudo também mostra que o método mais bem classificado muda com o modelo de base. Uma classificação baseada num único modelo é, assim, uma base fraca para afirmar qual é a melhor técnica de desaprendizagem.
O trabalho inclui Llama-3.1-8B, Mistral-7B-Instruct-v0.3 e Qwen3.5-9B na comparação entre modelos. A versão aberta disponibiliza código de avaliação, conjuntos sintéticos de PII, um plano estatístico pré-registado, traços de referência e recursos usados na recuperação.
O resultado é relevante, mas o âmbito é mais estreito do que o título pode sugerir
Os autores descrevem limitações importantes. O corpus principal usa dados pessoais sintéticos gerados com Faker. A validação com registos de formato mais realista do benchmark LUME cobre apenas datas de nascimento, porque esse é o atributo suportado de forma limpa pela ferramenta de registos usada no estudo. Nos testes paramétricos, a informação é introduzida com afinação com LoRA, não adquirida naturalmente durante o pré-treino.
Cada célula experimental isola ainda um único suporte. Num serviço real, o mesmo dado pode existir ao mesmo tempo nos pesos, num prompt, numa base vetorial, numa base estruturada, numa cache ou em registos de execução. O K-Bench não afirma medir todas essas combinações.
Há outra reserva material: várias implementações publicadas tiveram de ser adaptadas ao ambiente do benchmark. Os autores indicam que nove dessas adaptações diferem das versões originais de formas que podem alterar uma repetição da experiência. A transparência é positiva, mas significa que os resultados devem ser lidos como uma comparação controlada, não como um ranking definitivo de toda a área.
Estas limitações reduzem a generalização, mas não eliminam a conclusão de sistemas: olhar apenas para a resposta do modelo não basta para certificar esquecimento num agente que expõe canais adicionais.
A arquitetura de privacidade tem de abranger todo o agente
A análise da Aipolix é que o K-Bench desloca a unidade de verificação do ponto de saída do modelo para toda a fronteira de execução.
Num agente em produção, um pedido de apagamento não termina quando o modelo deixa de repetir um facto. A equipa precisa de saber onde esse facto ainda pode ser alcançado: parâmetros, prompts, bases vetoriais, bases estruturadas, respostas de ferramentas, resumos, traços e outros estados persistentes.
Isto exige um modelo de controlo mais rigoroso. A eliminação ou revogação na origem deve ser combinada com minimização de dados em tempo de execução, proveniência explícita e testes que cubram os vários canais. Quando não é possível remover fisicamente uma informação de todas as camadas, são necessários controlos de acesso executáveis e evidência de que a informação bloqueada não pode ser reconstruída por outro caminho.
O K-Bench também revela um risco nos próprios painéis de conformidade. Uma métrica que mede apenas a resposta final pode ficar verde enquanto as ferramentas do agente continuam a processar ou expor os mesmos dados internamente. A superfície de medição tem de corresponder à superfície de implantação.
Isto é particularmente relevante em arquiteturas RAG. Fazer o modelo deixar de mencionar um dado não o remove de uma base de recuperação. No sentido inverso, apagar um vetor não prova que já não existe uma cópia num prompt, num resumo ou nos parâmetros. Desaprendizagem e gestão do ciclo de vida dos dados estão relacionadas, mas não são substitutas.
É um instrumento de auditoria, não um certificado de conformidade
Os autores ligam o K-Bench a obrigações de apagamento, incluindo o artigo 17.º do RGPD. O benchmark, porém, não é por si só prova de conformidade jurídica. Mede uma questão técnica mais limitada: depois de uma intervenção, a informação alvo continua recuperável através dos canais observados pelo ambiente de avaliação?
Para equipas que decidem como usar estes resultados, a distinção é importante. O benchmark é útil porque os recursos e o protocolo estatístico são públicos e porque a métrica penaliza métodos que obtêm um bom resultado apenas ao quebrar o agente. Continua, contudo, a ser uma pré-publicação; a validação em formato realista é limitada; e o observador não tenta recompor um segredo juntando fragmentos parciais provenientes de vários canais.
A conclusão prática não é «a desaprendizagem não funciona». É mais precisa: não se pode avaliar desaprendizagem isoladamente da arquitetura de agentes que envolve o modelo.
Se o agente consegue recuperar, transformar ou transportar uma informação supostamente esquecida através de outro componente, uma resposta final limpa é apenas uma interface limpa. Não é prova de que o sistema esqueceu.