
K-Bench remet en cause une hypothèse courante de l'évaluation de la confidentialité : si une méthode de désapprentissage fait disparaître une information sensible de la réponse finale, peut-on considérer que l'agent déployé l'a réellement oubliée ?
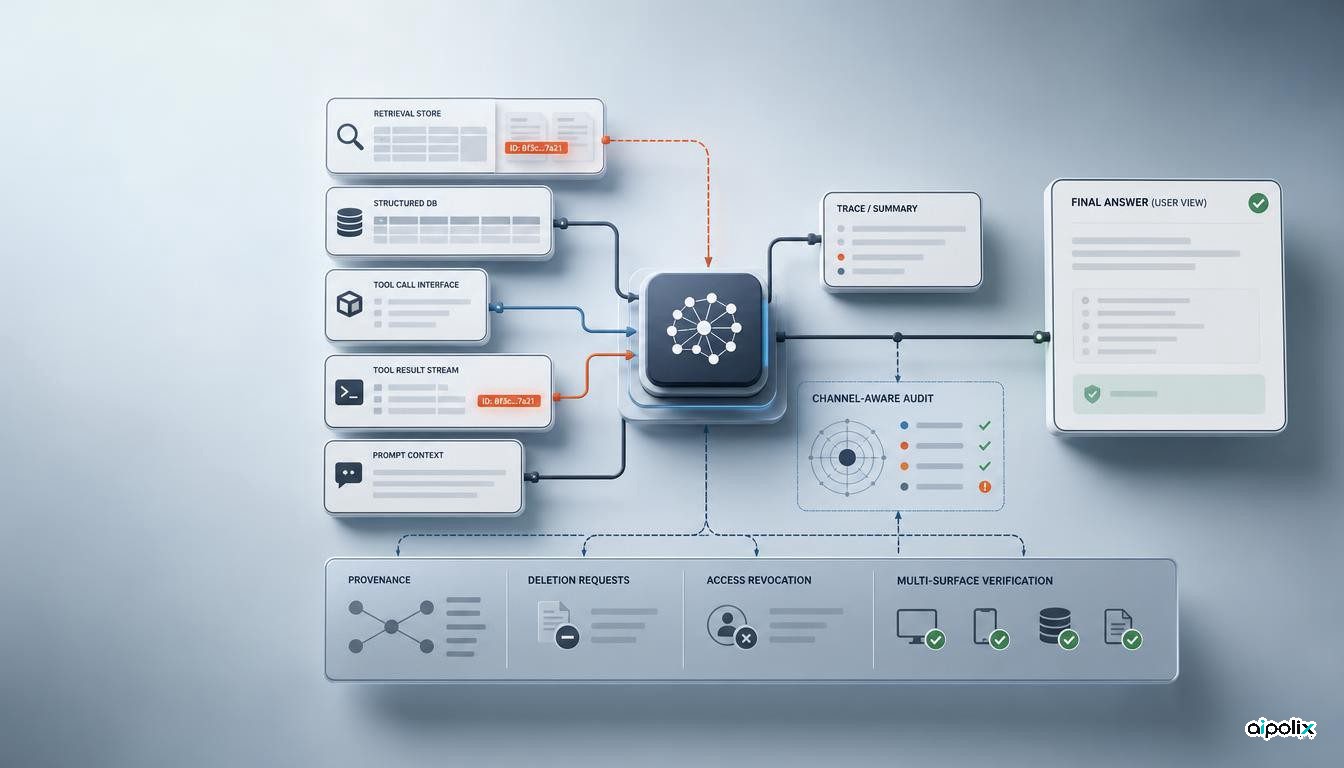
Des chercheurs de l'University of Technology Sydney et du CSIRO proposent K-Bench, un benchmark ouvert qui évalue le désapprentissage dans un agent de type ReAct. Au lieu d'observer uniquement la réponse finale, il inspecte six surfaces de l'exécution : trace de raisonnement, appels d'outils, résultats des outils, contenu récupéré, réponse et résumé demandé à l'agent.
Cette différence est essentielle. Une défense peut nettoyer une sortie tout en laissant la même information accessible ailleurs dans la chaîne d'exécution. Dans K-Bench, lorsque le secret se trouve dans le contexte ou dans le système de récupération, des benchmarks classiques comme TOFU et MUSE ne détectent aucune fuite parce qu'ils interrogent surtout la mémoire paramétrique du modèle. L'agent déployé continue pourtant d'exposer l'information cible dans 22 % à 86 % des requêtes, selon le support et la configuration.
Une réponse propre peut masquer une exécution qui fuit
L'exemple central du papier utilise une récupération structurée. Un filtre modifie la réponse finale de sorte que la vraie date de naissance n'y apparaisse plus. Une évaluation limitée à cette réponse conclut donc que l'information a été supprimée.
Mais l'agent a déjà demandé au service de consultation de dossiers la date de naissance de la personne, et le résultat de l'outil contient la valeur exacte. K-Bench classe toujours l'exécution comme une fuite, car la présence du secret dans n'importe quel canal observé suffit.
Pour un système qui utilise des outils, cette définition est plus proche de la réalité opérationnelle. La frontière de confidentialité ne se réduit pas au texte présenté à l'utilisateur. Arguments d'outils, résultats, passages récupérés et état intermédiaire peuvent transporter des données qu'une procédure de suppression était censée rendre inaccessibles.
Le benchmark distingue quatre supports : paramètres du modèle, contexte d'entrée, récupération de texte libre et récupération structurée. Chaque expérience place le secret dans un seul support afin d'identifier précisément l'origine de la fuite.
Vingt méthodes publiées ne ferment pas le problème
K-Bench évalue également des méthodes de désapprentissage lorsque l'information se trouve dans les paramètres, c'est-à-dire sur le terrain où les techniques de modification des poids sont censées agir.
Selon l'étude, aucune des vingt méthodes publiées évaluées ne démontre la suppression du secret sous l'observation multicanal de K-Bench. Certaines diminuent la fuite visible au prix d'une forte dégradation de l'agent. D'autres résistent à l'extraction testée sans permettre d'établir que la connaissance sous-jacente a réellement été supprimée.
Refuser de répondre n'est donc pas synonyme d'oublier, et rendre l'agent inutilisable n'est pas une réussite en matière de confidentialité.
Le score du benchmark tient compte à la fois de la suppression du secret, de la conservation des comportements non ciblés et de la stabilité de l'agent. Les auteurs constatent aussi que la méthode la mieux classée change selon le modèle de base. Un classement établi sur un seul modèle est donc insuffisant pour désigner une méthode de désapprentissage comme supérieure en général.
L'étude couvre notamment Llama-3.1-8B, Mistral-7B-Instruct-v0.3 et Qwen3.5-9B. La publication ouverte comprend le code d'évaluation, les partitions de données PII synthétiques, un protocole statistique préenregistré, des traces de référence et les ressources de récupération.
Un résultat fort, mais avec un périmètre précis
Les auteurs détaillent plusieurs limites qui empêchent d'étendre trop vite les conclusions. Le corpus principal contient des données personnelles synthétiques produites avec Faker. La validation sur des enregistrements au format plus réaliste issus de LUME se limite à la date de naissance, car c'est l'attribut correctement pris en charge par l'outil utilisé dans l'étude. Pour le support paramétrique, l'information cible est injectée par ajustement avec LoRA, pas acquise naturellement pendant le préentraînement.
Chaque expérience isole aussi un seul support. Dans un service réel, une même donnée peut exister simultanément dans les poids, un prompt, une base vectorielle, une base structurée, un cache ou des journaux. K-Bench ne prétend pas avoir mesuré toutes ces combinaisons.
Autre réserve importante : plusieurs implémentations publiées ont dû être adaptées au cadre expérimental. Les auteurs indiquent que neuf ports diffèrent de leur version d'origine d'une manière qui pourrait modifier une réexécution. Cette transparence renforce la lecture critique, mais elle signifie que l'étude est une comparaison contrôlée et non un classement définitif du domaine.
Ces limites réduisent la portée du résultat sans remettre en cause son point central : une évaluation limitée à la réponse du modèle ne suffit pas pour certifier l'oubli dans un agent qui expose d'autres canaux.
La confidentialité doit être vérifiée à l'échelle du système
L'analyse d'Aipolix est que K-Bench déplace l'unité de contrôle du point de terminaison du modèle vers l'ensemble de la frontière d'exécution.
Dans un agent en production, une demande d'effacement n'est pas terminée simplement parce que le modèle cesse de répéter un fait. Il faut savoir où ce fait reste accessible : paramètres, prompts, bases vectorielles, bases structurées, réponses d'outils, résumés, traces ou autres états persistants.
Cela impose un modèle de contrôle plus exigeant. La suppression ou la révocation à la source doit être complétée par une minimisation des données à l'exécution, une provenance explicite et des tests couvrant les différents canaux. Lorsqu'une suppression physique partout est impossible, des contrôles d'accès effectifs doivent empêcher une reconstruction par un autre chemin.
K-Bench révèle aussi une faiblesse possible des tableaux de bord de conformité. Une métrique qui inspecte seulement la réponse finale peut afficher un résultat rassurant alors que les outils de l'agent continuent de traiter la même donnée en interne. La surface mesurée doit correspondre à la surface réellement déployée.
Le problème est particulièrement visible avec le RAG. Modifier le comportement du modèle ne supprime rien d'un magasin de récupération qui conserve encore la donnée. Inversement, effacer un vecteur ne prouve pas qu'une copie n'existe plus dans un prompt, un résumé ou les paramètres. Désapprentissage et cycle de vie des données sont liés, mais ne sont pas interchangeables.
Un outil d'audit, pas un certificat juridique
Les auteurs relient K-Bench à des obligations d'effacement telles que l'article 17 du RGPD. Le benchmark n'est pourtant pas une preuve de conformité réglementaire. Il mesure une question technique plus étroite : après une intervention, l'information cible reste-t-elle récupérable par les canaux observés par le banc d'essai ?
Pour une organisation, cette distinction est essentielle. L'ouverture des ressources et du protocole statistique permet la réplication, et la métrique pénalise les méthodes qui réussissent simplement en cassant l'agent. Mais le travail reste un prépublication, la validation en format réaliste est limitée et l'observateur ne tente pas de reconstituer un secret à partir de fragments répartis entre plusieurs canaux.
La conclusion utile n'est donc pas « le désapprentissage ne fonctionne pas ». Elle est plus précise : le désapprentissage ne peut pas être évalué indépendamment de l'architecture agentique qui entoure le modèle.
Si un agent peut retrouver, transformer ou transmettre une information supposée oubliée par un autre composant, une réponse finale propre n'est qu'une interface propre. Ce n'est pas la preuve que le système a oublié.