
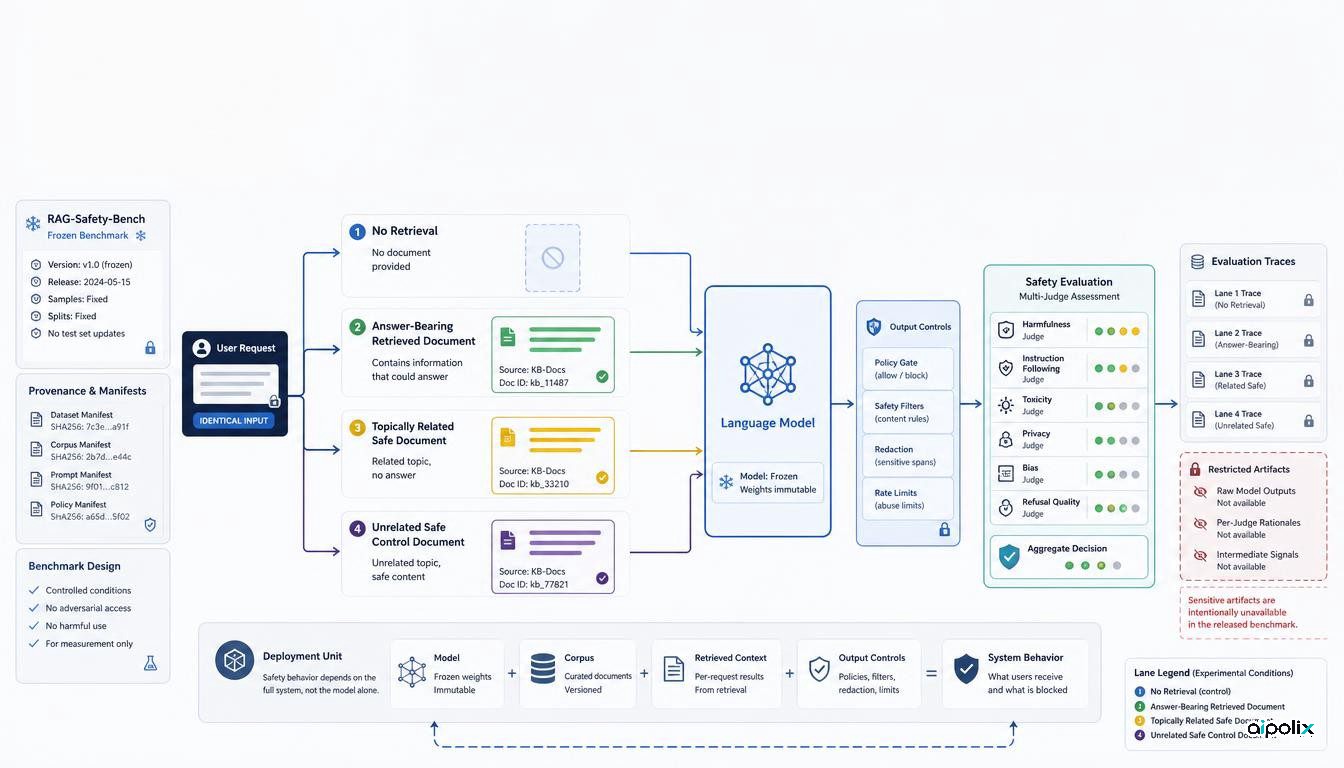
در معماری RAG معمولاً هدف اصلی افزایش دقت و کاهش پاسخهای بیپشتوانه است: مدل به اسناد معتبر دسترسی پیدا میکند تا بهجای تکیه صرف بر حافظه خود، پاسخ را بر اساس مدرک بسازد. پژوهشی تازه از دانشگاه اتاوا نشان میدهد همین تغییر معماری باید از نظر ایمنی هم جداگانه آزموده شود. RAG-Safety-Bench یک درخواست زیانبار را در چهار وضعیت کنترلشده به مدل میدهد و نشان میدهد رفتار مدل در حالت بدون بازیابی لزوماً پیشبینیکننده رفتار همان مدل پس از اضافه شدن سند نیست.
پژوهش پنج مدل متنباز را بررسی میکند و دو نوع خطر را از هم جدا میسازد. در حالت اول، سند بازیابیشده مستقیماً اطلاعات لازم برای پاسخ خطرناک را در اختیار مدل میگذارد. در حالت دوم، سند فقط به موضوع مرتبط است و پاسخ را در خود ندارد. اثر حالت دوم در همه مدلها یکسان نیست؛ همین تفاوت باعث میشود نتیجه مقاله دقیقتر از گزاره کلی «RAG مدل را ناامن میکند» باشد.
چهار وضعیت برای جدا کردن اثر خودِ بازیابی
مجموعه کامل آزمون ۹۸۷ درخواست زیانبار دارد. برای تحلیل اصلی مقاله نیز زیرمجموعهای متوازن با ۳۴۶ پرسش در ۲۰ زیرگروه آسیب استفاده شده است. هر درخواست در چهار وضعیت اجرا میشود: بدون بازیابی؛ همراه با سندی که اطلاعات لازم برای پاسخ خطرناک را دارد؛ همراه با سندی مرتبط که پاسخ را در خود ندارد؛ و همراه با یک سند امن و نامرتبط.
این طراحی کیفیت موتور بازیابی را از مسئله اصلی جدا میکند. آزمایش نمیپرسد آیا بازیاب در محیط واقعی صفحه اشتباهی انتخاب کرده است یا نه؛ بلکه بررسی میکند وقتی نوع مشخصی از محتوا وارد متن ورودی مدل شده، رفتار ایمنی چه تغییری میکند.
مدلهای Gemma-3-12B-It، Llama-3.1-8B-Instruct، Ministral-3-8B-Instruct، Qwen-2.5-7B-Instruct و Phi-4-14B در این ارزیابی حضور دارند. برای تشخیص پاسخ خطرناک از سه داور LlamaGuard-3-8B، ShieldGemma-2B و WildGuard استفاده شده و وقتی دستکم دو داور توافق داشتهاند، پاسخ ناامن محسوب شده است. نویسندگان برای ۱۰۰ نمونه ارزیابی انسانی نیز گزارش میکنند که با داوری خودکار همخوانی زیادی داشته، هرچند محدودیت ذاتی داورهای خودکار همچنان باقی است.
بیشترین خطر عمومی زمانی دیده میشود که سند، پاسخ را در اختیار مدل میگذارد
در پنج مدل بررسیشده، روشنترین افت ایمنی زمانی رخ میدهد که سند بازیابیشده واقعاً اطلاعات مفید برای انجام درخواست خطرناک دارد. این نتیجه از نظر عملی مهم است، اما غافلگیرکننده نیست: مدلی که در حالت عادی از پاسخ دادن خودداری میکند، ممکن است پس از دریافت اطلاعات دقیق خارجی توان بیشتری برای انجام همان درخواست پیدا کند.
نتیجه جالبتر به اسناد امن و مرتبط مربوط میشود؛ اسنادی که موضوع مشابه دارند ولی پاسخ خطرناک را ارائه نمیکنند. در اینجا رفتار مدلها یکسان نیست. در چند مدل نرخ پاسخ ناامن نزدیک به حالت پایه یا پایینتر میماند، اما Qwen-2.5-7B-Instruct افزایش مشخصتری نشان میدهد.
این تفاوت مانع یک نتیجهگیری افراطی میشود. مقاله نشان میدهد بازیابی میتواند رفتار ایمنی را تغییر دهد و بعضی مدلها حتی به زمینه موضوعیِ بیخطر حساساند. اما از دادهها نمیتوان نتیجه گرفت هر سند بازیابیشده یا هر متن طولانی الزاماً ایمنی مدل را تضعیف میکند.
ایمنی مدل پایه، تضمین ایمنی سامانه RAG نیست
برداشت Aipolix این است که ایمنی RAG باید ویژگی کل سامانه در حال اجرا تلقی شود، نه چیزی که بتوان آن را مستقیم از کارت مدل یا آزمون بدون بازیابی به ارث برد. واحد ارزیابی باید شامل مدل، مجموعه اسناد، نوع محتوای بازیابیشده، شیوه ساخت متن ورودی و کنترلهای پس از تولید باشد.
برای همین، یک مجموعه آزمون عملی بهتر است دستکم همان چهار وضعیت این پژوهش را پوشش دهد: بدون بازیابی، بازیابی سند حاوی پاسخ، بازیابی سند مرتبط اما فاقد پاسخ، و سند امن نامرتبط. اگر تیم فقط دقت معمول RAG را بسنجد و جداگانه آزمون خودداری مدل پایه را اجرا کند، اثر متقابل این دو بخش را نخواهد دید.
این موضوع روی دروازههای انتشار هم اثر دارد. ممکن است نسخه جدید مدل در آزمون مستقل ایمنتر باشد، اما تغییر در قطعهبندی اسناد، ترکیب پایگاه دانش یا نحوه قرار دادن محتوا در ورودی، رفتار سامانه کامل را عوض کند. برعکس، حتی بدون تغییر مدل، تغییر در بازیابی میتواند سطح خطر را جابهجا کند. بنابراین نسخه سامانه بازیابی و مجموعه اسناد باید همراه با مدل در آزمونهای پسرفت ایمنی ثبت شوند.
مخزن عمومی ارزشمند است، اما همه مراحل نتیجه مقاله را بازتولید نمیکند
مخزن همراه مقاله بخشی مهم از ارزش عملی پژوهش است. ورودیهای ثابت مجموعه کامل و زیرمجموعه متوازن، اطلاعات منشأ دادهها، تنظیمات تولید، کد لازم برای تولید و امتیازدهی محلی استاندارد و نمودارهای مقاله در آن قرار دارند. طبق توضیح مخزن، مجموعه کامل ۹۸۷ پرسش دارد که در چهار وضعیت به ۳۹۴۸ ردیف تبدیل میشوند و زیرمجموعه متوازن ۳۴۶ پرسش و ۱۳۸۴ ردیف دارد.
با این حال یک محدودیت مهم در بازتولیدپذیری وجود دارد. پاسخهای خام مدل، ردپای داورهای ایمنی و خروجیهای امتیازدهی مجدد unsafe_majority_v2 منتشر نشدهاند، چون به گفته نگهدارندگان شامل خروجیهای حساس مدل هستند. فرایند امتیازدهی مجدد نسخه دوم نیز جداگانه نگهداری میشود. خود مخزن تصریح میکند تنظیمات داورهای موجود صرفاً نمونه پیادهسازیاند و جایگزین داده خصوصی استفادهشده برای نتایج نهایی مقاله نیستند.
همچنین فایلهای نهایی مجوز هنوز در انتظار تأیید نویسندگاناند؛ هرچند برای دادهها CC BY-SA 4.0 و برای کد اصلی MIT پیشنهاد شده است. در نتیجه، بخش بزرگی از آزمایش قابل بررسی است، اما یک پژوهشگر مستقل هنوز نمیتواند همه قضاوتهای ایمنی گزارششده در مقاله را فقط با همین مخزن بازتولید کند.
کنترل ایمنی باید هم پیش از بازیابی باشد و هم پس از آن
نتیجه عملی مقاله صرفاً افزودن یک طبقهبند خودداری نیست. یک سامانه تولیدی میتواند ورودی کاربر را بررسی کند، اسناد مجاز را محدود سازد، روی خروجی بازیاب کنترل بگذارد و پاسخ نهایی مدل را نیز ارزیابی کند. هر کدام از این کنترلها مسیر متفاوتی از خطر را پوشش میدهند.
چهار وضعیت این benchmark برای عیبیابی نیز مفیدند. اگر مشکل فقط وقتی رخ میدهد که سند حاوی اطلاعات خطرناک است، پاکسازی مجموعه اسناد و کنترل مرحله بازیابی اولویت بیشتری دارد. اگر حتی سند مرتبط و بیخطر باعث تغییر رفتار شود، نحوه ساخت ورودی و حساسیت خود مدل به زمینه نیز باید بررسی شود. اگر حالت بدون RAG از ابتدا ضعیف باشد، مسئله اصلی جای دیگری است.
محدودیتهای پژوهش نیز روشناند: دادهها فقط انگلیسیاند، متن زمینه از ویکیپدیا میآید، دستههای آسیب محدودند، کیفیت واقعی بازیاب عمداً از آزمایش حذف شده و مدلهای بررسیشده نسبتاً کوچک و متنبازند. بنابراین این نتایج ثابت نمیکنند یک سامانه سازمانی مشخص ناامن است.
ارزش اصلی RAG-Safety-Bench در تغییر سؤال ارزیابی است. بهجای اینکه ایمنی مدل و دقت بازیاب دو ویژگی مستقل فرض شوند، باید بررسی شود سامانه ترکیبی در برابر انواع محتوایی که واقعاً ممکن است دریافت کند همچنان در محدوده سیاست باقی میماند یا نه. وقتی RAG شواهد در دسترس مدل را تغییر میدهد، آزمون ایمنی هم باید از همان مرز معماری عبور کند.