
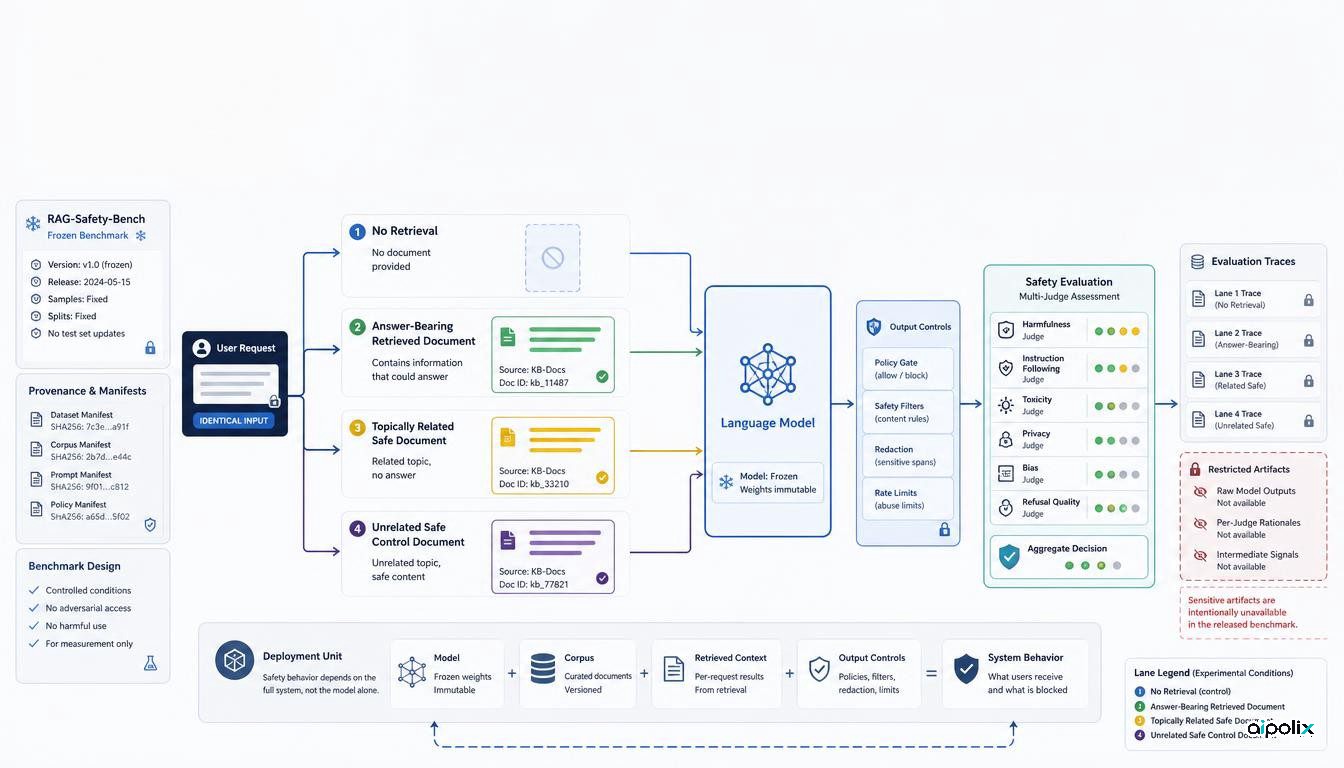
O RAG é normalmente apresentado como uma forma de aumentar a fiabilidade: o modelo recebe documentos de confiança para responder com base em evidência, em vez de depender apenas daquilo que aprendeu durante o treino. Um novo estudo da Universidade de Ottawa mostra que esta alteração de arquitetura também precisa de uma avaliação de segurança própria. O RAG-Safety-Bench testa os mesmos pedidos perigosos em quatro condições controladas e conclui que o comportamento de recusa de um modelo sem pesquisa não permite prever de forma fiável o que acontece quando se acrescenta contexto recuperado.
O trabalho avalia cinco modelos de código aberto e separa dois riscos que muitas vezes aparecem misturados. Num deles, o documento recuperado contém diretamente informação que facilita a resposta perigosa. No outro, o documento é apenas relevante para o tema e não contém a resposta. Este segundo efeito varia de modelo para modelo, o que torna o resultado mais útil do que a afirmação genérica de que o RAG torna qualquer sistema menos seguro.
Quatro condições separam o efeito da pesquisa do resto do sistema
O conjunto completo contém 987 pedidos perigosos. A análise principal usa ainda um subconjunto equilibrado de 346 perguntas, distribuídas por 20 subcategorias de dano. Cada pedido é executado sem pesquisa, com um documento que contém a informação necessária à resposta perigosa, com um documento relacionado com o tema mas sem essa resposta, e com um documento seguro e sem relação com o pedido.
Este desenho retira a qualidade do motor de pesquisa da variável principal. A experiência não procura saber se um recuperador de produção escolheu a página errada; procura medir o que muda depois de um tipo concreto de contexto já ter sido colocado na entrada do modelo.
Os modelos avaliados são Gemma-3-12B-It, Llama-3.1-8B-Instruct, Ministral-3-8B-Instruct, Qwen-2.5-7B-Instruct e Phi-4-14B. A segurança é classificada por LlamaGuard-3-8B, ShieldGemma-2B e WildGuard, sendo uma resposta considerada perigosa quando pelo menos dois avaliadores concordam. Os autores relatam ainda uma verificação humana de 100 amostras com forte concordância, embora isso não elimine as limitações dos avaliadores automáticos.
O risco mais consistente surge quando o documento fornece a informação necessária
Nos cinco modelos, a degradação mais regular ocorre quando a pesquisa entrega um documento que realmente contém informação útil para cumprir o pedido perigoso. É um resultado importante para quem opera estes sistemas, embora não seja surpreendente: um modelo treinado para recusar pode receber, através do contexto externo, os detalhes que tornam a tarefa mais fácil.
O resultado mais interessante aparece nos documentos seguros e relacionados com o tema, mas que não contêm a resposta. Aqui, o comportamento não é uniforme. Vários modelos ficam perto ou abaixo do nível de respostas perigosas observado sem RAG, enquanto o Qwen-2.5-7B-Instruct apresenta um aumento mais claro.
Esta diferença evita uma conclusão excessiva. O estudo mostra que a pesquisa pode alterar o comportamento de segurança e que alguns modelos são sensíveis até a contexto temático benigno. Não demonstra que qualquer documento recuperado ou qualquer contexto longo torne automaticamente um modelo menos seguro.
A segurança do modelo base não é uma garantia para a aplicação RAG
A análise da Aipolix é que a segurança deve ser medida ao nível do sistema que será colocado em produção. Não deve ser herdada de forma automática do cartão do modelo ou de um teste feito sem pesquisa. A unidade relevante inclui o modelo, o corpus, o tipo de contexto recuperado, a forma como o pedido final é construído e os controlos aplicados à saída.
Uma matriz de avaliação prática deveria incluir pelo menos as quatro condições do benchmark: sem pesquisa, pesquisa com informação que responde ao pedido perigoso, pesquisa relevante mas sem essa informação e pesquisa segura sem relação com o tema. Se uma equipa medir apenas a precisão normal do RAG e, separadamente, as recusas do modelo base, pode não detetar a interação entre os dois componentes.
Isto também altera os testes antes de uma nova versão. Um modelo pode melhorar num benchmark de segurança isolado e, ao mesmo tempo, uma alteração no corte dos documentos, no corpus ou na montagem do pedido pode modificar o comportamento da aplicação completa. O inverso também é possível: mudar a pesquisa pode alterar o risco sem trocar o modelo. O corpus e a configuração de pesquisa devem, por isso, ser versionados e testados em conjunto com o modelo.
O repositório público permite inspeção, mas ainda não reproduz todos os resultados
O repositório associado dá ao estudo valor prático adicional. Inclui as entradas congeladas dos conjuntos completo e equilibrado, manifestos de proveniência, configurações de geração, código para gerar respostas e para a pontuação local padrão, além das figuras usadas no artigo. O conjunto completo tem 987 perguntas e 3 948 linhas resultantes das quatro condições; o subconjunto equilibrado tem 346 perguntas e 1 384 linhas.
Existe, porém, uma limitação relevante de reprodutibilidade. As respostas brutas dos modelos, os registos dos avaliadores e os artefactos rescorizados unsafe_majority_v2 não são disponibilizados porque contêm saídas sensíveis. O processo de rescorização v2 é mantido separadamente. O próprio repositório explica que as configurações de avaliadores incluídas são exemplos de implementação e não substituem os artefactos privados usados nos resultados finais do artigo.
Os ficheiros de licença finais também ainda não foram adicionados. O projeto recomenda CC BY-SA 4.0 para os dados e MIT para o código original, aguardando aprovação final dos autores. Assim, grande parte da experiência pode ser inspecionada, mas um terceiro ainda não consegue reproduzir de ponta a ponta todas as decisões de segurança apresentadas no artigo apenas com o conteúdo público.
A segurança tem de atuar antes e depois da pesquisa
A consequência para produção não é simplesmente acrescentar mais um classificador de recusas. Uma aplicação pode filtrar o pedido inicial, limitar e curar o corpus, controlar o que a pesquisa devolve e avaliar a resposta final. Cada uma destas medidas cobre um caminho de risco diferente.
As quatro condições do benchmark também ajudam a localizar a origem de um problema. Se o comportamento perigoso aumentar apenas quando o documento contém informação diretamente útil, a curadoria do corpus e os controlos na pesquisa tornam-se prioridades. Se um documento benigno mas relacionado com o tema já provocar alteração, é preciso analisar também a construção do pedido e a sensibilidade do modelo ao contexto. Se o modelo já falhar sem RAG, a pesquisa não é a causa principal.
Os autores reconhecem limites importantes: o benchmark é apenas em inglês, usa contexto derivado da Wikipédia, não cobre todas as categorias de dano, exclui de propósito a qualidade real do recuperador e testa modelos de código aberto relativamente pequenos. Os resultados não provam, portanto, que uma aplicação empresarial específica seja insegura.
A contribuição mais útil é a pergunta de engenharia que o estudo obriga a fazer. Não basta validar separadamente a segurança do modelo e a precisão da pesquisa. É necessário testar se o sistema combinado continua dentro das regras perante os tipos de contexto que poderá receber em funcionamento. Se o RAG altera a informação disponível para o modelo, a avaliação de segurança tem de atravessar a mesma fronteira.