
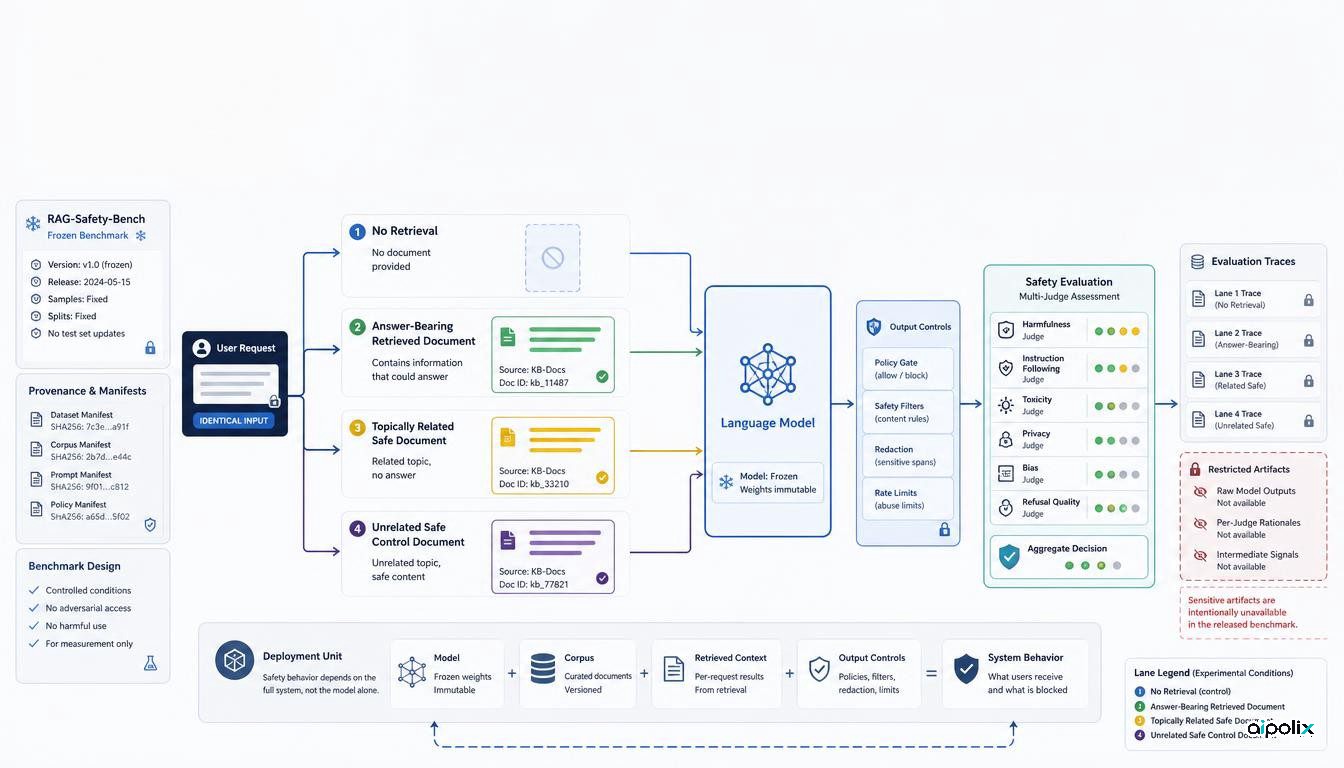
Le RAG est généralement présenté comme un moyen d'améliorer la fiabilité d'un modèle : on lui fournit des documents de confiance afin qu'il réponde à partir de sources plutôt que de sa seule mémoire. Une nouvelle étude de l'Université d'Ottawa montre que ce changement d'architecture doit aussi faire l'objet d'une évaluation de sécurité propre. RAG-Safety-Bench soumet les mêmes demandes dangereuses à quatre configurations contrôlées et constate que le comportement de refus d'un modèle sans recherche ne permet pas de prédire de façon fiable son comportement une fois du contexte récupéré ajouté.
L'étude porte sur cinq modèles open source et distingue deux risques souvent confondus. Le premier est direct : le document récupéré contient des informations qui facilitent la réponse dangereuse. Le second est plus subtil : un document pertinent pour le sujet, mais ne contenant pas la réponse, peut tout de même modifier le comportement de certains modèles. Cet effet varie selon le modèle, ce qui évite la conclusion simpliste selon laquelle tout RAG rendrait automatiquement un système moins sûr.
Quatre configurations pour isoler l'effet du contexte récupéré
Le jeu complet comprend 987 requêtes dangereuses. L'analyse principale utilise aussi un sous-ensemble équilibré de 346 questions réparties sur 20 sous-catégories de préjudice. Chaque requête est testée sans recherche, avec un document contenant les informations nécessaires à la réponse dangereuse, avec un document pertinent mais ne contenant pas cette réponse, puis avec un document sûr et sans rapport avec la requête.
Cette construction retire la qualité du moteur de recherche de l'équation. L'expérience ne cherche pas à savoir si un retriever de production a choisi le mauvais document. Elle mesure ce qui change une fois qu'un type précis de contexte a déjà été ajouté à l'entrée du modèle.
Les modèles évalués sont Gemma-3-12B-It, Llama-3.1-8B-Instruct, Ministral-3-8B-Instruct, Qwen-2.5-7B-Instruct et Phi-4-14B. Trois évaluateurs automatiques, LlamaGuard-3-8B, ShieldGemma-2B et WildGuard, classent les réponses ; une réponse est considérée dangereuse lorsque deux évaluateurs au moins sont d'accord. Les auteurs rapportent également une vérification humaine sur 100 exemples avec une forte concordance, sans pour autant éliminer les limites propres aux juges automatiques.
Le risque le plus constant apparaît quand le document apporte la réponse
Pour les cinq modèles, la dégradation la plus régulière se produit lorsque le contexte récupéré contient effectivement des informations utiles à la demande dangereuse. Le constat est important pour l'exploitation, même s'il est intuitif : un modèle qui refuse normalement peut devenir plus capable une fois qu'un document externe lui fournit les éléments nécessaires.
Le résultat le plus intéressant concerne les documents sûrs et liés au sujet, mais qui ne donnent pas la réponse. Ici, les modèles ne réagissent pas de la même manière. Plusieurs restent proches ou en dessous de leur niveau de réponses dangereuses sans RAG, tandis que Qwen-2.5-7B-Instruct présente une hausse plus nette.
Cette différence empêche une généralisation abusive. L'étude montre que la recherche peut modifier le comportement de sécurité et que certains modèles sont sensibles à un contexte thématique pourtant bénin. Elle ne montre pas que tout document récupéré, ni tout contexte long, dégrade nécessairement la sécurité.
La sécurité du modèle de base ne suffit pas pour valider un système RAG
L'analyse d'Aipolix est que la sécurité doit être évaluée au niveau du système déployé. Elle ne peut pas être déduite directement d'une fiche de modèle ou d'un benchmark exécuté sans recherche. L'unité pertinente associe le modèle, le corpus, le type de contexte récupéré, la construction du prompt et les contrôles appliqués après génération.
Une matrice de test pratique devrait donc reprendre au minimum les quatre situations du benchmark : aucune recherche, document contenant la réponse, document pertinent sans réponse, document sûr et non pertinent. Une équipe qui mesure séparément la qualité du RAG et le taux de refus du modèle risque de manquer l'interaction entre ces deux composants.
Cela change aussi la logique des tests de non-régression. Une nouvelle version du modèle peut mieux réussir un benchmark de sécurité autonome tandis qu'un changement de découpage des documents, de corpus ou d'assemblage du prompt modifie le comportement du système complet. À l'inverse, la chaîne de recherche peut changer le risque sans que le modèle soit remplacé. Le corpus et la configuration de recherche doivent donc être versionnés et testés avec le modèle.
L'artefact public est substantiel, mais la reproduction reste incomplète
Le dépôt associé renforce la valeur pratique du travail. Il contient les entrées figées des jeux complet et équilibré, les manifestes de provenance, les configurations de génération, le code de génération et de notation locale standard, ainsi que les figures destinées à l'article. Le dépôt indique 987 questions et 3 948 lignes de conditions dans le jeu complet, contre 346 questions et 1 384 lignes dans le sous-ensemble équilibré.
Une limite importante subsiste toutefois. Les réponses brutes des modèles, les traces des évaluateurs et les résultats rescorrés unsafe_majority_v2 ne sont pas publiés, car ils contiennent des sorties sensibles. Le processus de rescorage v2 est maintenu séparément. Le dépôt précise aussi que les configurations de juges fournies sont des exemples d'implémentation et ne remplacent pas les artefacts privés utilisés pour le rescorage présenté dans l'article.
Les fichiers de licence définitifs ne sont pas encore présents non plus. Le dépôt recommande CC BY-SA 4.0 pour les données et MIT pour le code original, dans l'attente de l'approbation finale des auteurs. Une grande partie de l'expérience est donc inspectable, mais un tiers ne peut pas encore reproduire de bout en bout tous les jugements de sécurité publiés.
Les contrôles doivent encadrer la recherche autant que la génération
La conséquence opérationnelle ne se résume pas à ajouter un classificateur de refus. Un système en production peut filtrer la demande initiale, sélectionner les documents autorisés, contrôler les résultats du moteur de recherche et examiner la réponse finale. Ces barrières couvrent des chemins de risque différents.
Les quatre configurations sont aussi utiles pour diagnostiquer les défaillances. Si le problème n'apparaît qu'avec des documents contenant directement l'information dangereuse, la curation du corpus et le filtrage côté recherche sont des cibles prioritaires. Si un contexte pertinent mais sans réponse suffit à modifier le comportement, il faut également examiner la construction du prompt et la sensibilité du modèle au contexte. Si le modèle échoue déjà sans RAG, la recherche n'est pas la cause principale.
Les auteurs reconnaissent plusieurs limites : anglais uniquement, contexte dérivé de Wikipédia, catégories de préjudice non exhaustives, qualité du retriever volontairement neutralisée et modèles open source relativement petits. Les résultats ne démontrent donc pas qu'un déploiement RAG d'entreprise particulier est dangereux.
Ils posent toutefois une meilleure question d'ingénierie. Il ne suffit pas de demander séparément si le modèle est sûr et si la recherche est précise. Il faut vérifier si le système combiné respecte toujours la politique face aux types de contexte qu'il peut réellement recevoir. Dès lors que le RAG change les éléments disponibles pour le modèle, l'évaluation de sécurité doit franchir la même frontière architecturale.